RDMA e InfiniBand: Guia Estratégico para Redes de IA 2026
RDMA (Remote Direct Memory Access) e InfiniBand deixaram de ser temas restritos a laboratórios de supercomputação. Em 2026, a rede que conecta as GPUs define quanto do investimento em aceleradores se converte em trabalho útil. Em um cluster de treinamento de IA, cada microssegundo perdido em sincronização de gradientes é capacidade computacional paga e ociosa.
O cenário, porém, ficou mais complexo. Segundo o Dell’Oro Group, a InfiniBand detinha mais de 80% do mercado de redes back-end de IA no fim de 2023. Em 2025, o Ethernet a ultrapassou, e no primeiro trimestre de 2026 respondeu por cerca de dois terços das vendas de switches nesse segmento. Ao mesmo tempo, as vendas de InfiniBand mais que triplicaram no mesmo trimestre, puxadas pelos switches de 800 Gbps da plataforma NVIDIA Blackwell Ultra.
Esse movimento duplo cria um risco real para quem decide a arquitetura: escolher por inércia, seja pelo hábito da InfiniBand, seja pela promessa do Ethernet aberto, pode gerar clusters subutilizados, custos de energia elevados e dependência tecnológica difícil de reverter. Este artigo analisa o problema estratégico, os fundamentos técnicos do RDMA sobre InfiniBand, a concorrência do RoCEv2 e do Ultra Ethernet, as práticas de implementação e as métricas que provam o retorno do investimento.
O problema estratégico: a rede como gargalo do investimento em GPUs
Por que o treinamento distribuído é limitado pela comunicação
Treinar um modelo grande exige dezenas, centenas ou milhares de GPUs trabalhando de forma síncrona. A cada passo de treinamento, essas GPUs precisam trocar e combinar dados por meio de operações coletivas como o AllReduce. Enquanto a comunicação não termina, o cálculo seguinte espera.
Isso significa que a eficiência de um cluster não depende só da potência de cada GPU, mas da latência e da vazão da rede, e principalmente da latência de cauda: basta um fluxo atrasado para segurar todas as GPUs do job. Por isso o Dell’Oro define a rede back-end como uma infraestrutura dedicada, distinta da rede front-end que conecta servidores de uso geral.
O tamanho da aposta em 2026
O peso econômico dessa camada já é medível. O Dell’Oro registrou, no segundo trimestre de 2026, que as vendas de switches para redes back-end de IA superaram pela primeira vez as de redes front-end, e avalia que o mercado seguirá limitado por oferta, e não por demanda, por pelo menos um a dois anos. Para o gestor de infraestrutura, isso se traduz em prazos de entrega longos e menor poder de barganha para quem decide tarde.
Consequências da inação ou da escolha inadequada
Custos de oportunidade em ciclos de treinamento
Uma rede subdimensionada ou mal configurada não falha de forma visível; ela degrada o desempenho silenciosamente. GPUs permanecem ocupadas em estado de espera, jobs levam mais tempo e o custo por experimento aumenta. Em ambientes de nuvem de GPU cobrados por hora, essa ineficiência vira despesa direta.
Riscos de energia e de escala
A energia também entra na conta. Em testes divulgados pela Lambda em 2026 com o switch de óptica co-empacotada NVIDIA Quantum-X Photonics Q3450-LD, a rede back-end aparece como responsável por 86% da energia de rede em um cluster de três camadas, e a comparação apresentada indica 3,95 kW para o switch fotônico contra 7,0 kW para uma solução convencional equivalente. Racks de GPU já operam acima de 100 kW, e cada quilowatt consumido pela rede é um quilowatt a menos para computação.
Desvantagem competitiva e lock-in
Há ainda o risco de dependência. A InfiniBand é um ecossistema majoritariamente de fornecedor único, com cabeamento, gerenciamento e software próprios. O Ethernet oferece múltiplos fornecedores, mas exige engenharia cuidadosa para atingir comportamento sem perdas. Decidir sem avaliar esse trade-off pode resultar em um cluster difícil de expandir ou de migrar.
Fundamentos da solução: RDMA, GPUDirect e InfiniBand
O que o RDMA muda na comunicação
O RDMA permite que a placa de rede leia ou escreva diretamente na memória de outro servidor, sem passar pelo kernel e sem consumir ciclos da CPU em cópias de dados. O resultado é menor latência, maior vazão e CPU livre para a aplicação. Em redes tradicionais, a pilha TCP/IP processa cada pacote em software; no RDMA, o transporte é descarregado para o hardware da placa.
Para cargas de IA, o complemento essencial é o GPUDirect RDMA. Sem ele, os dados saem da memória da GPU, passam pela memória do sistema e só então chegam à placa de rede. Com ele, a placa de rede acessa a memória da GPU por peer-to-peer via PCIe, eliminando a etapa intermediária e o tráfego PCIe extra.
Por que a InfiniBand foi projetada para isso
A InfiniBand nasceu com RDMA como premissa. Seu controle de fluxo é baseado em créditos, o que a torna nativamente sem perdas no nível do enlace: o remetente só transmite quando o receptor tem espaço. O Ethernet, historicamente, opera em regime de melhor esforço e descarta pacotes quando as filas enchem, o que exige mecanismos adicionais como PFC para proteger o tráfego RDMA.
Além disso, a InfiniBand funciona como um fabric gerenciado centralmente por um Subnet Manager, que conhece a topologia e calcula as rotas. Essa visão unificada facilita roteamento adaptativo, isolamento e diagnóstico, características valiosas em clusters grandes.
Computação em rede com SHARP
O diferencial técnico mais citado da InfiniBand é o SHARP (Scalable Hierarchical Aggregation and Reduction Protocol), que transfere parte das operações de redução para os próprios switches. Em vez de cada GPU receber dados de todas as outras para somá-los, a rede agrega os resultados parciais no caminho. A literatura técnica descreve integração do SHARP com a biblioteca NCCL e com GPUDirect RDMA, de modo que frameworks de treinamento podem se beneficiar sem alteração de código.
A geração XDR de 800 Gb/s
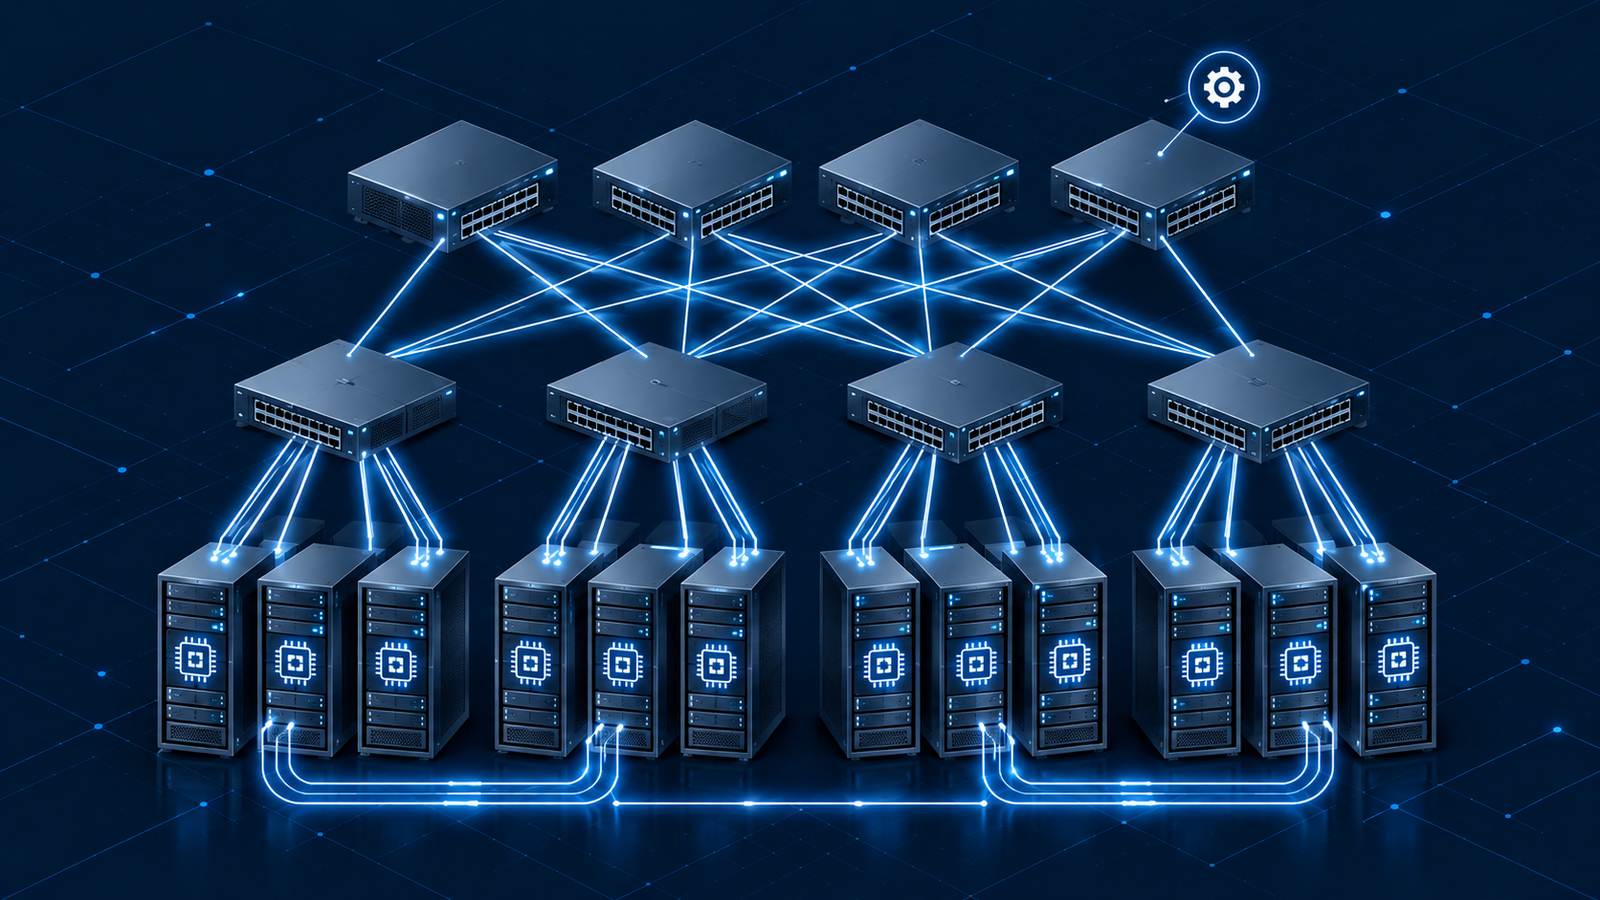
A plataforma atual é a NVIDIA Quantum-X800. Conforme o datasheet oficial, o switch Q3400-RA oferece 144 portas de 800 Gb/s em 72 conectores OSFP, com 115,2 Tb/s de capacidade e SerDes de 200 Gb/s por lane. Sua alta densidade de portas permite uma topologia fat-tree de dois níveis conectando até 10.368 interfaces de rede, e o equipamento incorpora SHARP de quarta geração, roteamento adaptativo, controle de congestionamento baseado em telemetria e recursos de autorrecuperação.
O Q3200-RA, em formato 2U, abriga dois switches independentes de 36 portas de 800 Gb/s cada, voltado a clusters menores e à integração com infraestruturas Quantum e Quantum-2 existentes. O lado do servidor é atendido pela NVIDIA ConnectX-8 SuperNIC, que entrega 800 Gb/s de ponta a ponta entre switch e host. Atenção à compatibilidade: distribuidores e fichas técnicas indicam que o XDR exige novas ópticas e cabeamento, e que o Q3400-RA opera apenas a 400 ou 800 Gb/s por porta.
Implementação estratégica: InfiniBand, RoCEv2 ou Ultra Ethernet
Comparação das três abordagens
A decisão de 2026 não é mais binária. O RoCEv2 leva RDMA ao Ethernet convencional, mas fixa cada fluxo a um único caminho ECMP e depende de PFC e ECN para evitar perdas. O Ultra Ethernet, especificado pelo Ultra Ethernet Consortium, redesenha a camada de transporte com packet spray em múltiplos caminhos, entrega fora de ordem, retransmissão seletiva e controle de congestionamento moderno.
| Critério | InfiniBand (XDR) | RoCEv2 | Ultra Ethernet (UEC 1.0.x) |
|---|---|---|---|
| Natureza | Fabric dedicado, RDMA nativo | RDMA sobre Ethernet existente | Novo transporte aberto sobre Ethernet |
| Controle de perdas | Créditos no enlace | PFC e ECN configurados na rede | Retransmissão seletiva, menor dependência de PFC |
| Balanceamento | Roteamento adaptativo | Hash ECMP por fluxo | Packet spray multipath |
| Computação em rede | SHARP | Dependente do fornecedor | Em evolução |
| Ecossistema | Majoritariamente NVIDIA | Multifornecedor | Multifornecedor, NICs em chegada ao mercado |
Maturidade do Ultra Ethernet
O Ultra Ethernet Consortium publicou a especificação 1.0 em 11 de junho de 2025. Desde então vieram revisões editoriais e correções, e a versão 1.0.3, de 16 de julho de 2026, é a publicada atualmente. Fundado por AMD, Arista, Broadcom, Cisco, Eviden, HPE, Intel, Meta e Microsoft, o consórcio busca uma pilha completa e interoperável, mas a adoção em produção ainda depende da disponibilidade de NICs compatíveis. Hoje, a maior parte dos clusters Ethernet em produção usa RoCEv2.
O que os dados do mercado indicam
No Dell’Oro, o Ethernet estendeu sua liderança também no segundo trimestre de 2026. Em paralelo, a NVIDIA vende nos dois campos: segundo o IDC, sua receita com switches Ethernet de data center chegou a US$ 2,1 bilhões no primeiro trimestre de 2026, impulsionada pelo Spectrum-X. Isso mostra que a pergunta relevante para o comprador não é “qual protocolo vencerá”, mas “qual combinação atende à minha escala, ao meu fornecedor de GPU e à minha equipe”.
No segmento de supercomputação, o quadro também é misto. Na lista TOP500 de junho de 2026, a interconexão Slingshot, da HPE, tornou-se pela primeira vez a mais comum, enquanto a InfiniBand NDR400 foi a que mais cresceu, de 35 para 48 sistemas.
Critérios práticos de decisão
Em linhas gerais, a InfiniBand tende a fazer mais sentido quando o cluster é construído sobre plataformas NVIDIA, a prioridade é desempenho previsível em treinamento de grande escala e a equipe aceita um ecossistema mais fechado em troca de integração. Ethernet com RoCEv2 ou, futuramente, Ultra Ethernet, tende a ser preferível quando há exigência de multifornecedor, reaproveitamento de competências de rede e integração com a malha front-end. Em ambos os casos, a validação com cargas reais antes da compra é indispensável.
Melhores práticas avançadas
Projeto de topologia e roteamento
Topologias fat-tree não bloqueantes continuam sendo o ponto de partida para clusters de IA. Uma prática comum é a arquitetura rail-optimized, em que a placa de rede de mesmo índice de cada servidor se conecta ao mesmo switch folha, reduzindo saltos nas operações coletivas. A escolha entre Q3400-RA e Q3200-RA deve considerar o número de NICs previsto e a margem de crescimento do fabric em dois níveis.
Ópticas, energia e óptica co-empacotada
Ópticas pluggáveis de 800G representam parcela relevante de custo, energia e pontos de falha. A óptica co-empacotada (CPO) integra a conversão eletro-óptica ao pacote do ASIC. Segundo a Lambda, isso reduz a perda de sinal elétrico de cerca de 20 dB para 4 dB. A NVIDIA indica eficiência energética 3,5 vezes superior por porta e disponibilidade comercial dos switches Quantum-X em 2026, com CoreWeave, Lambda e TACC entre os primeiros clientes. Trata-se de dados do fabricante e de early adopters: valide com projetos-piloto antes de generalizar.
Governança, segurança e operação
Em ambientes multi-inquilino, o isolamento de tráfego por partições do fabric e a segmentação do acesso à plataforma de gerenciamento (UFM, no caso da NVIDIA) são controles básicos. Também é importante tratar o fabric de IA como ativo crítico: inventário de firmware, janelas de atualização, telemetria contínua e plano de contingência para falha de enlaces, já que um único enlace degradado pode afetar o job inteiro.
Erros frequentes de implementação
Entre os pontos de falha mais comuns estão cabeamento e ópticas incompatíveis com a geração adquirida, configuração incompleta de PFC e ECN em fabrics RoCEv2, subestimação da potência por rack e ausência de testes de colectivas (como NCCL) em escala antes da entrada em produção. Cada um deles é evitável com validação em bancada e critérios de aceite documentados.
Medição de sucesso: métricas e KPIs
Indicadores técnicos
Os indicadores mais reveladores medem o comportamento das operações coletivas, não apenas a velocidade nominal do enlace. Entre eles estão a largura de banda efetiva do AllReduce e do AllToAll comparada ao teto teórico, a latência de cauda (percentis altos) das mensagens, a taxa de retransmissões ou pausas de fluxo, e a utilização de enlaces distribuída entre caminhos. Esses números indicam se há hot spots ou desbalanceamento antes que o desempenho do job seja afetado.
Indicadores de negócio
Do lado da gestão, os KPIs relevantes são a utilização efetiva das GPUs (parcela do tempo em cálculo versus espera por comunicação), o tempo para concluir um ciclo de treinamento, o custo por experimento e o consumo de energia por unidade de trabalho. A premissa da própria Lambda ao avaliar CPO é a de tokens por watt: quanto mais energia sobra para GPUs, mais trabalho útil o mesmo data center entrega.
Como estruturar a avaliação
Recomenda-se estabelecer uma linha de base antes de qualquer mudança, repetir os mesmos testes após cada ajuste e comparar alternativas (InfiniBand, RoCEv2, Ultra Ethernet) com a carga real da organização. Benchmarks de fornecedores são ponto de partida; a decisão deve repousar em medições próprias.
Conclusão: uma decisão de arquitetura, não de protocolo
RDMA é o fundamento comum: ele elimina a CPU do caminho dos dados e, com GPUDirect, conecta a memória das GPUs diretamente à rede. A InfiniBand XDR de 800 Gb/s oferece a implementação mais integrada dessa ideia, com SHARP, roteamento adaptativo e gerenciamento unificado. O Ethernet, por sua vez, avançou rapidamente em participação de mercado e ganha novas capacidades com o Ultra Ethernet.
As perspectivas apontam para coexistência. O Dell’Oro projeta portas de 1,6 Tbps como maioria em redes de IA até 2027, e a óptica co-empacotada deve iniciar volume em 2026 tanto na InfiniBand quanto no Ethernet. Para quem planeja um cluster, os próximos passos práticos são: definir a plataforma de GPU e a escala-alvo; mapear requisitos de energia e refrigeração; comparar as alternativas com cargas reais; e negociar prazos de entrega considerando o mercado limitado por oferta.