Benchmark H200 vs H100: Guia Técnico para Inferência 2026
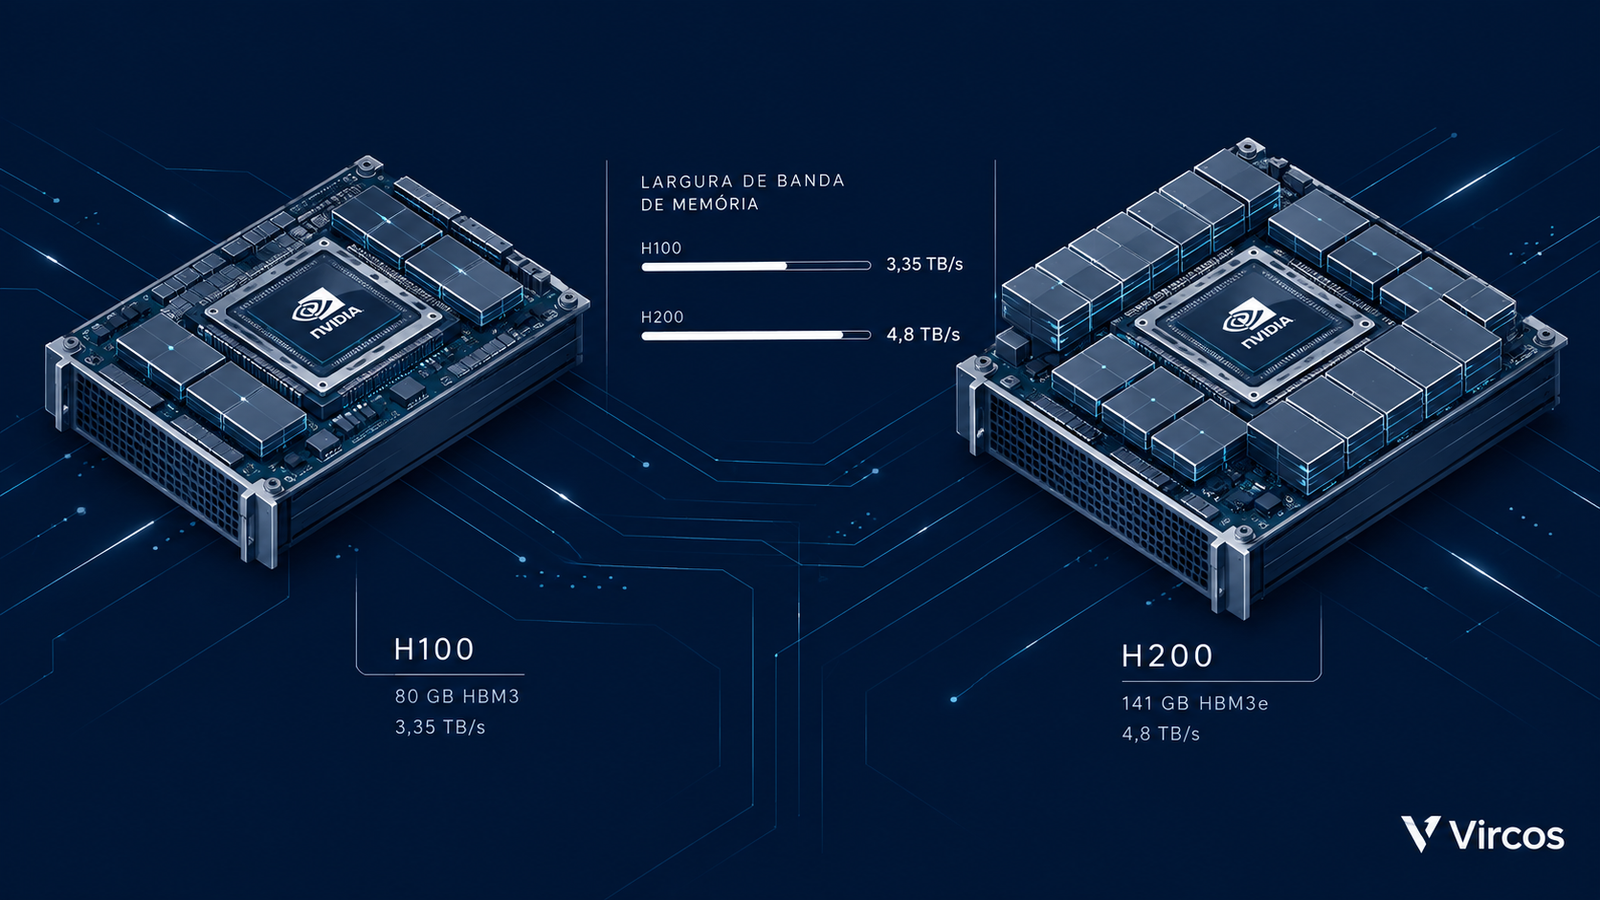
Em 2026, escolher entre a NVIDIA H200 e a H100 deixou de ser uma decisão sobre qual GPU é mais recente. Passou a ser uma decisão sobre qual gargalo a sua carga de trabalho realmente enfrenta. As duas pertencem à arquitetura Hopper, compartilham o mesmo desempenho de pico de computação e operam no mesmo perfil de potência. A diferença está na memória: 141 GB de HBM3e a 4,8 TB/s no H200, contra 80 GB de HBM3 a 3,35 TB/s no H100.
Esse detalhe de especificação produz resultados de benchmark H200 vs H100 muito díspares. Dependendo do modelo, do tamanho de lote e do comprimento de contexto, o ganho medido vai de quase nulo a perto do dobro de throughput. Quem decide apenas pelo número de marketing arrisca pagar por um ganho que não vai se materializar.
O risco inverso também é real. Organizações que mantêm o H100 por inércia podem operar com custo por token mais alto e com limites artificiais de lote e de contexto, justamente nas cargas em que a memória é o fator limitante.
Este artigo consolida resultados do MLPerf, testes independentes, um estudo acadêmico de 2026 e dados de preço do segundo semestre de 2026. O objetivo é responder quando o H200 se paga, quando o H100 continua sendo a melhor escolha e como validar isso na sua própria infraestrutura.
O problema estratégico: decidir por especificação de pico em vez de por gargalo
A maioria das comparações entre GPUs começa pela tabela de TFLOPS. Nesse critério, H100 e H200 são indistinguíveis. Segundo o datasheet da NVIDIA e as análises da Spheron e da Emma, o desempenho de pico do H200 SXM é idêntico ao do H100 SXM, assim como a velocidade do NVLink e o consumo de energia.
Quem para nessa linha da tabela conclui, erradamente, que as duas placas são equivalentes. A tabela abaixo mostra onde está a diferença real.
| Especificação (classe SXM) | H100 | H200 | Variação |
|---|---|---|---|
| Arquitetura | Hopper | Hopper | Igual |
| Memória | 80 GB HBM3 | 141 GB HBM3e | +76% |
| Largura de banda de memória | 3,35 TB/s | 4,8 TB/s | +43% |
| Pico FP8 (Tensor Core) | 3.958 TFLOPS | 3.958 TFLOPS | Igual |
| Perfil de potência | Até 700 W | Até 700 W | Igual |
Por que a memória define o resultado em LLMs
Na fase de decodificação de um modelo de linguagem, cada token gerado exige ler da memória da GPU os pesos do modelo e o KV cache. Esse padrão é limitado pela largura de banda, e não pelo poder de cálculo. Uma GPU com a mesma capacidade de computação, mas com mais banda, gera mais tokens por segundo.
A capacidade importa por outro motivo: ela define quanto espaço sobra para o KV cache depois de carregar os pesos. Em um cálculo ilustrativo, um modelo de 70 bilhões de parâmetros em FP8 ocupa cerca de 70 GB só de pesos. No H100 de 80 GB sobram poucos gigabytes para cache, ativações e overhead do runtime. No H200 de 141 GB sobram mais de 60 GB.
Esse espaço extra se traduz em lotes maiores e contextos mais longos, que por sua vez elevam a utilização da GPU. A vantagem do H200 é, portanto, em boa parte um efeito combinado de banda e de capacidade.
Três perfis de carga, três respostas diferentes
O primeiro perfil é a inferência de modelos de 70B parâmetros ou mais, com lotes grandes ou contexto longo. Aqui o H200 entrega os maiores ganhos, na faixa de 30% a 90% segundo a Emma e a Spheron. O segundo perfil é o de modelos pequenos, que cabem com folga na memória do H100. Para esses casos, a Emma observa ganho quase inexistente.
O terceiro perfil é o de simulação científica e HPC, em que a largura de banda também pesa. A NVIDIA reporta, em seu datasheet, ganho de até 2x na média geométrica de aplicações HPC (CP2K, GROMACS, ICON, MILC, Chroma e Quantum Espresso) sobre o H100. O número de 110x, muito citado, compara o H200 com CPUs dual Sapphire Rapids e não com o H100.
Consequências da inação: três formas de errar a decisão
O primeiro erro é pagar pelo H200 sem ter uma carga que o aproveite. Se o seu modelo é pequeno e o lote já satura a computação, a banda extra fica ociosa. Nesse caso, o prêmio de preço do H200 é custo sem retorno.
O segundo erro é o oposto: permanecer no H100 em cargas limitadas por memória. O efeito aparece como menos tokens por GPU, necessidade de mais placas para a mesma vazão e restrições de contexto que limitam o produto. O custo de oportunidade é difícil de ver porque o sistema “funciona”, só que a um custo unitário maior.
O terceiro erro é ignorar o mercado. Segundo a Cast AI, a AWS elevou em 15% o preço on-demand das instâncias H200 em 4 de janeiro de 2026, o primeiro aumento de preço de GPU em cerca de duas décadas. Ao mesmo tempo, a mesma análise aponta risco de sobreoferta de H100 conforme H200 e Blackwell ganham escala.
A IntuitionLabs, citando o índice da SemiAnalysis, registra a queda do aluguel de H100 de US$ 6,62 por hora no fim de 2023 para US$ 2,83 por hora em fevereiro de 2026. Contratos longos assinados sem essa leitura de mercado podem travar a organização em preços fora da curva.
Fundamentos da solução: o que os benchmarks realmente medem
MLPerf Inference: a referência padronizada
O MLPerf Inference, mantido pela MLCommons, é a base de comparação mais aceita do setor. Na rodada v4.0, com o modelo Llama 2 70B, os números compilados pela Cudo Compute mostram o seguinte cenário.
| Cenário (Llama 2 70B, MLPerf v4.0) | H100 (tokens/s) | H200 (tokens/s) | Ganho do H200 |
|---|---|---|---|
| Offline | 22.290 | 31.712 | +42% |
| Server | 21.504 | 29.526 | +37% |
Outras fontes, como a Emma, citam 21.806 tokens/s para o H100 no cenário offline, o que eleva o ganho para cerca de 45%. A divergência vem de qual submissão de H100 é tomada como referência. A conclusão qualitativa se mantém: o ganho em inferência de modelo grande fica entre 37% e 45% nessa rodada.
Há duas ressalvas importantes. A primeira é que o software evolui: segundo a Spheron, entre as rodadas v4.0 e v4.1 a NVIDIA obteve mais 27% de desempenho no H200 apenas com otimizações de software. A segunda é que a CoreWeave reportou 33.000 tokens/s com H200 na rodada v5.0, 40% acima da melhor submissão de H100 da v4.1 para o mesmo modelo.
O que as alegações do fabricante significam
A NVIDIA divulga ganho de até 1,9x a 2x em inferência de Llama 2 70B. Esse número depende de uma configuração específica: lote 8 no H100 contra lote 32 no H200, conforme as notas de rodapé do datasheet. A Yotta Labs, ao analisar os resultados do MLPerf, conclui que o H200 não é “2x mais rápido” e que o ganho em alguns cenários padronizados fica em faixa de dígito único a pouco mais de dez por cento.
As duas leituras são compatíveis. O 2x é o teto, obtido quando a memória extra permite um lote que o H100 não comporta. Os ganhos de 10% a 45% são o que se observa em configurações mais próximas entre si. Para a decisão de compra, vale a faixa que se aproxima do seu perfil de carga.
Interoperabilidade com a infraestrutura existente
Como o H200 mantém a arquitetura, o NVLink e o perfil de potência do H100, a migração tende a ser um upgrade incremental. A Vast.ai descreve o H200 como um caminho direto para ganhar desempenho sem reformular a infraestrutura. Servidores, refrigeração e pilha de software CUDA seguem o mesmo padrão, o que reduz o risco de integração.
Implementação estratégica: como validar o ganho na sua carga
Um teste independente de referência
A Vast.ai executou o modelo DeepSeek R1 Distill Llama 8B com vLLM nas duas GPUs. O H200 completou o teste em 40,02 s contra 45,28 s do H100, uma redução de cerca de 12% no tempo. O throughput de saída foi de 15.435 tokens/s contra 13.650 tokens/s, ganho de cerca de 13%.
Esse resultado é coerente com o que se espera de um modelo de 8 bilhões de parâmetros, que não esgota a memória do H100. O ganho existe, mas é moderado, porque vem principalmente da banda e não da capacidade.
Metodologia de benchmark próprio
O primeiro passo é caracterizar a carga: tamanho do modelo, precisão, distribuição de comprimento de contexto e padrão de concorrência. O segundo é rodar dois testes. Um em configuração idêntica nas duas GPUs, para isolar o efeito de banda. Outro com o melhor lote que cada GPU suporta, para medir o ganho operacional.
As métricas devem incluir throughput, latência até o primeiro token e latência p95 sob carga realista. Um benchmark que mede só tokens por segundo médios esconde caudas de latência que afetam a experiência do usuário final.
Pontos de falha comuns
O erro mais frequente é comparar configurações diferentes sem declarar isso, como lote 8 contra lote 32. Outro é misturar variantes: a Spheron estimou o H100 PCIe em cerca de 42% do H200 SXM na análise do MLPerf v6.0, o que não é comparável ao H100 SXM. Também comprometem os resultados versões distintas de driver, de biblioteca de inferência ou de quantização entre as duas execuções.
Testes curtos demais, que não atingem regime estacionário, e medições feitas sem fixar o limite de potência completam a lista. Cada um desses desvios pode inverter a conclusão.
Melhores práticas avançadas: potência, governança e segurança
O limite de potência muda o vencedor
Um estudo publicado no arXiv em março de 2026, com benchmarking sensível à potência, trouxe um achado contraintuitivo. Em limites baixos de potência, o H100 entrega a maior vazão. O H200 começa um pouco atrás, escala melhor e ultrapassa o H100 na faixa intermediária.
A 700 W, o H200 atingiu 34.107 tokens/s em pré-treinamento, contra 30.271 tokens/s do H100, ganho de cerca de 13%. Em inferência, foram 2.418 tokens/s contra 2.191 tokens/s, cerca de 10% a mais. Para data centers com orçamento de potência restrito por rack, o H100 pode continuar competitivo.
Governança e compliance de benchmark
Decisões de investimento em GPU de seis dígitos exigem rastreabilidade. Registre versão de driver, de framework, parâmetros de lote, precisão, data de execução e responsável. Isso permite reproduzir o resultado em uma auditoria e atualizar a comparação quando uma nova rodada do MLPerf for publicada.
Do ponto de vista de custos, vale atribuir o gasto de GPU a times e projetos, como recomendam análises de FinOps citadas pela CloudZero. Sem alocação, a comparação entre H100 e H200 vira discussão de preço de lista e não de custo por resultado.
Considerações de segurança
Mais memória por GPU favorece consolidar mais modelos ou mais clientes na mesma placa. Essa consolidação melhora a utilização, mas exige políticas explícitas de isolamento entre cargas, controle de acesso ao cluster e monitoramento por inquilino. Trate o ganho de eficiência e o desenho de segurança como decisões acopladas.
Medição de sucesso: custo por resultado, e não por hora
O preço de lista engana
Em agosto de 2026, segundo levantamento da Akash Network, o aluguel on-demand de H200 variava de US$ 4,45 a US$ 10,60 por GPU-hora. Nebius cobrava US$ 4,50, RunPod Secure Cloud US$ 4,59, CoreWeave US$ 6,31, AWS US$ 7,91 e Azure US$ 10,60. Capacidade interrompível partia de US$ 2,33 por GPU-hora.
Para o H100, a IntuitionLabs registrou em julho de 2026 faixas de US$ 1,38 a US$ 1,49 em marketplaces até US$ 11,68 a US$ 12,29 em instâncias on-demand de hiperescaladores. Na compra direta, a Jarvislabs cita cerca de US$ 25.000 por H100, enquanto o H200 aparece entre US$ 30.000 e US$ 40.000. A IntuitionLabs, em setembro de 2026, menciona faixas de até US$ 55.000 para o H200 em guias de terceiros.
Custo por milhão de tokens
A comparação útil é o custo por resultado. Na análise do MLPerf Inference v6.0 da Spheron, o H200 SXM entregou cerca de 3.100 tokens/s por GPU no modelo GPT-OSS 120B. A US$ 4,50 por hora, isso equivale a aproximadamente US$ 0,40 por milhão de tokens. O H100 PCIe, com vazão estimada, não medida, em torno de 1.300 tokens/s, ficou em cerca de US$ 0,45 mesmo com hora mais barata (US$ 2,11).
Como a vazão do H100 PCIe nessa análise é uma estimativa, o resultado indica uma tendência e não uma prova. O aprendizado prático é que uma GPU com hora mais cara pode ter custo por token menor. A DEV Community resume o princípio: o H200 pode superar o H100 em preço e desempenho para inferência limitada por memória.
KPIs recomendados
No plano técnico, acompanhe tokens por segundo por GPU, latência até o primeiro token, latência p95, utilização de memória e tokens por watt. No plano de negócio, acompanhe custo por milhão de tokens, custo por execução de treinamento e GPUs necessárias para a meta de vazão. A decisão entre H100 e H200 deve ser revista sempre que preço, software ou carga mudarem de forma relevante.
Conclusão: o H200 vence onde a memória é o gargalo
O benchmark H200 vs H100 conta uma história consistente. Com computação de pico idêntica, o H200 se destaca quando a carga é limitada por memória: modelos de 70B parâmetros ou mais, lotes grandes e contextos longos. Nesses casos, os resultados do MLPerf mostram ganhos de 37% a 45%, e as configurações mais favoráveis chegam perto de 2x. Em modelos pequenos, o ganho cai para algo próximo de 10% a 13%, e sob limites baixos de potência o H100 pode ser mais eficiente.
A decisão correta nasce do perfil da carga e do custo por resultado. Antes de comprar ou contratar, rode o teste em configuração idêntica e em configuração otimizada, meça latência de cauda e calcule o custo por milhão de tokens. Documente o procedimento para poder repetir a comparação quando o mercado e o software mudarem.
Olhando adiante, a transição para Blackwell reposiciona toda a conversa. Segundo nota da CoreWeave sobre o MLPerf Inference v5.0, o GB200 entrega 2,86x o desempenho do H200 por GPU no modelo Llama 3.1 405B em FP8. Isso tende a pressionar os preços de Hopper, o que favorece compradores que contratam com flexibilidade.
Os próximos passos práticos são quatro: classificar suas cargas por sensibilidade à memória, executar o benchmark nas duas GPUs, calcular o custo por milhão de tokens com os preços vigentes e só então fechar o contrato, preferindo prazos que permitam renegociar quando Blackwell ganhar escala.