Infraestrutura para VFX no Cinema: Guia Estratégico 2026
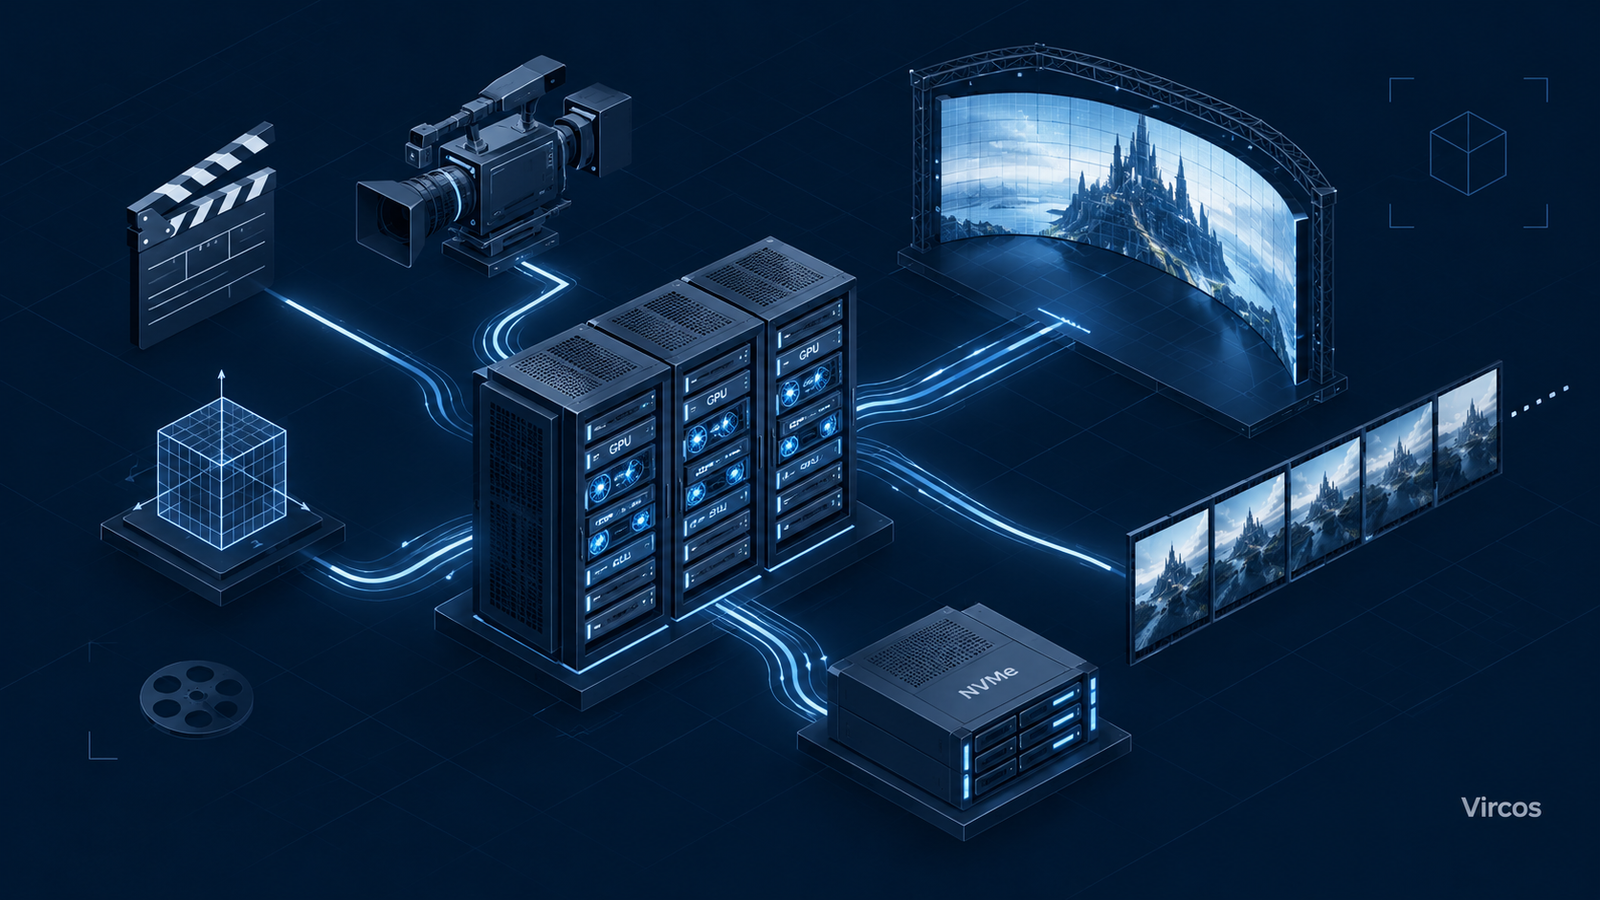
O VFX no cinema deixou de ser uma etapa que acontece depois da filmagem. Em 2026, ele começa na pré-visualização com engines de tempo real, avança para o set com paredes de LED, passa por pipelines que incorporam IA generativa e termina em milhares de frames renderizados, compostos e revisados sob prazos que não toleram retrabalho.
Para quem decide investimentos de um estúdio ou produtora, o desafio é que cada etapa pressiona a infraestrutura de um jeito diferente. A renderização exige computação heterogênea, entre CPU e GPU. A produção virtual exige sincronização em tempo real entre nós gráficos. A IA exige memória de vídeo e armazenamento rápido. Tudo isso acontece sob regras de segurança impostas pelos clientes.
O custo de errar é concreto: frames que não fecham no prazo, GPUs caras esperando dados e contratos perdidos por falha em auditoria. Este guia analisa o problema estratégico, as consequências da inação, os fundamentos técnicos, a implementação, as melhores práticas e as métricas de sucesso para uma infraestrutura de VFX para cinema preparada para 2026.
1. O problema estratégico: pipelines que crescem mais rápido que a infraestrutura
O desafio empresarial
Estúdios de VFX vivem um descompasso. A demanda por shots mais complexos, em resolução maior e com mais iterações cresce em ritmo constante. O orçamento de capital e os ciclos de compra de hardware não acompanham esse ritmo.
O mercado de renderização 3D reflete a pressão. Projeções citadas pela Super Renders Farm (2026) apontam crescimento de cerca de US$ 4,30 bilhões em 2025 para US$ 13,92 bilhões em 2031 (CAGR de aproximadamente 21,6%). A participação da renderização por GPU subiria de cerca de 55,8% em 2024 para perto de 60% em 2026. Por ser uma fornecedora do setor, trate essa fonte como indicativa, não como dado auditado.
Implicações técnicas e de negócio
A leitura apressada seria “tudo migra para GPU”. A mesma fonte mostra o contrário: na sua própria operação, a CPU ainda responde por cerca de 70% do mix de jobs, enquanto a GPU ganha espaço em Redshift, Octane, V-Ray GPU e trabalhos com Gaussian Splatting. A conclusão prática é planejar para heterogeneidade, não para substituição.
Isso muda a conversa de negócio. Comprar apenas GPUs deixa pipelines de simulação e finalização pesada sem capacidade. Comprar apenas CPUs deixa lookdev, denoising por IA e engines de tempo real sem velocidade. O investimento precisa seguir o perfil real de carga do estúdio.
Cenários críticos
Um cenário recorrente é a atualização de software de DCC (criação 3D) durante uma entrega. Segundo a Super Renders Farm (2026), uma farm precisa instalar e validar a nova versão do Cinema 4D e esperar que os renderizadores, como Redshift, Octane, Arnold e V-Ray, publiquem builds compatíveis com o novo SDK. Essa validação costuma levar de quatro a oito semanas após uma versão estável. Estúdios que atualizam sem planejar podem perder a janela de entrega.
2. Consequências da inação
Riscos específicos
O primeiro risco é a ociosidade cara. Uma GPU de alto desempenho esperando dados do armazenamento é capital imobilizado. O segundo é a instabilidade: cenas grandes que estouram a memória de vídeo derrubam renders e forçam reexecuções que consomem horas de fila.
O terceiro risco é de conformidade. Clientes de grandes estúdios impõem auditorias de segurança, redes isoladas e cláusulas que restringem o uso de nuvem para material pré-lançamento. Infraestrutura improvisada falha nessas auditorias, e a falha costuma significar perda de contrato, não apenas multa.
Custos de oportunidade
Estúdios que adotaram renderização em nuvem junto com ferramentas assistidas por IA em 2025-2026 relataram concluir mais projetos no mesmo prazo sem aumentar a equipe, segundo a Super Renders Farm (2026). Quem não moderniza o pipeline não tem como disputar esse volume.
Há também o custo da IA “não autorizada”. Segundo a Vitrina (2026), adotar frameworks de IA autorizada, com dados de treinamento licenciados e cadeia de titularidade limpa, adiciona entre 8% e 12% ao custo operacional de um estúdio. Ignorar o tema hoje significa renegociar contratos amanhã.
Desvantagens competitivas
A barreira de acesso à computação também está diminuindo. A cobertura setorial citada pela Super Renders Farm (2026) indica que provedores de GPU de segunda linha cobram cerca de US$ 0,66 por hora de A100, contra US$ 4,10 em nuvens de primeira linha. Estúdios menores passam a ter acesso a capacidade que antes era exclusiva dos grandes. Para o estúdio que depende só de hardware próprio subutilizado, essa pressão de preço vai aumentar.
3. Fundamentos da solução
Computação heterogênea e memória de vídeo
O ponto de partida é casar renderizador e hardware. O Redshift roda apenas em GPU NVIDIA, conforme a Super Renders Farm (2026). O Arnold GPU está maduro para lookdev, previews e finais compatíveis com a VRAM disponível, mas a mesma fonte recomenda Arnold em CPU para finais pesados, saídas em deep EXR e shaders customizados.
A VRAM virou o gargalo central. As farms de Cinema 4D descrevem frotas novas com NVIDIA RTX 5090 (32 GB) e RTX 6000 Pro Blackwell (96 GB). Se a cena não cabe na memória, o ganho de velocidade da GPU desaparece. Dimensionar VRAM pelo maior shot do projeto, e não pela média, é a regra mais segura.
A geração Blackwell profissional
A NVIDIA RTX PRO 6000 Blackwell é a referência atual para quem precisa de memória grande em estações e servidores. Segundo as especificações publicadas por parceiros como PNY, a placa traz 96 GB de GDDR7 com ECC, 24.064 núcleos CUDA, 752 Tensor Cores de quinta geração e 188 RT Cores de quarta geração.
Ela existe em três variantes. A Workstation Edition é voltada a um único GPU por estação, com consumo de até 600 W. A Max-Q Workstation Edition (300 W) atende configurações multi-GPU. A Server Edition tem refrigeração passiva e foi desenhada para servidores densos, segundo a NVIDIA, incluindo renderização distribuída e estações virtuais. Distribuidores também listam suporte a MIG, que divide a GPU em até quatro instâncias isoladas, útil para compartilhar capacidade entre artistas ou entre render e IA.
Interoperabilidade: OpenUSD e gestão de cor
Infraestrutura sem padrões de dados gera atrito entre departamentos. O OpenUSD, criado pela Pixar, ganhou governança formal com a Alliance for OpenUSD, fundada em 2023 por Pixar, Adobe, Apple, Autodesk e NVIDIA. A AOUSD anuncia a Core Specification 1.0 como padrão pronto para produção, o que reduz o risco de adoção para estúdios que ainda dependem de formatos proprietários.
No lado da cor, o uso consistente de OpenColorIO e ACES entre composição, iluminação e revisão evita retrabalho invisível. Não é um item de hardware, mas define como os monitores, os nós de render e as estações de revisão precisam ser calibrados e configurados.
4. Implementação estratégica
Abordagem metodológica: base própria, picos na nuvem
A arquitetura mais defensável combina uma base on-premises dimensionada para a carga constante com capacidade em nuvem para picos. A base própria dá previsibilidade de custo e controle de segurança. A nuvem absorve entregas concentradas, sem exigir compra de hardware que ficaria parado fora do pico.
O passo anterior a qualquer compra é perfilar a carga: quais renderizadores, qual proporção CPU/GPU, qual VRAM máxima por frame e qual volume de texturas e caches por shot. Sem esse mapa, o estúdio compra pelo catálogo e não pela necessidade.
Armazenamento e rede: o que alimenta a GPU
Pipelines de VFX movimentam texturas, geometria e caches de simulação em paralelo. A PROMISE Technology (2026) descreve plataformas baseadas em NVMe e flash que alimentam farms de GPU em velocidade plena, com NVMe-oF e sistemas de arquivos como o BeeGFS. Os conceitos de fundo são arquivos em paralelo, rede de baixa latência e cache em disco local rápido.
No nível do nó, a distribuição de lanes PCIe importa. A iRender (2026) descreve o fenômeno de “GPU starvation”, em que placas potentes ficam sem dados por causa de barramento limitado, e oferece como contraponto nós com Threadripper PRO de 128 lanes e até 8 GPUs RTX 5090. A fonte é comercial, mas o princípio de engenharia se sustenta: equilibre CPU, lanes, RAM e NVMe com a GPU.
| Carga de trabalho | Perfil de hardware | Ponto de atenção |
|---|---|---|
| Redshift, Octane, lookdev | GPUs NVIDIA com VRAM alta (32–96 GB) | Compatibilidade de driver e build com a versão do DCC |
| Arnold/V-Ray em finais pesados, deep EXR | Nós CPU com muita RAM por thread | Memória por thread pesa mais que FLOPS brutos |
| Produção virtual (nDisplay) | Cluster de nós gráficos sincronizados | Latência e sincronismo entre nós e câmera |
| IA generativa e denoising | GPUs com VRAM de 48 GB ou mais e NVMe de scratch | Isolamento de dados do cliente |
Pontos de falha potenciais
Os pontos de falha mais comuns são previsíveis. Versões de driver incompatíveis com o renderizador são um exemplo: a Super Renders Farm (2026) documenta matrizes que exigem drivers mínimos diferentes por combinação de Cinema 4D e Redshift. Outro ponto é o armazenamento dimensionado para throughput sequencial, quando a carga real é de muitos arquivos pequenos.
Um terceiro ponto é licenciamento. Farms próprias precisam de licenças de render distribuídas corretamente, e o crescimento de nós sem revisão de licenças gera paradas na entrega.
5. Melhores práticas avançadas
Produção virtual com LED volume
A produção virtual deixou de ser exclusividade de grandes estúdios. A Vitrina (2026) estima o mercado em cerca de US$ 3,67 bilhões em 2026, com projeção de US$ 7,75 bilhões em 2031. O segmento de LED volumes cresceria cerca de 31,5% ao ano e as diárias de grandes stages ficariam entre US$ 15 mil e US$ 80 mil. A mesma fonte afirma que o LED volume reduz em 40% a 70% o VFX de pós em planos de ambiente comparado ao chroma key. É um número de fonte comercial, que deve ser validado caso a caso.
Tecnicamente, o volume combina painéis de LED, rastreamento de câmera e renderização em tempo real, quase sempre em Unreal Engine, com clusters nDisplay sincronizando a imagem ao frustum da câmera. Na NAB 2026, a AMD apresentou o caso de uma operação com Qube Cinema e Triality que usa processadores EPYC e Threadripper PRO 7000 WX e GPUs Radeon AI PRO R9700 com Unreal, com planos de rodar IA generativa na mesma infraestrutura.
IA no pipeline sem criar uma ilha
Em 2026, a IA generativa passou a fazer parte do pipeline: previs com difusão, rotoscopia e limpeza assistidas, captura com Gaussian Splatting e renderização neural. A recomendação da GPU Mart (2026) é estender a farm com nós aptos aos dois usos, com VRAM de 48 GB ou mais e NVMe rápido de scratch, em vez de construir um cluster de IA separado.
Isso responde também à questão de segurança. Stacks abertas rodando localmente permitem isolar dados do cliente, algo que ferramentas SaaS não garantem. A Foundry lançou o Griptape Enterprise com governança de modelos e opção de execução on-premises ou em nuvem privada, para manter propriedade intelectual, prompts e dados de treinamento dentro da instalação.
Governança, compliance e segurança
Estúdios que atendem grandes clientes lidam com auditorias no estilo TPN, redes isoladas e cláusulas contra nuvem para material inédito. A Cinesite levou ao SIGGRAPH 2026 uma sessão sobre VDI, tanto on-premises quanto em nuvem, para produção segura e remota. Estações virtuais mantêm o dado no datacenter e entregam apenas pixels ao artista.
Boa prática é documentar a trilha de dados de cada ativo, segmentar redes por projeto e definir quais modelos de IA podem tocar material sensível. Essa documentação costuma ser exigida antes da assinatura do contrato.
6. Medição de sucesso
Indicadores técnicos
Sem métricas, o investimento vira aposta. Os indicadores técnicos mais úteis são a utilização média de GPU e CPU, o tempo médio por frame por renderizador, a taxa de re-render por falha e o throughput efetivo do armazenamento durante picos. Uma GPU com baixa utilização apontando para armazenamento ou rede lentos é o sinal clássico de starvation.
Também vale medir o tempo para validar uma nova versão de DCC e renderizador, já que ele define a agilidade do estúdio diante de atualizações.
Indicadores de negócio
No lado financeiro, o custo por frame (hardware próprio e nuvem somados), a taxa de ocupação da base on-premises e o percentual de entregas dentro do prazo mostram se o modelo híbrido está equilibrado. A taxa de aprovação em auditorias de segurança deve ser acompanhada como indicador comercial, não só de TI.
Avaliação de eficácia
Defina uma linha de base antes de qualquer mudança e reavalie a cada projeto grande. A comparação deve ser feita sobre shots equivalentes. Sem isso, ganhos de hardware se misturam com variações de complexidade criativa.
Conclusão
A infraestrutura de VFX para cinema em 2026 é um problema de equilíbrio. O estúdio precisa combinar CPU e GPU conforme a carga real, dimensionar VRAM pelo pior shot, alimentar as placas com armazenamento e rede à altura, e tratar produção virtual e IA como extensões da mesma base, não como ilhas.
Olhando adiante, a tendência é de convergência: OpenUSD como linguagem comum, GPUs de 96 GB como padrão para cargas pesadas e IA integrada ao pipeline sob governança de dados. Os estúdios que decidirem agora com base em perfil de carga e métricas chegam melhor à próxima rodada de contratos.
Como próximos passos práticos, mapeie o perfil de carga dos últimos três projetos e meça a utilização atual de GPU e armazenamento. Defina os requisitos de segurança dos clientes-alvo e compare o custo por frame entre capacidade própria e burst em nuvem. Só então especifique servidores, workstations e armazenamento, com apoio de um parceiro de infraestrutura que entenda o fluxo de VFX.