Zero Downtime: Estratégia para Infraestrutura Crítica
Zero Downtime: Como Projetar Infraestrutura Empresarial Resiliente
Em ambientes empresariais modernos, disponibilidade deixou de ser apenas uma característica desejável da infraestrutura de TI e passou a representar um requisito operacional. Sistemas de ERP, bancos de dados, plataformas de comércio eletrônico, aplicações SaaS, ambientes de inteligência artificial e serviços corporativos podem sustentar processos que não toleram interrupções prolongadas.
É nesse contexto que surge o conceito de Zero Downtime. Apesar de frequentemente utilizado como sinônimo de alta disponibilidade, o termo exige uma interpretação mais rigorosa: não significa simplesmente instalar dois servidores ou manter um backup atualizado. Significa projetar uma arquitetura na qual falhas previsíveis possam ocorrer sem necessariamente interromper o serviço percebido pelo usuário.
Essa diferença é fundamental. Uma infraestrutura pode possuir redundância e ainda apresentar indisponibilidade quando um componente falha. O problema pode estar no storage, no switch, no hipervisor, no banco de dados, na configuração de rede, no sistema de autenticação ou até em uma dependência externa aparentemente secundária.
Por isso, uma estratégia de Zero Downtime precisa considerar a infraestrutura como um sistema integrado de disponibilidade. Servidores, armazenamento, rede, virtualização, aplicações, dados, energia, monitoramento e processos operacionais precisam ser analisados conjuntamente.
Este artigo apresenta uma visão técnica e estratégica sobre o tema, explicando os principais desafios, os riscos da indisponibilidade, os fundamentos arquitetônicos, as estratégias de implementação, as práticas avançadas de segurança e as métricas necessárias para determinar se uma arquitetura realmente entrega resiliência operacional.
1. O problema estratégico por trás do Zero Downtime
O primeiro erro em projetos de disponibilidade é tratar downtime exclusivamente como um problema de hardware. Na prática, uma interrupção pode resultar de uma combinação de fatores técnicos, humanos e operacionais.
Um servidor pode possuir fontes redundantes e continuar indisponível se estiver conectado a um único switch. Um cluster pode possuir múltiplos nós, mas perder o serviço se todos dependerem de um único storage. Da mesma forma, um sistema de armazenamento redundante não elimina o risco caso toda a infraestrutura esteja concentrada em uma única sala, rack ou circuito elétrico.
O conceito de disponibilidade precisa, portanto, ser analisado em termos de domínios de falha. Um domínio de falha representa um conjunto de componentes que pode ser afetado pelo mesmo evento. Quanto maior a quantidade de elementos compartilhando um domínio de falha, maior a possibilidade de uma única ocorrência provocar uma interrupção ampla.
Disponibilidade não é simplesmente redundância
Redundância é um mecanismo; disponibilidade é um resultado. Essa distinção parece semântica, mas possui consequências importantes no desenho da infraestrutura.
Adicionar um segundo servidor pode criar redundância computacional. Entretanto, se os dois servidores utilizarem o mesmo storage, o mesmo switch ou a mesma alimentação elétrica, determinados pontos únicos de falha continuam existindo.
Uma arquitetura realmente resiliente procura eliminar ou reduzir esses pontos únicos. Isso envolve servidores redundantes, caminhos de rede redundantes, controladoras redundantes, fontes de alimentação independentes, armazenamento resiliente e mecanismos automatizados de failover.
O impacto empresarial da indisponibilidade
O custo de uma interrupção não está limitado ao tempo em que um servidor permanece desligado. Dependendo da operação, a indisponibilidade pode provocar perda de transações, interrupção de produção, atraso logístico, impacto sobre clientes e necessidade de intervenção manual.
Existe ainda uma dimensão menos evidente: a indisponibilidade pode gerar efeitos em cadeia. Se um sistema centralizado de autenticação falha, aplicações que continuam funcionando tecnicamente podem deixar de ser acessíveis. Se um banco de dados fica indisponível, diversos serviços dependentes podem apresentar falhas simultaneamente.
Por isso, projetos de Zero Downtime devem começar pela identificação das dependências críticas da operação, e não pela compra de equipamentos.
2. As consequências da inação
Quando a organização não estrutura adequadamente sua estratégia de disponibilidade, normalmente acaba adotando uma abordagem reativa. O ambiente funciona durante meses ou anos até que uma falha revele uma dependência que nunca havia sido identificada.
Esse modelo é especialmente perigoso em ambientes virtualizados. Um cluster de virtualização pode aparentar elevada disponibilidade enquanto diversos serviços dependem de uma infraestrutura de storage centralizada. A falha desse componente pode afetar simultaneamente dezenas de máquinas virtuais.
O risco dos pontos únicos de falha
Um Single Point of Failure, ou SPOF, é qualquer componente cuja falha seja capaz de interromper uma função crítica sem que exista uma alternativa operacional equivalente.
Os exemplos mais comuns incluem um único switch de rede, uma única controladora, um único servidor DNS, um único caminho de armazenamento, um único circuito elétrico ou uma única instância de um serviço essencial.
O problema não é necessariamente a existência de um componente individual. O problema ocorre quando sua importância operacional é maior do que a arquitetura consegue absorver em caso de falha.
O custo oculto de arquiteturas frágeis
Infraestruturas não resilientes frequentemente apresentam um custo inicial menor. Entretanto, essa economia pode ser ilusória porque transfere o risco para a operação.
Quando ocorre uma falha, a organização pode precisar mobilizar equipes, restaurar serviços manualmente, recuperar dados, investigar inconsistências e reconstruir configurações. O custo operacional pode superar significativamente a economia obtida na implantação original.
Além disso, uma arquitetura frágil limita a capacidade de manutenção preventiva. Se determinado componente não possui redundância, atualizar seu firmware ou realizar uma intervenção planejada pode exigir uma janela de indisponibilidade.
3. Fundamentos técnicos de uma arquitetura Zero Downtime
Uma arquitetura de Zero Downtime deve ser construída em camadas. A disponibilidade do serviço final depende da combinação entre computação, armazenamento, conectividade, energia, software e processos.
Alta disponibilidade na camada de computação
Na camada computacional, o princípio fundamental é evitar que a falha de um único servidor interrompa o serviço. Em ambientes virtualizados, isso normalmente envolve clusters capazes de deslocar ou reiniciar cargas de trabalho em outros nós.
Entretanto, failover não é sinônimo de ausência de interrupção. Se uma máquina virtual precisa ser reiniciada após a perda do host, existe necessariamente algum intervalo de indisponibilidade. Dependendo da aplicação, isso pode ser aceitável ou não.
Aplicações que exigem níveis mais elevados de continuidade podem utilizar arquiteturas distribuídas, replicação entre instâncias e mecanismos capazes de manter múltiplos componentes ativos simultaneamente.
Storage como componente crítico
O armazenamento frequentemente representa um dos pontos mais importantes de uma arquitetura de disponibilidade. Afinal, servidores podem permanecer operacionais enquanto os dados necessários à execução das aplicações ficam inacessíveis.
Arquiteturas empresariais podem utilizar diferentes mecanismos de resiliência, incluindo RAID, replicação, snapshots, armazenamento distribuído e múltiplos caminhos de acesso. Cada mecanismo resolve uma classe diferente de problema.
RAID, por exemplo, pode proteger contra determinados tipos de falha de unidade, mas não substitui backup. Snapshots permitem recuperação rápida de determinados eventos, mas não devem ser tratados automaticamente como cópia independente contra todos os cenários de desastre.
Em ambientes críticos, o desenho do storage precisa considerar não apenas capacidade e desempenho, mas também tolerância a falhas, reconstrução, latência, conectividade, replicação e recuperação operacional.
Redundância de rede
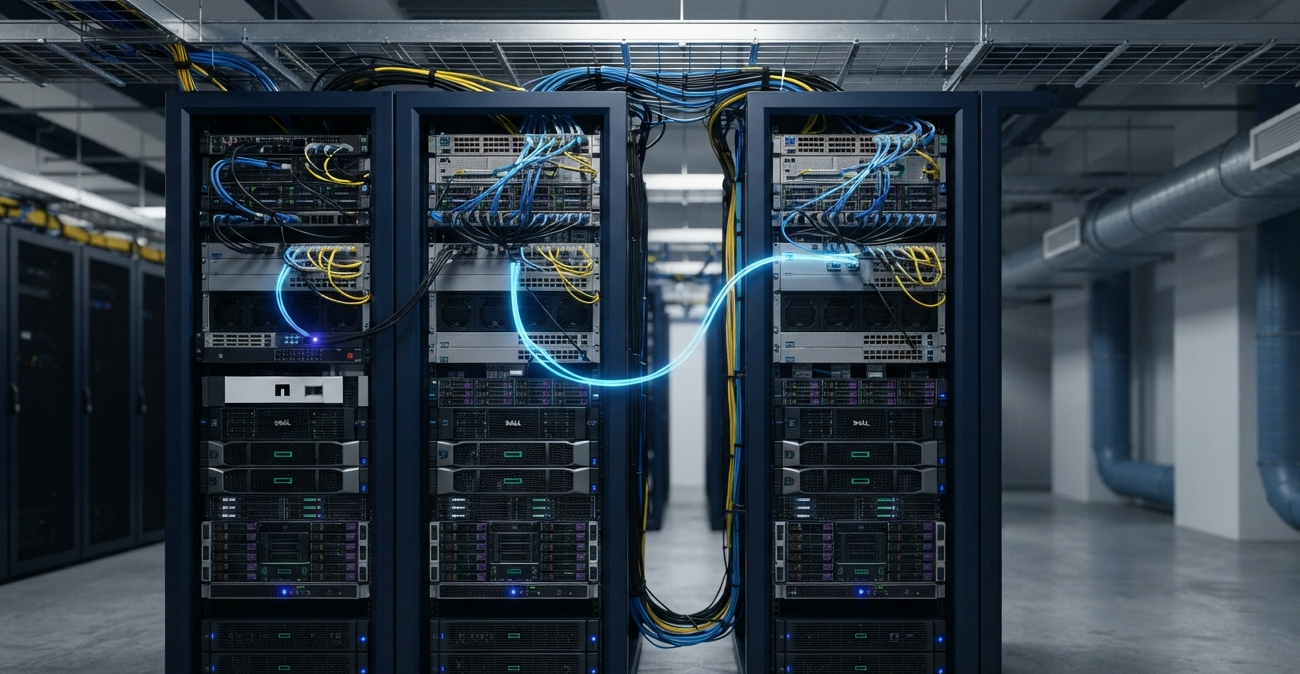
Outro componente frequentemente subestimado é a rede. Uma infraestrutura com servidores redundantes pode continuar vulnerável se todos dependerem de um único caminho Ethernet.
A redundância pode envolver múltiplas interfaces, switches independentes, agregação de links e arquiteturas que permitam a continuidade da conectividade quando determinado equipamento ou caminho falhar.
O objetivo não é simplesmente aumentar a quantidade de portas. É criar caminhos independentes capazes de sobreviver à falha de equipamentos ou segmentos específicos.
Energia e infraestrutura física
A disponibilidade lógica não pode compensar uma arquitetura elétrica inadequada. Servidores redundantes conectados ao mesmo circuito podem ser desligados simultaneamente por uma única falha elétrica.
Em ambientes críticos, UPS, distribuição elétrica redundante, fontes duplas e, quando necessário, geradores fazem parte da estratégia de continuidade. A infraestrutura física precisa ser tratada como parte integrante do sistema computacional.
4. Implementação estratégica do Zero Downtime
Implementar Zero Downtime não deveria começar pela aquisição de hardware. O primeiro passo é identificar quais serviços realmente exigem continuidade e qual nível de interrupção cada processo consegue suportar.
Definindo RTO e RPO
O RTO — Recovery Time Objective define quanto tempo uma organização aceita levar para recuperar determinado serviço. Já o RPO — Recovery Point Objective define a quantidade de dados que pode ser perdida em determinado cenário.
Esses parâmetros são fundamentais porque diferentes sistemas possuem necessidades diferentes. Uma aplicação interna de baixa criticidade pode tolerar uma recuperação mais longa, enquanto uma plataforma transacional pode exigir mecanismos de continuidade muito mais sofisticados.
Sem RTO e RPO definidos, existe o risco de investir excessivamente em sistemas que não precisam de disponibilidade extrema ou, inversamente, subdimensionar ambientes que sustentam processos críticos.
Mapeamento de dependências
Depois de classificar os serviços, é necessário mapear suas dependências. O objetivo é descobrir o que realmente precisa permanecer operacional para que determinada aplicação continue funcionando.
Esse mapa deve incluir banco de dados, DNS, autenticação, storage, rede, APIs externas, sistemas de monitoramento e demais serviços necessários.
Uma aplicação aparentemente redundante pode continuar vulnerável caso suas dependências estejam centralizadas. Portanto, o teste de dependência precisa fazer parte da validação da arquitetura.
Automação do failover
Em ambientes críticos, depender exclusivamente de intervenção humana para executar failover pode aumentar o tempo de recuperação. A automação permite que determinadas falhas sejam detectadas e tratadas imediatamente.
Porém, automação sem governança também cria riscos. Um mecanismo configurado incorretamente pode interpretar uma falha transitória como desastre e provocar mudanças desnecessárias na infraestrutura.
O equilíbrio adequado envolve detecção confiável, políticas de failover, quorum, monitoramento e procedimentos de recuperação manual para situações que não podem ser resolvidas automaticamente.
5. Melhores práticas avançadas
Redundância sem independência é uma falsa sensação de segurança
Um dos princípios mais importantes de projetos de alta disponibilidade é a independência entre componentes redundantes. Dois servidores instalados no mesmo rack não oferecem o mesmo nível de proteção que servidores distribuídos entre diferentes domínios de falha.
O mesmo princípio vale para storage e rede. Dois componentes podem ser logicamente redundantes e fisicamente dependentes de uma infraestrutura comum.
Essa análise leva ao conceito de fault domain: componentes que devem permanecer independentes precisam ser posicionados de forma que um único evento tenha menor probabilidade de afetá-los simultaneamente.
Zero Downtime e segurança
Disponibilidade não pode ser obtida sacrificando segurança. Uma infraestrutura que permanece permanentemente acessível, mas não possui controles adequados contra comprometimento, não representa continuidade operacional sustentável.
O desenho deve considerar segmentação de rede, controle de privilégios, autenticação forte, proteção das interfaces administrativas, atualização de software e monitoramento de eventos.
Também é necessário considerar ataques capazes de afetar simultaneamente produção e recuperação. Por isso, backup, snapshots e réplicas precisam ser protegidos contra alterações ou destruição indevida quando o cenário de ameaça justificar esse nível de controle.
Testes de falha
Uma arquitetura não pode ser considerada resiliente apenas porque seu diagrama apresenta componentes redundantes. É necessário comprovar que os mecanismos realmente funcionam.
Testes controlados podem envolver perda de um servidor, desconexão de uma interface, falha de caminho de storage ou indisponibilidade de determinado serviço.
O objetivo não é simplesmente verificar se o sistema recupera. É medir quanto tempo leva para detectar, quanto tempo leva para realizar o failover e quais funções permanecem indisponíveis durante o processo.
6. Como medir o sucesso
O desempenho de uma arquitetura Zero Downtime precisa ser acompanhado por indicadores técnicos e empresariais. Disponibilidade percentual isoladamente não fornece uma visão suficiente da resiliência.
KPIs técnicos
Entre os indicadores relevantes estão disponibilidade dos serviços, tempo médio para detecção de falhas, tempo médio de recuperação, quantidade de incidentes, taxa de sucesso dos failovers e resultados dos testes de recuperação.
Também é importante acompanhar latência, utilização de CPU, memória, IOPS, throughput de storage, utilização de interfaces de rede e capacidade disponível. Uma infraestrutura pode estar disponível e, ainda assim, apresentar degradação significativa de desempenho.
KPIs de negócio
O indicador mais importante não é necessariamente técnico. A organização precisa determinar se a infraestrutura consegue manter os processos que sustentam sua operação.
Isso pode envolver quantidade de transações preservadas, tempo de indisponibilidade percebido pelos clientes, impacto sobre produção e cumprimento dos níveis de serviço definidos internamente ou contratualmente.
Essa abordagem aproxima infraestrutura e negócio. O objetivo deixa de ser simplesmente manter servidores ligados e passa a ser preservar a continuidade dos serviços empresariais.
Disponibilidade versus resiliência
Uma distinção importante é que disponibilidade mede principalmente o estado operacional de um serviço, enquanto resiliência representa sua capacidade de suportar perturbações e continuar funcionando ou retornar rapidamente à operação.
Uma arquitetura madura precisa trabalhar os dois conceitos. Não basta apresentar alta disponibilidade em condições normais; é necessário demonstrar comportamento previsível durante falhas.
Conclusão
Zero Downtime não deve ser interpretado como a simples promessa de que uma infraestrutura jamais ficará indisponível. Em ambientes reais, componentes falham, atualizações podem gerar problemas, redes podem apresentar interrupções e eventos físicos podem afetar múltiplos sistemas simultaneamente.
O verdadeiro objetivo de uma arquitetura de Zero Downtime é reduzir drasticamente a probabilidade de uma falha isolada transformar-se em uma interrupção do serviço crítico. Isso exige redundância, independência entre domínios de falha, automação, monitoramento, armazenamento resiliente, conectividade redundante e processos operacionais maduros.
A principal mudança de perspectiva é entender que alta disponibilidade é uma propriedade da arquitetura, não de um equipamento específico. Um servidor extremamente confiável não resolve um problema de rede; um storage redundante não elimina um desastre físico; e um backup excelente não substitui mecanismos de continuidade quando o negócio não pode esperar pela restauração.
Para organizações que dependem cada vez mais de aplicações digitais, virtualização, inteligência artificial e processamento contínuo de dados, a resiliência precisa ser incorporada desde o projeto. Isso significa definir RTO e RPO, mapear dependências, identificar SPOFs, estabelecer domínios de falha e testar regularmente os mecanismos de recuperação.
O próximo estágio da infraestrutura empresarial não será determinado apenas por maior capacidade computacional. Será determinado pela capacidade de continuar operando diante da falha. Nesse cenário, Zero Downtime deixa de ser apenas uma característica técnica e passa a representar uma estratégia de continuidade operacional.