InfiniBand 400G: Guia Estratégico de Rede para IA e HPC 2026
Introdução
Em 2026, a decisão sobre qual tecnologia de interconexão usar em um cluster de IA ou HPC deixou de ser um detalhe de engenharia e passou a ser uma escolha estratégica com impacto direto no orçamento, no time-to-market e na capacidade competitiva da empresa. O InfiniBand 400G (NDR), construído sobre a plataforma NVIDIA Quantum-2, continua sendo a referência de desempenho para cargas de trabalho que exigem latência ultrabaixa e comunicação intensiva entre nós — mesmo com o avanço acelerado do Ethernet nesse mercado.
O desafio para líderes de TI e arquitetos de infraestrutura é duplo: de um lado, o custo de subdimensionar a rede de um cluster de treinamento de IA pode inviabilizar o ROI de investimentos multimilionários em GPUs; de outro, comprometer-se com hardware superdimensionado ou já em transição para gerações superiores (como o XDR 800G) pode travar capital em uma tecnologia com janela de relevância mais curta. Este guia apresenta os fundamentos técnicos, o cenário competitivo atual e as considerações práticas para decidir onde o InfiniBand 400G ainda faz sentido em 2026.
1. O Problema Estratégico: Rede como Gargalo Invisível
Clusters de treinamento de modelos de IA modernos dependem de comunicação coletiva intensa entre GPUs — operações como all-reduce e all-to-all que sincronizam gradientes a cada passo de treinamento. Quando a rede não acompanha a capacidade de computação, as GPUs — que custam dezenas de milhares de dólares cada — ficam ociosas esperando dados, um desperdício direto de capital.
Isso torna a escolha da fabric de interconexão tão crítica quanto a escolha da GPU. Um cluster de 256 a 2.048 GPUs, por exemplo, pode ter custos de rede que rivalizam com o investimento em processadores, e decisões equivocadas nessa camada corroem a eficiência de utilização do cluster (a chamada “GPU utilization”) por meses.
O InfiniBand NDR resolve esse gargalo entregando latência abaixo de 2 microssegundos e transporte RDMA nativo com garantia de entrega sem perda de pacotes — características historicamente difíceis de replicar em Ethernet convencional, embora esse cenário venha mudando rapidamente, como será discutido adiante.
2. Consequências da Inação: O Custo de Ficar para Trás
Organizações que adiam a modernização de sua fabric de rede para 400G, mantendo infraestrutura em gerações anteriores (HDR 200G ou EDR 100G), enfrentam desvantagem direta em tempo de treinamento de modelos e em throughput de simulações HPC. Isso se traduz em ciclos de pesquisa mais longos, maior consumo de energia por unidade de trabalho útil e dificuldade para atrair cargas de trabalho de IA generativa que dependem de escala.
Há também um risco de obsolescência de ecossistema: comprar hardware NDR hoje sem considerar interoperabilidade com fabrics XDR 800G (Quantum-X800) pode gerar ilhas de infraestrutura difíceis de integrar em expansões futuras. Por outro lado, atrasar toda decisão à espera de uma geração ainda não lançada comercialmente também tem custo de oportunidade — especialmente porque o ecossistema de cabos e óptica para 400G está maduro e com preços competitivos, o que não ocorre ainda com tecnologias de próxima geração.
3. Fundamentos Técnicos da Solução
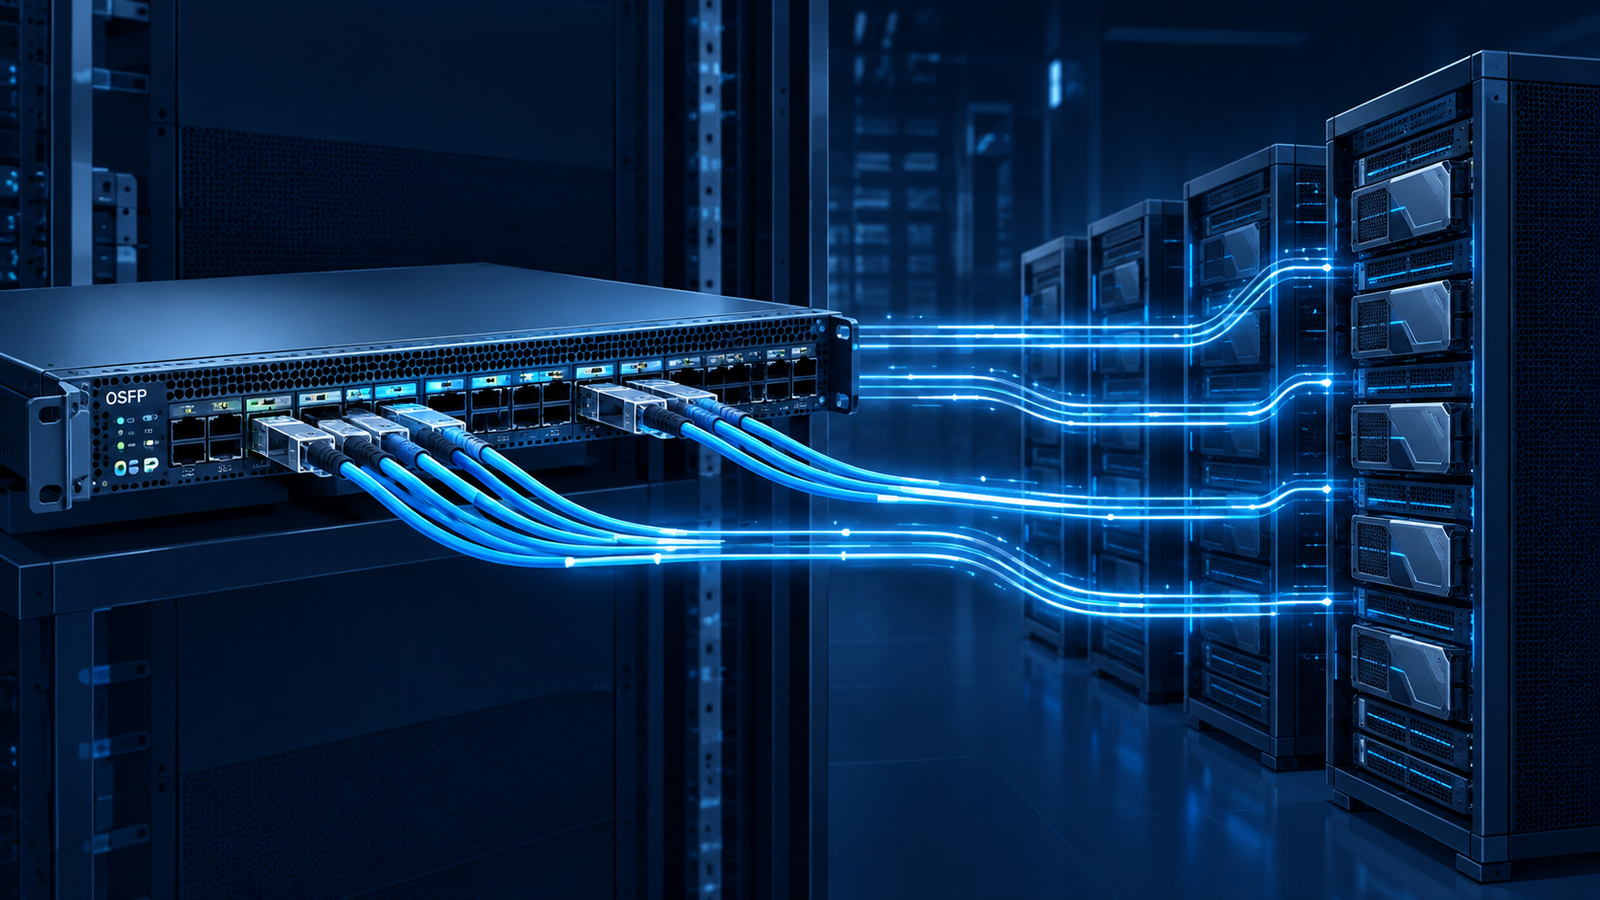
O núcleo da oferta atual é o switch NVIDIA Quantum-2 QM9700, que entrega 64 portas de 400Gb/s por meio de 32 conectores OSFP, com capacidade agregada de comutação de 51,2 terabits por segundo (Tb/s) e mais de 66,5 bilhões de pacotes por segundo. Existem versões com resfriamento a ar (QM9700) e a líquido (QM9790) para densidades mais altas.
Do lado dos adaptadores, o NVIDIA ConnectX-7 é o host channel adapter (HCA) padrão para essa geração, suportando InfiniBand NDR 400Gb/s (além de modos HDR 200G e EDR 100G para compatibilidade retroativa), com interface PCIe 4.0/5.0 x16. Cada sistema DGX H100, por exemplo, utiliza oito conexões NDR400 dedicadas à fabric de computação — ilustrando o nível de paralelismo de rede exigido por servidores de IA densos em GPU.
A arquitetura suporta topologias flexíveis — Fat Tree, Dragonfly+ e Torus multidimensional — e inclui a terceira geração da tecnologia SHARP (Scalable Hierarchical Aggregation and Reduction Protocol), que realiza agregação de dados diretamente na rede, reduzindo tráfego e acelerando operações coletivas de treinamento distribuído. Engines de hardware para aceleração de MPI_Alltoall, roteamento adaptativo, controle de congestionamento e capacidades de auto-recuperação da fabric completam o conjunto de recursos que diferenciam o InfiniBand de soluções Ethernet tradicionais.
4. Implementação Estratégica: Como Planejar a Adoção
A primeira decisão prática é definir o gerenciamento da fabric: switches Quantum-2 podem operar com subnet manager interno (bringup simplificado para até 2.000 nós) ou serem gerenciados externamente via NVIDIA Unified Fabric Manager (UFM), que centraliza provisionamento, monitoramento em tempo real, diagnóstico e troubleshooting proativo — essencial em ambientes de produção com SLA rígido.
A segunda consideração é a topologia física e o plano de cabeamento. Como cada porta OSFP pode ser desdobrada (breakout) em portas de 200G, o planejamento do fan-out impacta diretamente a densidade de racks e a estratégia de refrigeração — especialmente em implantações que combinam GPUs de alta densidade térmica com switches de alta capacidade de comutação.
Por fim, é fundamental mapear a interoperabilidade com sistemas existentes: fabrics NDR 400G mantêm compatibilidade retroativa com infraestrutura de 200G e 100G, o que permite expansão incremental de clusters legados sem necessidade de rip-and-replace completo — uma consideração de custo relevante para empresas que já possuem investimento em InfiniBand HDR.
5. Melhores Práticas e o Contexto Competitivo com Ethernet
Nenhuma decisão sobre InfiniBand 400G pode ser tomada isoladamente do movimento de mercado em direção ao Ethernet de alta performance. Dados da Dell’Oro Group mostram que 2025 marcou um ponto de inflexão decisivo, com o Ethernet ultrapassando o InfiniBand em adoção nas redes back-end de IA — uma reviravolta expressiva considerando que, apenas dois anos antes, o InfiniBand respondia por quase 80% das vendas de switches de data center em redes back-end de IA.
Ainda assim, o InfiniBand não está em declínio absoluto: as vendas de switches InfiniBand voltaram a crescer no primeiro trimestre de 2026, puxadas por clusters de nova geração baseados em GPUs Blackwell e pela adoção de tecnologia 800G. A leitura estratégica correta não é “InfiniBand versus Ethernet” como escolha binária, mas sim entender que o InfiniBand mantém liderança técnica em HPC e em cargas de treinamento que exigem comunicação extremamente intensa entre processadores, enquanto o Ethernet — impulsionado pela especificação Ultra Ethernet Consortium (UEC) 1.0 — ganha terreno em hyperscalers que priorizam custo, familiaridade operacional e abertura de ecossistema.
Do ponto de vista de governança e compliance, a maturidade do ecossistema de cabos e ópticas 400G reduz riscos de fornecimento e permite negociação com múltiplos fornecedores (NVIDIA/Mellanox, além de parceiros como FS.com e NADDOD para componentes de terceiros compatíveis), mitigando dependência de fornecedor único — um ponto relevante em auditorias de risco de infraestrutura crítica.
6. Medição de Sucesso: Métricas que Importam
Para validar o retorno do investimento em uma fabric InfiniBand 400G, as métricas mais relevantes vão além da largura de banda nominal. O indicador central deve ser a eficiência de utilização de GPU (GPU utilization rate) durante treinamento distribuído — quanto mais próxima de 100%, menor o desperdício de capacidade computacional aguardando sincronização de rede.
Métricas técnicas complementares incluem latência ponta a ponta medida sob carga real (não apenas em benchmark isolado), taxa de perda de pacotes em operações RDMA, e throughput efetivo em operações coletivas MPI (all-reduce, all-to-all) comparado ao throughput teórico dos 400Gb/s por porta. No nível de negócio, o indicador que efetivamente importa para o CFO é o custo por hora de treinamento concluído — métrica que combina eficiência de rede, utilização de GPU e custo total de propriedade (TCO) da fabric.
Conclusão
O InfiniBand 400G NDR, sustentado pela plataforma NVIDIA Quantum-2 e pelos adaptadores ConnectX-7, permanece em 2026 a opção tecnicamente mais robusta para organizações cujas cargas de trabalho de IA e HPC dependem de latência ultrabaixa e comunicação coletiva intensiva entre GPUs. Ao mesmo tempo, o avanço real do Ethernet de alta performance no mercado de redes back-end de IA exige que decisões de infraestrutura sejam tomadas com base no perfil específico da carga de trabalho — e não apenas em inércia de mercado ou preferência histórica.
Para novas implantações em escala Blackwell, o roadmap aponta para o Quantum-X800 (XDR 800G) como plataforma de maior longevidade, enquanto o Quantum-2 NDR 400G segue como opção madura e custo-otimizada para clusters de geração Hopper ou ambientes que priorizam um ecossistema de fornecimento consolidado. Antes de comprometer orçamento com qualquer geração futura ainda não lançada comercialmente, recomenda-se tratar essas tecnologias como planejamento de roadmap, e não como opção de aquisição imediata.
Como próximo passo prático, recomenda-se que equipes de infraestrutura realizem um mapeamento do perfil de comunicação das cargas de trabalho atuais e planejadas — treinamento distribuído, inferência, simulações HPC — antes de dimensionar a fabric de rede, garantindo que o investimento em InfiniBand 400G (ou sua alternativa) esteja alinhado ao real gargalo de desempenho da organização.