GPU para Computer Vision: Guia Estratégico Empresarial 2026
Computer Vision com GPU: Como Estruturar Infraestrutura de Visão Artificial para Escala Empresarial
A visão computacional deixou de ser um experimento de laboratório e se tornou infraestrutura crítica de operação. Em 2026, o mercado de IA aplicada a computer vision já supera a casa dos US$ 28 a 35 bilhões, com projeções que o levam a ultrapassar US$ 100 bilhões até o início da próxima década — crescimento sustentado, segundo analistas do setor, pela democratização do acesso a poder computacional de GPU e pela maturidade das plataformas de treinamento e inferência.
Para líderes de tecnologia, a pergunta não é mais “devemos adotar visão computacional?”, mas “que arquitetura de GPU sustenta essa operação sem estourar o orçamento nem comprometer a latência?”. Empresas que adiam essa decisão pagam um preço direto: linhas de produção com inspeção manual sujeitas a taxas de erro que ultrapassam 25% ao final de turnos longos, operações de segurança sem monitoramento em tempo real e sistemas de automação que não conseguem competir com concorrentes já operando em ciclos de decisão abaixo de 200 milissegundos por unidade processada.
Este guia examina os fundamentos técnicos da GPU aplicada a computer vision, as decisões estratégicas de arquitetura (nuvem, borda ou híbrido), os principais pontos de falha na implementação e as métricas que comprovam retorno sobre investimento.
1. O Problema Estratégico: Visão como Gargalo Operacional
A maioria das organizações ainda trata inspeção visual, monitoramento e reconhecimento de padrões como tarefas humanas por padrão, escalando-as apenas com mais headcount. O problema é estrutural: atenção visual humana sustentada degrada previsivelmente. Estudos sobre tarefas de vigilância visual contínua mostram queda de 20 a 30% na precisão de detecção de defeitos após 30 minutos de inspeção ininterrupta, com taxas de falha que podem superar um quarto das ocorrências ao fim de um turno de oito horas.
Esse gargalo se torna mais grave à medida que o volume de dados visuais cresce. Câmeras industriais, sensores de linha e feeds de vídeo geram o que a indústria chama de “dark data” — volume massivo de imagem e vídeo que nunca é analisado de forma sistemática porque não existe capacidade computacional dedicada para processá-lo em tempo real. Empresas que conseguem converter esse dado ocioso em insight acionável reportam ganhos de eficiência operacional na faixa de 15% a 25%, segundo relatórios recentes do setor de IoT industrial.
O segundo componente estratégico é a pressão competitiva regional. Mercados como Ásia-Pacífico já respondem por mais de 40% da receita global de hardware de visão computacional, impulsionados por políticas industriais agressivas — a Coreia do Sul planeja consórcios com centenas de milhares de GPUs até 2027, enquanto a China já exige inspeção de qualidade por IA em dezenas de milhares de fábricas inteligentes. Organizações que não têm uma estratégia de GPU para visão computacional competem, na prática, contra concorrentes com custo operacional estruturalmente menor.
Por fim, há a dimensão de dados como ativo. Um pipeline de visão computacional bem arquitetado não apenas detecta um defeito — ele gera metadados serializados, rastreáveis e auditáveis, que alimentam manutenção preditiva, análise de causa raiz e pontuação de fornecedores. Empresas que tratam a GPU apenas como “câmera mais inteligente” perdem esse valor composto de dados estruturados ao longo do tempo.
2. As Consequências da Inação
Adiar a modernização da infraestrutura de visão computacional tem custo mensurável, não apenas competitivo. No setor manufatureiro, taxas de refugo (scrap) que hoje giram entre 2% e 3% em linhas com inspeção manual ou por regras fixas caem para menos de 1% em plantas que adotaram inspeção por CNN e detecção de anomalias em GPU — a diferença, multiplicada pelo volume de produção anual, costuma representar payback de projeto em 6 a 12 meses.
Existe também um risco de compliance crescente. Setores regulados (farmacêutico, automotivo, eletrônico) já demandam logs de inspeção serializados e integrados a sistemas MES/ERP/PLC como evidência de conformidade com normas ISO, IATF e FDA. Empresas que ainda dependem de inspeção manual não têm como produzir essa trilha de auditoria de forma consistente, o que se torna passivo em auditorias de cliente e processos regulatórios.
Há ainda o custo de oportunidade em segurança e continuidade operacional. Sistemas de visão em borda hoje monitoram ativos 24 horas por dia sem fadiga, identificando falhas incipientes antes que se tornem paradas não planejadas. Organizações que dependem de rondas humanas periódicas simplesmente não capturam eventos que ocorrem fora da janela de inspeção — e cada parada não planejada tem custo direto em produção perdida, hora extra e frete expresso para recuperação de prazo.
Finalmente, existe uma desvantagem competitiva de talento e velocidade de inovação. Equipes que ainda validam qualidade manualmente gastam ciclos de engenharia em tarefas repetitivas, enquanto concorrentes já usam esse tempo para iteração de produto e melhoria contínua de processo — a diferença se acumula trimestre após trimestre.
3. Fundamentos Técnicos: Como a GPU Sustenta Visão Computacional
O hardware é, hoje, o componente que mais pesa na conta de computer vision: análises de mercado indicam que a categoria de hardware — sensores, memória e, principalmente, processadores gráficos — responde por mais de 60% da receita do setor de IA aplicada a visão, com a GPU isoladamente liderando entre os tipos de processador utilizados em sistemas de inspeção industrial.
A razão é arquitetural. Redes neurais convolucionais (CNNs) e, mais recentemente, vision transformers (ViTs) dependem de operações matriciais massivamente paralelas — exatamente o tipo de carga para a qual a arquitetura de GPU foi desenhada, com milhares de núcleos operando simultaneamente sobre tensores de imagem. CPUs conseguem executar esses mesmos modelos, mas em ordens de grandeza mais lentas, inviabilizando qualquer aplicação que exija decisão em tempo real — como uma linha de produção rodando a 60 unidades por minuto, cuja janela de decisão por peça é medida em dezenas de milissegundos.
A escolha entre GPU de data center e GPU de borda define a arquitetura de todo o sistema. Placas como a NVIDIA H100, H200 e a geração Blackwell (B200/B300) são otimizadas para treinamento de modelos e inferência em lote de alto volume, tipicamente hospedadas em nuvem ou data center próprio. Já a linha Jetson — com os módulos Orin e a nova geração Thor baseada em Blackwell — foi desenhada para inferência local, embarcada diretamente em câmeras, robôs e estações de linha, entregando até 2.070 TFLOPS em FP4 com consumo de 40 a 130 W, cerca de 7,5 vezes o desempenho de IA da geração Orin anterior, segundo dados divulgados pela NVIDIA.
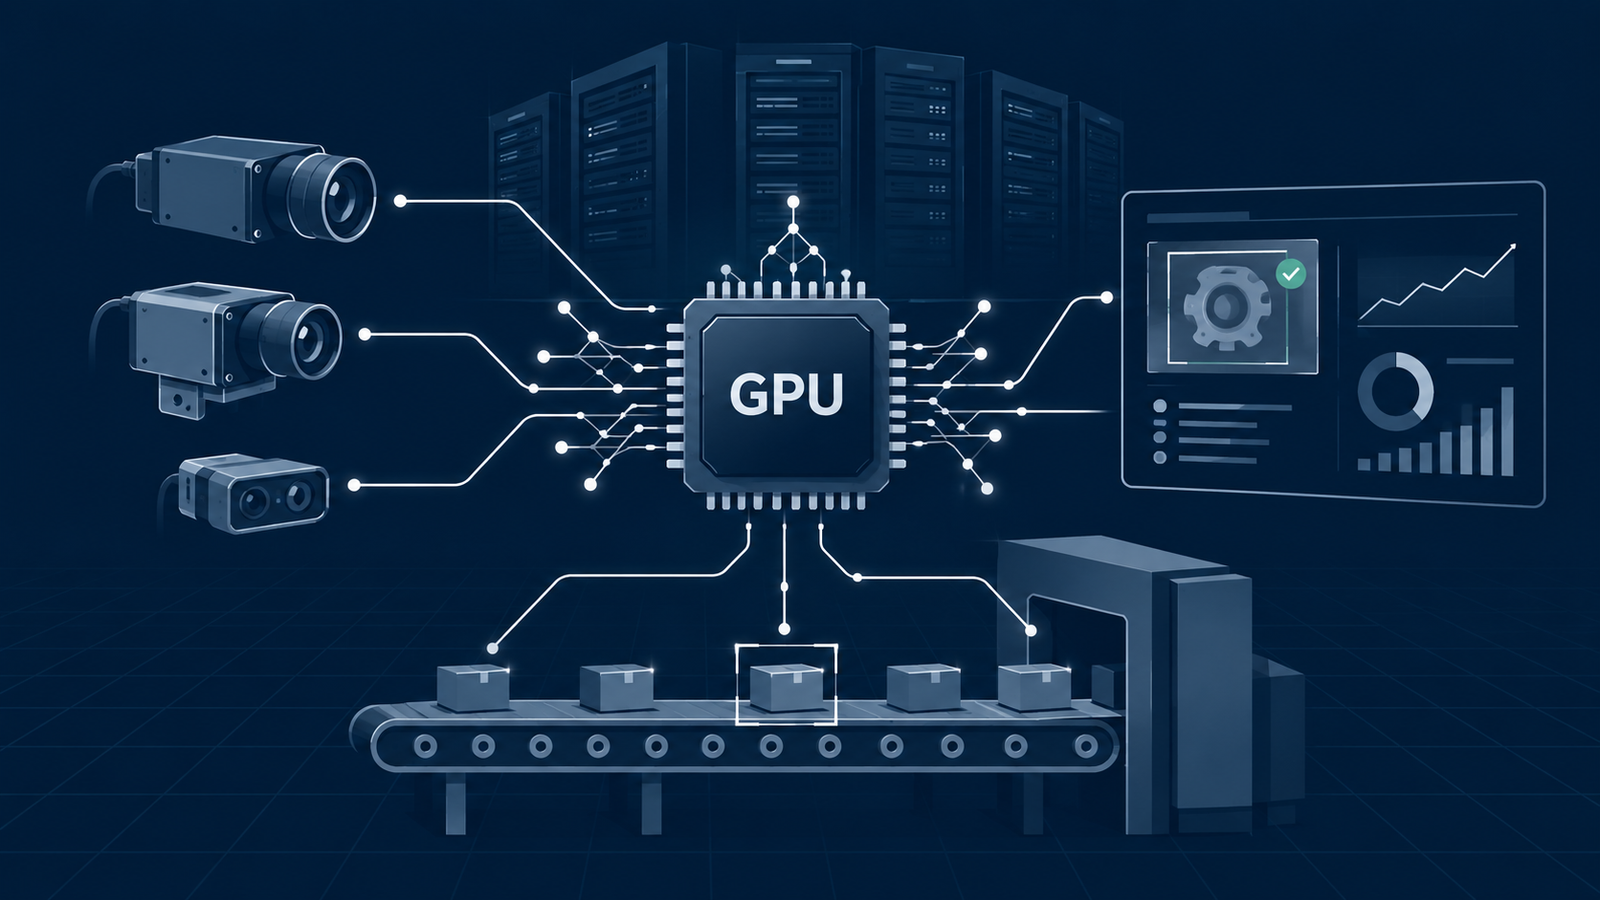
Essa divisão não é apenas técnica, é econômica. Processar visão computacional inteiramente na nuvem implica custo recorrente por hora de GPU e latência de rede — inaceitável para aplicações de segurança ou controle de qualidade em tempo real. Processar inteiramente na borda implica maior custo de hardware distribuído e complexidade operacional de manter dezenas ou centenas de dispositivos atualizados. A maioria das arquiteturas maduras em 2026 é híbrida: treinamento e re-treinamento de modelos em GPU de data center (nuvem ou on-premise), com inferência final rodando em GPU embarcada na borda.
4. Implementação Estratégica: Da Prova de Conceito à Produção
A primeira decisão crítica de implementação é o dimensionamento de GPU para a fase certa do ciclo de vida do modelo. Treinamento inicial e re-treinamento periódico com novos dados exigem GPUs de alta capacidade de memória — H100 (80 GB), H200 (141 GB) ou B200 (até 192 GB) — normalmente alugadas por hora em provedores de nuvem especializados, já que o investimento em hardware próprio só se justifica com utilização sustentada e previsível. Preços de mercado em 2026 mostram grande dispersão: H100 SXM disponível a partir de aproximadamente US$ 2,00/hora em provedores especializados, chegando a US$ 6 ou mais por hora em pacotes de hyperscaler; H200 varia de cerca de US$ 2,00 a mais de US$ 13 por hora dependendo do provedor e do modelo de contratação.
A segunda decisão é a topologia de inferência em produção. Para aplicações que não exigem latência sub-100ms (análise de vídeo em lote, relatórios de conformidade), inferência em nuvem é viável e mais simples de operar. Para inspeção de qualidade em linha, segurança física e robótica, a inferência precisa acontecer localmente — o que exige dimensionar corretamente entre módulos de borda como Jetson Orin Nano (para cargas leves, 7 a 25 W) até Jetson Thor (para modelos multimodais complexos, incluindo visão-linguagem-ação, em robótica avançada).
Um ponto de falha recorrente em projetos de visão computacional é subestimar o custo total de propriedade além do preço nominal da GPU. Instâncias de nuvem empacotadas cobram por CPU e memória ociosos junto com a GPU; tráfego entre nós de rede pode gerar custos adicionais de “cross-AZ”; e armazenamento de alta performance para carregar modelos via NVMe é frequentemente esquecido no orçamento inicial. Projetos que fazem esse levantamento completo antes da contratação evitam surpresas de 30% a 60% no custo real mensal frente ao valor anunciado por hora de GPU.
Outro ponto crítico é a integração com sistemas legados. A maior parte do valor de negócio de um sistema de visão computacional só se realiza quando ele se conecta a MES, ERP e controladores PLC para acionar mecanismos automáticos de rejeição, alimentar dashboards e disparar alertas de manutenção. Projetos que tratam a GPU como componente isolado, sem essa integração desde o desenho inicial, tendem a ficar presos em fase de prova de conceito indefinidamente.
5. Melhores Práticas Avançadas: Governança, Segurança e Otimização
Em ambientes de produção, a técnica de Multi-Instance GPU (MIG), disponível nas gerações Hopper e Blackwell, permite particionar uma única GPU física em múltiplas instâncias isoladas — útil para rodar simultaneamente diferentes modelos de visão (detecção de defeito, contagem de itens, verificação dimensional) sem contratar hardware dedicado para cada tarefa. Essa prática reduz ociosidade de GPU e melhora sensivelmente o custo por inferência em cenários com múltiplos modelos de baixa e média complexidade.
Otimização de precisão numérica é outra alavanca frequentemente subutilizada. Modelos convertidos para operar em INT8 ou FP8, via frameworks como TensorRT, mantêm precisão de detecção praticamente equivalente ao modelo original em FP32, ao mesmo tempo em que multiplicam o throughput de inferência e reduzem o consumo energético — fator relevante tanto para custo operacional quanto para metas de sustentabilidade corporativa.
Em termos de governança e compliance, sistemas de visão computacional que operam sobre dados de produção — especialmente em ambientes com pessoas, como linhas com colaboração humano-robô — exigem camadas de segurança funcional dedicadas. A NVIDIA, por exemplo, oferece pilha de software específica (Halos for Robotics) para certificação de segurança em cenários onde robôs operam próximos a operadores humanos, um requisito cada vez mais presente em normas de segurança industrial.
Segurança de dados também merece atenção estruturada: feeds de câmera frequentemente capturam informação sensível (rostos de colaboradores, dados de propriedade intelectual visível em linha de produção). Arquiteturas que processam inferência na borda, sem transmitir vídeo bruto para a nuvem, reduzem superfície de exposição e simplificam conformidade com regulações de privacidade — um argumento adicional, além do de latência, a favor de arquiteturas híbridas com processamento local.
6. Medição de Sucesso: Métricas que Importam
O indicador técnico mais direto é a precisão de detecção do modelo em produção — não em ambiente de teste. Implementações maduras de inspeção visual industrial reportam consistentemente acurácia acima de 99% após período de calibração, com decisão por unidade abaixo de 200 milissegundos em sistemas de borda bem dimensionados.
No lado de negócio, a métrica mais relevante é a taxa de escape de defeito (defect escape rate) — quantos itens defeituosos passam pela inspeção sem serem detectados. Reduções de 30% a 40% nessa taxa são comumente reportadas em implementações bem executadas, com impacto direto em garantia, devolução e reputação de marca.
Métricas de infraestrutura completam o quadro: utilização média de GPU (uma GPU subutilizada é orçamento desperdiçado), custo por inferência (fundamental para justificar ROI perante liderança financeira) e tempo médio entre falhas de hardware em ambiente de borda, que costuma ser mais crítico em plantas industriais com poeira, vibração e variação térmica.
Por fim, o indicador que conecta tecnologia a estratégia é o tempo de payback do projeto. A maioria dos casos documentados de inspeção visual por GPU em manufatura atinge retorno total do investimento entre 6 e 12 meses — janela que deve ser o benchmark padrão usado para aprovar ou rejeitar novos projetos de visão computacional na organização.
Conclusão
A infraestrutura de GPU para computer vision deixou de ser uma escolha técnica isolada e se tornou decisão de arquitetura de negócio. A dispersão de preços entre provedores de nuvem, a divisão entre processamento em data center e em borda, e a complexidade de integração com sistemas legados exigem que essa decisão seja tomada com a mesma rigidez estratégica aplicada a qualquer investimento de infraestrutura crítica.
As organizações que mais se beneficiam não são necessariamente as que compram a GPU mais potente disponível, mas as que dimensionam corretamente cada camada — treinamento em nuvem, inferência na borda, precisão numérica otimizada — para o problema específico que estão resolvendo. Essa disciplina de dimensionamento é o que separa projetos de visão computacional que escalam de projetos presos permanentemente em fase piloto.
Olhando adiante, a convergência entre visão computacional e modelos multimodais (visão-linguagem-ação) promete expandir radicalmente o escopo de aplicações viáveis em borda, à medida que gerações futuras de GPU embarcada tragam mais capacidade de processamento por watt. Empresas que constroem hoje uma base de dados de inspeção estruturada e uma arquitetura de GPU flexível estarão em posição de capturar esse próximo salto sem precisar reconstruir a infraestrutura do zero.
O próximo passo prático é mapear os pontos de maior custo de inação na operação atual — inspeção manual, monitoramento sem cobertura contínua, dados visuais não analisados — e dimensionar um piloto de GPU (nuvem, borda ou híbrido) sobre o ponto de maior impacto comprovável em 90 dias.