Guia Estratégico para Empresas 2026
Em 2026, treinar ou adaptar um modelo de linguagem deixou de ser um projeto de laboratório e passou a ser uma decisão de arquitetura corporativa. O custo dos modelos de fronteira continua subindo, mas o custo de adaptar modelos abertos caiu de forma expressiva. Entre esses dois extremos existe um espaço amplo de escolhas, e a maioria das empresas ainda decide sem métricas claras.
O desafio é triplo: técnico (GPUs, dados, método), financeiro (orçamento previsível para um processo naturalmente incerto) e regulatório (dados pessoais em datasets de treinamento sob a LGPD). Errar em qualquer eixo custa caro, seja em semanas de GPU desperdiçadas, seja em um modelo que não entrega valor de negócio.
Este guia percorre o problema estratégico, o custo da inação, os fundamentos técnicos, a implementação, as melhores práticas e a medição de sucesso. Todos os números foram pesquisados em setembro de 2026; quando são estimativas de terceiros, isso está indicado.
O problema estratégico: treinar, adaptar ou apenas consumir?
Três caminhos com custos muito diferentes
A pergunta “vamos treinar nosso próprio LLM?” esconde três decisões distintas. Consumir um modelo hospedado via API exige apenas engenharia de prompt e integração. Adaptar um modelo aberto com fine-tuning ou pós-treinamento exige dados e GPUs por horas ou dias. Treinar do zero (pré-treinamento) exige clusters por semanas e equipes especializadas.
Segundo análise da SpendArk (junho de 2026), o pré-treinamento de um modelo pequeno custa de US$ 85 mil a US$ 500 mil em GPU, enquanto modelos de fronteira custam dezenas de milhões ou mais. Já o fine-tuning de um modelo de 7B fica na casa de dezenas a poucas centenas de dólares em execuções simples. A diferença de ordens de grandeza é o primeiro filtro de qualquer projeto.
Para contexto histórico, a Epoch AI estima que o custo de treinamento dos modelos mais capazes cresce entre 2 e 3 vezes por ano há cerca de oito anos. O Llama 3.1 405B, por exemplo, ficou em torno de US$ 170 milhões em computação. Esses números explicam por que pré-treinar do zero só faz sentido em casos muito específicos.
O que o custo “de manchete” não mostra
O valor de US$ 5,6 milhões divulgado para o DeepSeek V3 (2,79 milhões de GPU-horas) cobre apenas a execução final de treinamento. Ele não inclui experimentos, falhas, dados nem pessoal. A Epoch AI, citada em análise da Capital & Compute (julho de 2026), estima que laboratórios de fronteira gastem 40% a 60% do orçamento de computação em experimentos que não geram o modelo final.
Na prática, isso significa que um orçamento baseado em uma única execução limpa subestima o custo real. Varreduras de hiperparâmetros, reexecuções por mudança de dados e avaliações consomem GPU-hora sem produzir entregável visível. Projetos corporativos menores sofrem do mesmo efeito, em escala proporcional.
Consequências da inação e da decisão errada
Riscos de não treinar nem adaptar nada
Empresas que mantêm todo o uso de IA em modelos genéricos ficam presas a preço, latência e privacidade definidos por terceiros. Fluxos agênticos podem disparar de 10 a 20 chamadas de LLM por tarefa, segundo levantamento da Oplexa (março de 2026), o que faz a fatura de inferência crescer mesmo com o preço por token em queda. Um modelo menor e adaptado ao domínio pode reduzir esse custo de forma sustentável.
Há também o risco competitivo: concorrentes que codificam conhecimento de domínio em modelos próprios entregam respostas mais consistentes, com formato e vocabulário corretos, e reduzem retrabalho humano. A vantagem se acumula com os dados proprietários que alimentam ciclos sucessivos de melhoria.
Riscos de treinar sem método
O erro inverso é igualmente comum. Consultorias apontam que muitas equipes fazem fine-tuning, gastam semanas e milhares de dólares em GPU e só então descobrem que prompt e RAG resolveriam o problema. Sem um conjunto de avaliação definido antes do treinamento, não há como provar ganho.
Um segundo risco é a obsolescência: embutir conhecimento factual nos pesos de um modelo o deixa desatualizado quando a base muda. Por isso a divisão de trabalho recomendada é fine-tuning para forma e RAG para conteúdo, discutida adiante.
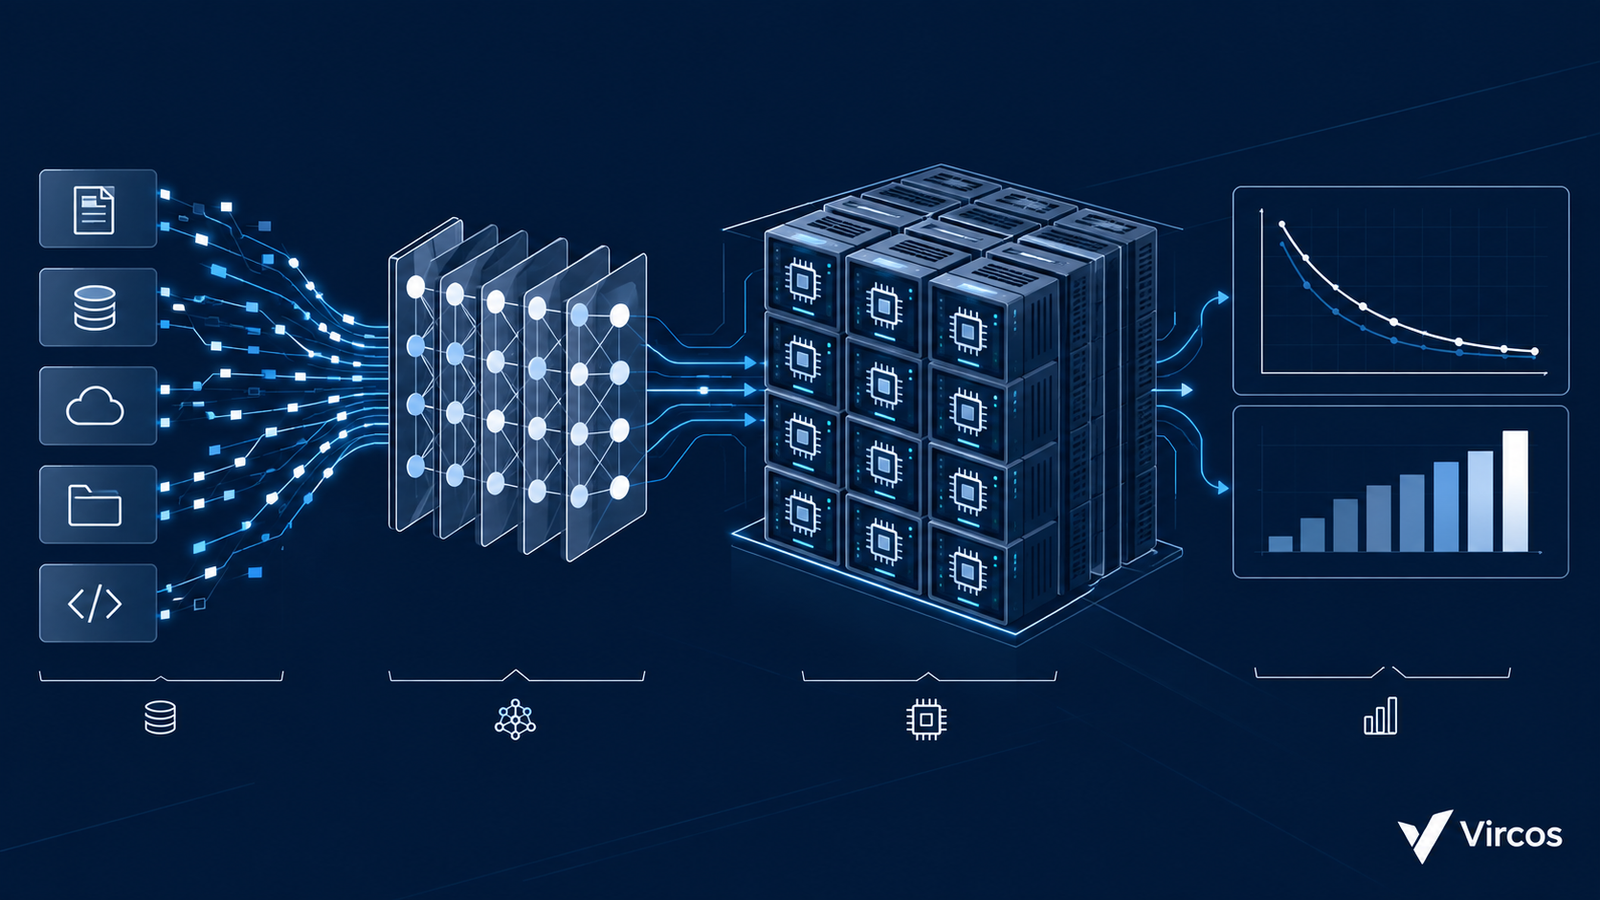
Fundamentos da solução: as etapas do treinamento de um LLM
Pré-treinamento: a base de capacidade
No pré-treinamento, o modelo aprende a prever o próximo token sobre volumes massivos de texto, produzindo um modelo base. O International AI Safety Report 2026 descreve essa etapa como altamente intensiva em dados e computação. Nela se define a capacidade geral, e é a etapa que quase nenhuma empresa deve repetir.
Um dado relevante sobre eficiência: pesquisa em arXiv citada pela AI Superior indica que, em pré-treinamento padrão, GPUs operam com utilização de apenas 30% a 50%. Otimizar paralelismo, comunicação e carregamento de dados é, portanto, tão importante quanto comprar mais hardware.
Pós-treinamento: onde a capacidade útil é moldada
O pós-treinamento combina ajuste supervisionado (SFT), otimização de preferências e aprendizado por reforço. Análise da LLM Stats (março de 2026) aponta que técnicas como GRPO, DAPO e RLVR passaram a dominar a pilha em modelos lançados no último ano. O RLVR (aprendizado por reforço com recompensas verificáveis) treina em tarefas cuja correção pode ser checada automaticamente, como matemática e execução de código.
Essa mudança aparece nos orçamentos. Análise da Epoch AI, relatada em setembro de 2026, indica que o GPT-5 usou menos computação de pré-treinamento que o GPT-4.5, com gasto migrando para o pós-treinamento. O treinamento deixa de ser uma execução monolítica e vira um programa contínuo.
Dados sintéticos também ganham peso. Segundo o International AI Safety Report 2026, seu uso torna essa fase menos intensiva em trabalho humano. O risco é a circularidade: o modelo aprende com o que ele mesmo gerou, o que exige verificação rigorosa.
Fine-tuning eficiente: LoRA e QLoRA
O LoRA treina pequenas matrizes adaptadoras, cerca de 0,1% a 1% dos parâmetros, sobre pesos congelados. O QLoRA quantiza o modelo base para 4 bits e treina adaptadores sobre ele, tornando viável ajustar modelos de 70B em uma única GPU de 80 GB. Estimativas de mercado apontam que o QLoRA atinge cerca de 90% da qualidade do fine-tuning completo.
A sequência recomendada por práticas de 2026 é prompt, depois RAG, depois fine-tuning e, por fim, destilação. O fine-tuning é indicado para tom, saída estruturada, vocabulário de domínio e formato de chamada de ferramentas. Um piso prático citado é ter tarefa estável, avaliação real e 500 ou mais exemplos de qualidade.
Implementação estratégica: infraestrutura, método e pontos de falha
Escolha de hardware e o efeito Blackwell
Na infraestrutura, a geração Blackwell mudou o cálculo. No MLPerf Training v6.0 (junho de 2026), a NVIDIA registrou recordes com o GB300 NVL72 nos novos benchmarks DeepSeek-V3 671B e GPT-OSS-20B, escalando até 8.192 GPUs. Nos mesmos testes, o GB300 foi até 1,6 vez mais rápido que o GB200 na mesma escala.
Em rodadas anteriores, a NVIDIA reportou aceleração cumulativa de 4,2 vezes do GB300 sobre Hopper em escala de 512 GPUs. Como são resultados submetidos pelos próprios fornecedores, vale validar com sua carga real. Uma referência independente da WhiteFiber (agosto de 2026) sugere ganho de 2 a 3 vezes do B200 sobre H100/H200 em treinamento na prática.
Há um contraponto de custo. O aluguel mediano de H100 em nuvem estava perto de US$ 3,38 por hora em meados de 2026, contra mais de US$ 7 no início de 2024, segundo a GC Tech Allies. Para muitos projetos de fine-tuning, Hopper ainda é a opção de melhor custo-benefício.
Comparativo de estratégias
| Estratégia | Quando usar | Ordem de custo (estimativas 2026) | Risco principal |
|---|---|---|---|
| Prompt + RAG | Conhecimento atualizado, tarefas gerais | Baixo (inferência) | Custo de tokens e latência |
| LoRA / QLoRA | Formato, tom, vocabulário de domínio | US$ 400 a 1.200 por execução (13B, 50 mil exemplos) | Dados fracos, sem avaliação |
| Fine-tuning completo (70B) | Ganho máximo em domínio estreito | US$ 15 mil a 60 mil por execução | Esquecimento, custo |
| Pré-treino do zero | Soberania total, requisitos únicos | US$ 85 mil a centenas de milhões | Orçamento e equipe |
Fontes dos custos de fine-tuning: Sthambh (abril de 2026) e SpendArk (junho de 2026); são estimativas que variam com dataset e provedor.
Pontos de falha mais comuns
O primeiro é o sobreajuste: treinar por muitas épocas faz o modelo decorar exemplos. Guias práticos recomendam começar com uma época e usar parada antecipada quando a perda de treino cai e a de validação sobe. O segundo é a instabilidade por taxa de aprendizado mal calibrada, que faz a perda oscilar ou o treino se arrastar.
O terceiro é a falta de tolerância a falhas. Instâncias spot podem reduzir o custo de treinamento em 60% a 70% frente ao sob demanda, segundo a SpendArk, desde que o job grave checkpoints a cada 15 a 30 minutos. Sem isso, cada interrupção destrói horas de computação.
Melhores práticas avançadas: dados, governança e segurança
Qualidade de dados antes de volume
Em pós-treinamento, o gargalo histórico é o dado. Pesquisas de 2026 sobre RLVR mostram ganhos com conjuntos muito pequenos: uma técnica chamada FEST usa apenas 128 demonstrações amostradas aleatoriamente, e trabalhos anteriores mostram RLVR eficaz com um único exemplo em certos cenários. Isso não elimina a necessidade de curadoria, mas indica que qualidade e diversidade pesam mais que volume bruto.
Na prática, revise manualmente uma amostra (cerca de 100 exemplos), separe treino e avaliação (80/20) e padronize o formato antes de treinar. Esse trabalho braçal costuma decidir o resultado mais que a escolha do hiperparâmetro.
LGPD e governança de dados de treinamento
No Brasil, a IA é um dos quatro eixos do Mapa de Temas Prioritários 2026-2027 da ANPD, e a fiscalização já é real, com casos como a suspensão do uso de dados pela Meta para treinar IA, com multa diária de R$ 50 mil. A LGPD não distingue um banco de dados tradicional de um dataset de treinamento: é preciso base legal, minimização e relatório de impacto quando houver risco.
A base legal do legítimo interesse é discutida como via viável, pois o consentimento em escala impõe dificuldades práticas. Em abril de 2026, porém, a ANPD ainda declarava não ter posição definitiva sobre o tema. Também tramita o PL 2775/24, que propõe exigir consentimento prévio e expresso para treinar IA com dados pessoais. Trate qualquer conclusão como sujeita a mudança e consulte o jurídico.
Dados sintéticos não resolvem automaticamente a questão: relatos de mercado indicam que a ANPD ainda não emitiu orientação sobre se dados sintéticos derivados de dados pessoais herdam as obrigações da LGPD. Há ainda o risco de memorização, quando o modelo reproduz dados pessoais do treino. Documente origem, base legal e tratamento de cada fonte.
Segurança e propriedade intelectual
Adaptadores LoRA e checkpoints são ativos sensíveis, pois podem carregar informação proprietária. Controle acesso, versione artefatos e registre quem treinou o quê e com quais dados. Executar modelos abertos em infraestrutura própria também evita transferência internacional de dados, uma preocupação recorrente em setores regulados.
Medição de sucesso: métricas e indicadores
Avaliação técnica
Defina o conjunto de avaliação antes de treinar e mantenha-o fixo. Compare sempre com uma linha de base: o modelo original com prompt e RAG. Se o ganho não supera esse patamar de forma mensurável, o treinamento não se justifica.
Monitore perda de validação, taxas de acerto por tipo de tarefa, aderência ao formato de saída e regressões em capacidades gerais. Esses sinais detectam sobreajuste e esquecimento antes de a produção sofrer.
Indicadores de negócio e de eficiência
No lado financeiro, acompanhe custo total por modelo entregue (incluindo experimentos e falhas), custo por mil requisições em produção e utilização de GPU. Como os experimentos podem consumir parcela relevante do orçamento, registre-os como custo do projeto.
No lado do negócio, meça tempo de tarefa economizado, taxa de retrabalho e satisfação de quem usa. Um modelo menor, afinado ao domínio, deve reduzir custo de inferência e manter qualidade, e esse é o teste final de retorno.
Conclusão: um roteiro pragmático para 2026
O treinamento de LLM em 2026 é menos sobre comprar GPUs e mais sobre disciplina: escolher o nível certo de intervenção, medir antes de gastar e governar os dados. Para a maioria das empresas, o caminho de melhor retorno é prompt e RAG, depois um adaptador LoRA ou QLoRA em modelo aberto, mantendo o conhecimento factual fora dos pesos.
A tendência aponta para pós-treinamento contínuo, com aprendizado por reforço verificável e dados sintéticos, e para hardware Blackwell reduzindo o tempo de treino em escala. Ao mesmo tempo, a regulação brasileira de dados para IA deve ganhar contornos mais claros, então acompanhe a ANPD e o PL 2338/2023.