Guia Estratégico para Cargas de IA em 2026
Em 2026, o storage HPC deixou de ser um item de suporte na planilha de infraestrutura e passou a determinar se o investimento em GPUs gera retorno. Segundo a Hyperion Research, citada pela HPCwire (out/2025), o armazenamento adicional representava cerca de 21% do gasto on-premises em HPC na pesquisa global de 2023, com projeção de superar 22,4% até 2028. Era o elemento de crescimento mais rápido do orçamento.
O desafio é que as cargas mudaram de natureza. O treinamento de modelos combina milhões de leituras pequenas e aleatórias com gravações sequenciais massivas de checkpoints, enquanto a inferência com agentes de IA cria uma demanda nova: contexto persistente, o chamado cache KV. Um storage HPC desenhado apenas para simulação científica não foi pensado para esse conjunto.
O custo da decisão errada também subiu. De acordo com a TrendForce, os preços contratuais de SSDs empresariais subiram cerca de 80% no primeiro trimestre de 2026, e a oferta deve seguir restrita ao menos até 2027. Errar no dimensionamento agora significa pagar caro por capacidade flash que não entrega desempenho proporcional.
Este artigo analisa o problema estratégico, os riscos da inação, os fundamentos técnicos da solução, a implementação, as práticas avançadas e as métricas para avaliar se a sua arquitetura de storage para HPC está funcionando.
O problema estratégico: GPUs mais rápidas que o armazenamento
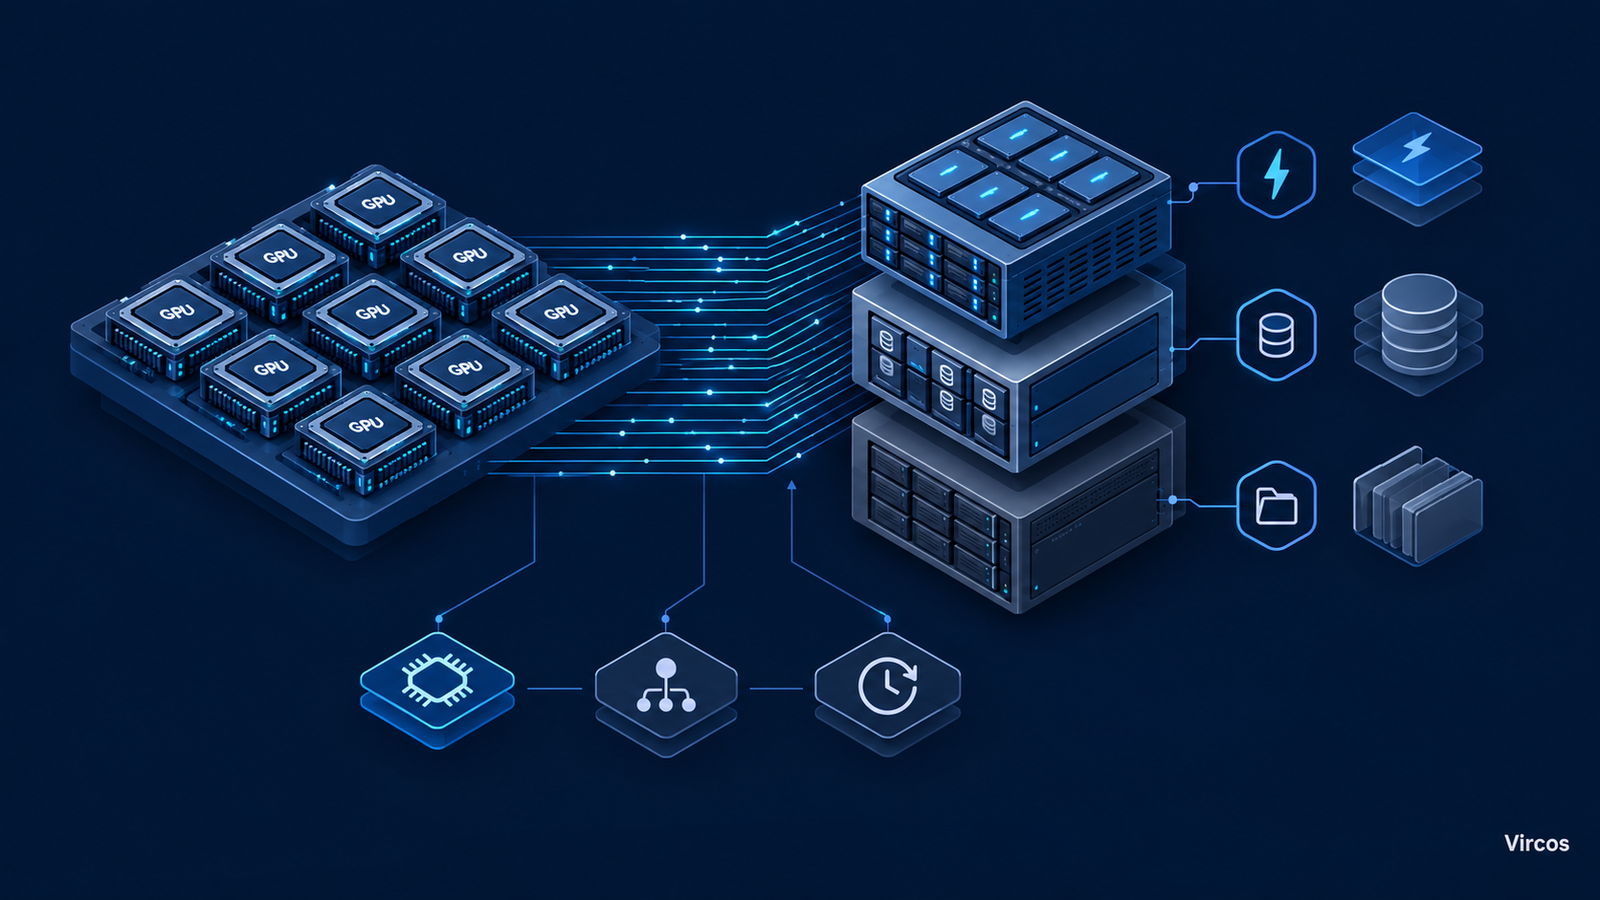
O gargalo central é simples de enunciar: aceleradores processam dados mais rápido do que a maioria dos sistemas de armazenamento consegue entregar. Quando isso acontece, a GPU fica ociosa entre um lote e outro, aguardando dados. O investimento mais caro do data center passa a operar abaixo da capacidade porque o componente mais barato não acompanha.
Um exemplo ilustrativo, usado em material técnico da Scality (2026), ajuda a dimensionar: em um cluster de 100 GPUs, 20% de ociosidade equivale a desperdiçar a capacidade de 20 GPUs. O número é hipotético, mas a lógica vale para qualquer ambiente. Cada ponto percentual de espera por I/O é capacidade de computação paga e não utilizada.
Dois padrões de I/O que competem entre si
A WEKA descreve o treinamento de IA como uma carga que exige, ao mesmo tempo, leituras pequenas e aleatórias no carregamento de dados e gravações sequenciais em escala de terabytes nos checkpoints. NAS, SAN e armazenamento de objetos tradicionais não foram projetados para sustentar os dois padrões simultaneamente. É por isso que o storage HPC baseado em sistema de arquivos paralelo voltou ao centro da conversa.
Christopher Davidson, vice-presidente de engenharia de desempenho de infraestrutura de HPC e IA da HPE, aponta dois gargalos atuais: I/O de arquivos pequenos e falta de multitenancy. Em outras palavras, no storage HPC atual o desafio não é mais só largura de banda. É também metadados, isolamento entre usuários e acesso multiprotocolo.
Mais camadas, mais complexidade
Enquanto o HPC tradicional operava com duas ou três camadas de armazenamento, muitas cargas de IA hoje usam quatro ou cinco, segundo a HPCwire. SSDs formam a camada de scratch, discos rígidos atendem a camada nearline para checkpoints e logs, e disco lento ou fita cobre o arquivamento. Cada camada adicional exige política de movimentação, monitoramento e governança.
Consequências da inação
Manter um storage HPC legado tem um custo direto e mensurável: GPUs subutilizadas. Como o treinamento passa a ser limitado por I/O e não por computação, prazos de projeto se estendem e o custo por experimento sobe. Para equipes que competem por tempo de máquina, isso significa menos iterações de modelo por trimestre.
Há também um risco de oportunidade. Segundo a HPCwire, as necessidades de armazenamento mudam quando o modelo entra em modo de inferência: o desempenho bruto continua importante, mas surgem requisitos de metadados, objetos e integração com pilhas de inferência. Quem construiu apenas para treinamento pode descobrir que a mesma infraestrutura não atende cargas agentivas.
O risco de comprar tarde em um mercado restrito
O cenário de preços agrava a inação. A TrendForce reportou que a receita de SSDs empresariais cresceu 86,1% no trimestre, para US$ 18,46 bilhões, enquanto os estoques dos principais fornecedores chegaram a níveis historicamente baixos. Fornecedores estão direcionando a capacidade existente aos produtos de servidor mais rentáveis, em vez de ampliar a oferta em 2026.
Na prática, adiar a decisão não garante preço menor. Analistas citados em fontes de mercado indicam alívio relevante apenas em 2027 ou depois. Empresas que dependem de flash para o storage HPC devem planejar compras com antecedência e avaliar contratos-quadro com fornecedores.
Fundamentos da solução: arquiteturas de storage HPC
A definição prática de sistema de arquivos paralelo, segundo artigo da HPCwire (mai/2026), é uma arquitetura distribuída na qual muitos clientes acessam dados diretamente e em paralelo em vários nós de armazenamento, com metadados entregues fora do caminho de dados, dentro de um único namespace. Nesse desenho, os clientes não passam por controladoras de front-end ou gateways. O desempenho escala de forma previsível conforme se adicionam nós, e esse é o núcleo de qualquer storage HPC de alto desempenho.
Esse princípio não se limita aos sistemas clássicos. O padrão Parallel NFS (pNFS), especialmente a versão 4.2, está presente nas principais distribuições Linux e permite abordagens baseadas em padrões abertos. A diferença de fundo está entre quem entrega acesso paralelo real e quem apenas escala capacidade atrás de um ponto de entrada.
O panorama de plataformas em 2026
Conforme a Scientific Computing World (jul/2026), os sistemas de arquivos paralelos continuam a escolha padrão de muitos ambientes, mas agora competem com sistemas all-flash scale-out, estruturas de nuvem híbrida e armazenamento definido por software. A tabela abaixo resume o perfil de algumas plataformas citadas em fontes recentes.
| Plataforma | Perfil arquitetônico | Observações relevantes |
|---|---|---|
| Lustre (ex.: HPE Cray ClusterStor) | Sistema de arquivos paralelo open source | Integra-se a Slingshot, InfiniBand e outras redes de supercomputação |
| IBM Storage Scale | Sistema paralelo com acesso a arquivos e objetos | Namespace global; análise e arquivamento no próprio local, em escala de exabytes |
| WEKA | Sistema escalável definido por software (WekaFS) | Suporta NFS, SMB e S3 |
| VAST Data | Plataforma de dados definida por software | Multiprotocolo: NFS, SMB, S3 e API Kafka |
| VDURA (PanFS) | Herdeira do sistema Panasas | Appliance all-flash V5000 lançado em 2025 |
| Hammerspace | Camada de dados baseada em pNFS | Namespace global sobre storage heterogêneo; fala S3 |
A convergência entre mundos
Segundo a HPCwire, fornecedores nascidos no HPC estão adaptando suas ofertas às novas cargas, enquanto os do mundo corporativo reforçam o desempenho bruto para treinamento. Há uma convergência para o meio. Um exemplo é o NetApp AFX, lançado em 2025, com arquitetura totalmente desagregada, resposta a uma desvantagem competitiva frente aos sistemas paralelos.
Um dado de contexto histórico: na pesquisa de 2022 da Hyperion, o Lustre respondia por 41% dos sistemas de arquivos paralelos, seguido do IBM Storage Scale com 17% e do WEKA com 6%. Esses números antecedem a onda de IA generativa e devem ser lidos como referência, não como retrato atual. Ainda assim, mostram por que Lustre e Storage Scale seguem como pontos de comparação obrigatórios.
Implementação estratégica: do treinamento à inferência
A implantação de storage HPC começa pela caracterização da carga, não pela escolha do produto. É preciso medir o perfil de I/O real: tamanho médio dos arquivos, proporção entre leitura e escrita, intensidade de operações de metadados e concorrência entre usuários. A Hammerspace alerta que muitas organizações medem largura de banda isoladamente, consideram-na adequada e só depois descobrem que a vazão real do treinamento fica abaixo do esperado.
O segundo passo é desenhar as camadas. Uma estratégia comum mantém dados quentes de treinamento em flash de alto desempenho e move experimentos concluídos para camadas de capacidade. Segundo a HPCwire, discos rígidos nearline seguem de quatro a cinco vezes mais baratos por gigabyte que SSDs, e isso sustenta a demanda por HDD em cargas de treinamento. O mesmo levantamento registrou prazos de entrega de HDDs nearline de alta capacidade acima de 52 semanas, segundo a TrendForce, o que também exige planejamento.
Checkpoints: onde o desenho aparece na conta
Checkpoints são um bom teste de arquitetura. O blog técnico da NVIDIA (jun/2026) indica velocidades de 2 a 10 GB/s em sistemas de arquivos de rede compartilhados como Lustre, GPFS e NFS, e de 15 a 50 GB/s ou mais com GPUDirect Storage e NVMe local. Um estudo operacional de pré-treinamento com 504 GPUs, publicado em 2026 no arXiv, observou utilização de GPU acima de 99% em treinamento estável, com quedas sincronizadas às gravações de checkpoint.
A consequência prática é adotar checkpoint em camadas: gravar primeiro em NVMe local, depois em sistema compartilhado e por fim em objeto. A NVIDIA também mostra que a compressão sem perdas com nvCOMP reduziu checkpoints entre 21% e 29% em modelos densos e do tipo mixture-of-experts. Vale testar na sua carga antes de generalizar.
Pontos de falha potenciais
Os erros mais comuns incluem dimensionar apenas por capacidade, ignorar metadados, subestimar a rede e comprar flash sem plano de camadas. GPUDirect Storage também não é solução universal. Como observa a Scality, em cargas limitadas por computação e não por entrega de dados, o ganho pode ser mínimo, e o GDS exige rede InfiniBand ou RoCE com placas compatíveis com GPUDirect RDMA.
Melhores práticas avançadas
A primeira prática em storage HPC para IA é tratar o cache KV como camada própria. Anunciada na CES 2026, a plataforma NVIDIA Inference Context Memory Storage, hoje chamada CMX, estende a memória da GPU para SSDs NVMe usando o processador BlueField-4. Segundo a NVIDIA, a plataforma pode elevar tokens por segundo e eficiência energética em até 5 vezes em comparação com armazenamento tradicional. Trata-se de alegação do fabricante, que deve ser validada em prova de conceito.
A arquitetura de referência descreve uma hierarquia: memória da GPU (G1), memória do host (G2), armazenamento local do nó (G3) e armazenamento de rede compartilhado (G4). Parceiros como IBM já publicaram integrações do Storage Scale com essa camada, e a WEKA oferece o Augmented Memory Grid para conectar clusters de GPU a sistemas NVMe em escala de petabytes. Como observa o Blocks & Files, um enclosure dedicado ao cache KV não precisa oferecer snapshots ou replicação, o que o diferencia do storage de dados persistentes.
Governança, multitenancy e segurança
O multitenancy virou requisito central. Na ISC 2026, a HPE anunciou suporte a multitenancy em computação, rede e armazenamento, com o argumento de que mesmo laboratórios nacionais atendem usuários com necessidades distintas. Para empresas, isso se traduz em isolamento entre equipes, cotas, qualidade de serviço e criptografia.
Um caso concreto vem do CSCS, centro suíço de supercomputação. Em testes de aceitação, a VAST Data atendeu às metas de desempenho com multitenancy e criptografia ativados, usando acesso multiprotocolo nativo e conexão direta à malha Slingshot, sem camada de gateway. O centro concluiu que a plataforma pode servir como scratch criptografado para HPC e IA.
Ao definir políticas, considere também soberania e conformidade: onde os dados residem, quem os acessa e como o hardware é desativado ao fim do ciclo de vida. Esses pontos pesam em setores regulados, como financeiro e saúde, e devem entrar no processo de compra desde o início.
Medição de sucesso: métricas e KPIs
Para avaliar o storage HPC, o principal indicador técnico é a utilização efetiva de GPU durante o treinamento. Se ela cai a cada checkpoint ou a cada carregamento de lote, o storage é o suspeito. Ferramentas como o DCGM da NVIDIA e o Nsight Systems ajudam a distinguir espera por dados de outros gargalos, como pré-processamento na CPU.
Outros KPIs técnicos relevantes incluem tempo de gravação e de restauração de checkpoint, operações de metadados por segundo, latência em percentis altos (p99) e, na inferência, tempo até o primeiro token. Essas métricas refletem o comportamento real da carga, ao contrário de IOPS isolados, que raramente representam o padrão de I/O de IA.
KPIs de negócio
Do lado do negócio, o indicador mais útil é o custo por GPU-hora efetiva, isto é, o custo total dividido pelas horas em que o acelerador realmente computou. Some a ele o tempo de conclusão dos projetos de treinamento, o número de experimentos por período e a taxa de ocupação de cada camada de armazenamento. Acompanhar esses números permite comparar alternativas com base em resultado, não em especificação de catálogo.
Estabeleça uma linha de base antes de qualquer mudança e repita a medição após cada fase da implantação. Sem isso, a avaliação de eficácia vira opinião. Com a base definida, também fica mais fácil justificar investimentos em um mercado de flash com preços elevados.
Conclusão: storage HPC como decisão de negócio
Os pontos centrais são claros. O storage HPC em 2026 precisa sustentar dois padrões de I/O opostos, operar em múltiplas camadas, oferecer multitenancy e, cada vez mais, atender à inferência com cache KV persistente. Sistemas de arquivos paralelos seguem como base para muitos ambientes, mas convivem com plataformas all-flash, pNFS e soluções definidas por software.
Ao implementar, comece pela caracterização da carga, desenhe camadas com critério e meça o resultado por utilização de GPU e custo por GPU-hora efetiva. Planeje as compras com antecedência, dado que a oferta de NAND deve permanecer restrita ao menos até 2027.
Como perspectiva, espera-se maior padronização da camada de contexto para inferência e maior integração entre sistemas de arquivos, objetos e processadores de armazenamento. Os próximos passos práticos: mapear o perfil de I/O atual, definir a linha de base de utilização de GPU, comparar duas ou três arquiteturas em prova de conceito e alinhar o plano de compras ao calendário de fornecimento.