InfiniBand NDR: Guia Estratégico para IA e HPC em 2026
Introdução
Em 2026, a corrida por capacidade de computação de IA deixou de ser apenas uma disputa por GPUs. Ela se tornou, cada vez mais, uma disputa por interconexão. Um cluster com milhares de GPUs Blackwell ou Hopper só entrega o desempenho prometido se a rede que conecta esses aceleradores conseguir mover dados na mesma velocidade em que eles são processados. É nesse ponto que o InfiniBand NDR (Next Data Rate) se consolidou como a espinha dorsal de referência para treinamento de IA em larga escala e computação de alto desempenho (HPC).
Ratificado pela IBTA em 2020 e em produção em volume desde 2022, o NDR entrega 400 Gb/s por porta e, em meados de 2026, é considerado uma tecnologia madura: é o tecido padrão dos designs de referência NVIDIA DGX SuperPOD desde 2023 e a escolha dominante entre neoclouds parceiras da NVIDIA para clusters H100, H200 e GB200. Ao mesmo tempo, o mercado de fabric para data center está em transição acelerada, com o Ethernet baseado em RoCEv2 ganhando participação de mercado frente ao InfiniBand.
Para líderes de infraestrutura, essa combinação — maturidade técnica do NDR de um lado, pressão competitiva do Ethernet de outro — cria uma decisão estratégica real: continuar investindo em InfiniBand NDR, migrar para XDR, ou apostar em Ethernet de alto desempenho. Este artigo aprofunda os fundamentos técnicos do NDR, os riscos de decisões mal informadas sobre interconexão e as práticas recomendadas para implementação em ambientes empresariais de IA e HPC.
1. O Problema Estratégico: Interconexão como Gargalo Invisível
Empresas que investem pesado em GPUs frequentemente subestimam o papel da rede de interconexão. A lógica parece simples: mais GPUs equivalem a mais capacidade de treinamento. Na prática, workloads de treinamento distribuído — especialmente operações coletivas como AllReduce, usadas para sincronizar gradientes entre centenas ou milhares de GPUs — são extremamente sensíveis à latência e à largura de banda da rede. Um fabric subdimensionado transforma GPUs de última geração em recursos ociosos, esperando dados.
O InfiniBand NDR resolve esse problema combinando alta largura de banda (400 Gb/s por porta, distribuídos em quatro lanes de aproximadamente 100 Gb/s com modulação PAM4) com latência extremamente baixa e RDMA (Remote Direct Memory Access) nativo. RDMA permite que os dados sejam transferidos diretamente da memória de um nó para a memória de outro, sem envolver o sistema operacional ou o processador central, eliminando cópias intermediárias que penalizam workloads de IA em escala.
Esse desenho não é incremental: é arquitetural. Enquanto redes Ethernet tradicionais dependem de mecanismos de RDMA sobre Ethernet convergente (RoCEv2), que exigem tunning cuidadoso para se comportar de forma lossless, o InfiniBand foi projetado desde a origem para controle de fluxo baseado em crédito e comportamento sem perdas, sem exigir ajuste fino constante do operador. Essa diferença arquitetural explica por que o NDR continua sendo, em 2026, a escolha padrão em designs de referência para clusters H100/H200/GB200 que não possuem uma equipe interna já madura em operação de Ethernet/Spectrum-X.
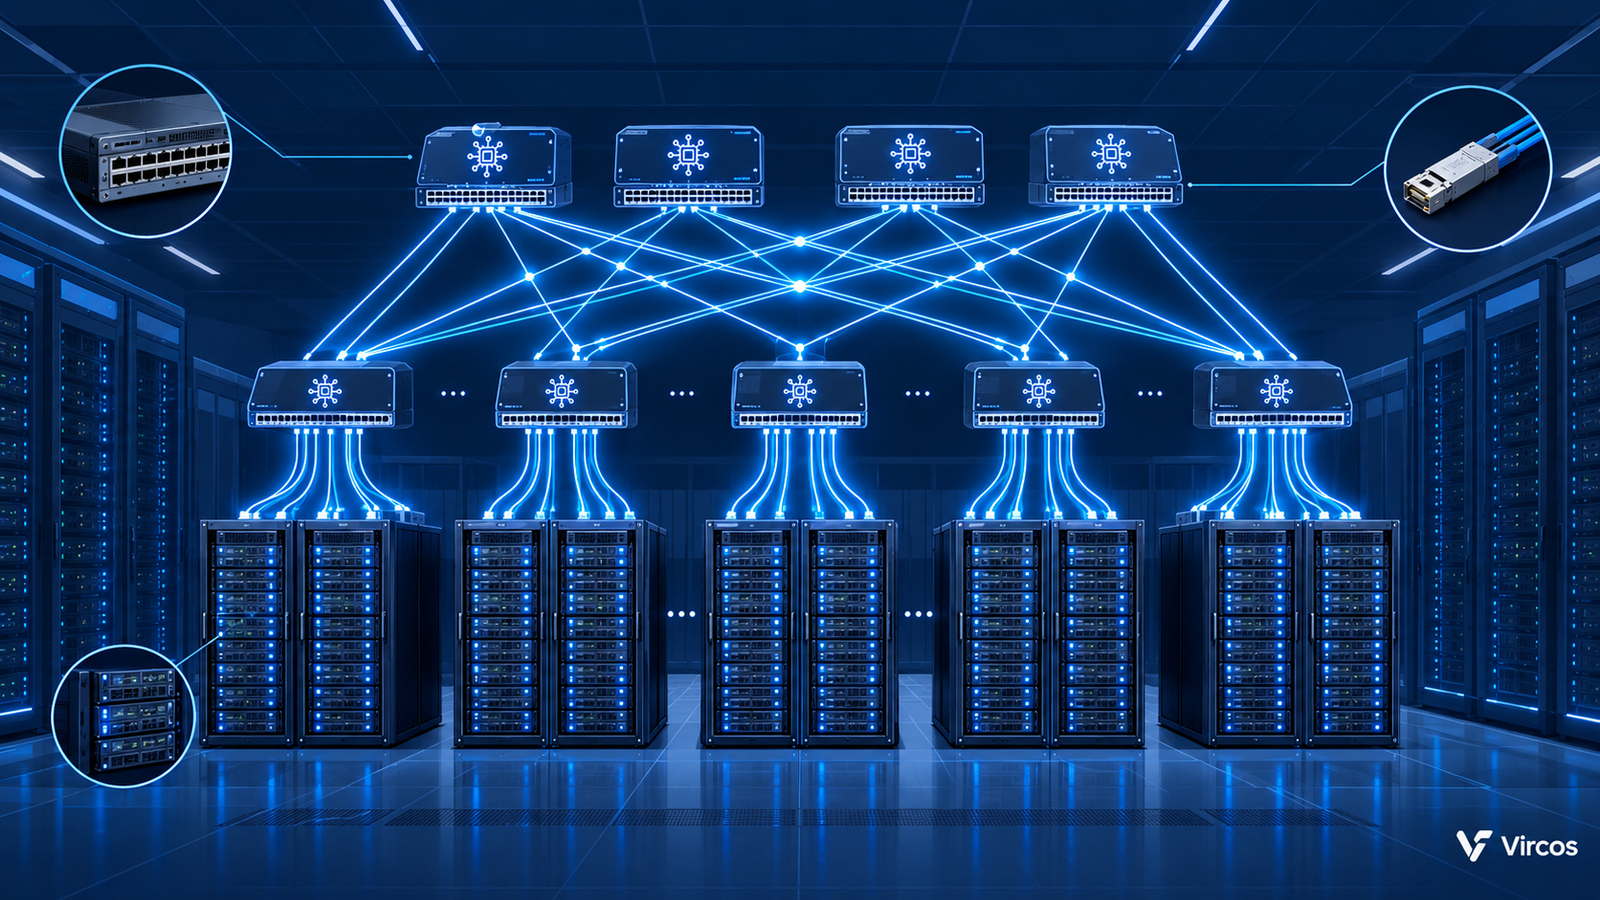
O núcleo do fabric NDR é o switch NVIDIA Quantum-2 (modelo MQM9700), que oferece 64 portas de 400 Gb/s sobre um ASIC de 51,2 Tb/s, com latência de corte (cut-through) da ordem de 330 nanossegundos. Do lado do adaptador, o ConnectX-7 é o Host Channel Adapter (HCA) canônico da geração, conectado via conector físico OSFP de porta dupla. Essa combinação switch–HCA–conector é o que define, na prática, o que o mercado chama de “fabric NDR”.
2. As Consequências da Inação (ou da Decisão Errada)
Adiar a modernização da camada de interconexão — ou escolher a tecnologia errada por economia de curto prazo — tem custos que se acumulam de forma silenciosa. O primeiro e mais óbvio é a subutilização de capital em GPU. Aceleradores como H100, H200 e GB200 representam parte relevante do investimento em infraestrutura de IA de uma organização; se a rede não sustenta o throughput necessário para operações coletivas em escala, o retorno sobre esse investimento cai proporcionalmente ao tempo que as GPUs passam aguardando sincronização de dados.
O segundo risco é de natureza operacional. Redes de fabric mal dimensionadas ou mal projetadas fisicamente — cabeamento, ópticas e refrigeração inadequados para a densidade da geração de rede escolhida — tendem a apresentar degradação de desempenho sob carga pesada, em vez de falhas evidentes. Isso é particularmente traiçoeiro: o cluster “funciona”, mas entrega uma fração do desempenho teórico, e o problema muitas vezes só é identificado meses depois, em uma auditoria de eficiência de treinamento.
O terceiro risco é competitivo. Em um mercado onde o tempo até o resultado de um modelo treinado é uma vantagem direta de negócio, organizações que operam clusters com fabric subdimensionado treinam mais devagar, iteram menos e chegam depois ao mercado com seus produtos de IA. Em paralelo, o cenário de mercado está mudando: segundo análise do Dell’Oro Group publicada em 2025, o Ethernet está a caminho de ultrapassar o InfiniBand como tecnologia de fabric dominante em data centers de grande escala, impulsionado por fabrics baseados em RoCE e Ultra Ethernet. Ignorar essa tendência ao planejar a próxima geração de infraestrutura pode significar investir em uma arquitetura isolada do ecossistema de fornecedores que crescerá mais rapidamente nos próximos anos.
3. Fundamentos Técnicos da Solução
Entender o NDR exige situá-lo dentro da evolução histórica do InfiniBand. Cada geração — SDR, DDR, QDR, FDR, EDR, HDR, NDR e, mais recentemente, XDR — aproximadamente dobrou a largura de banda por porta em relação à anterior, ao custo de conectores físicos diferentes, codificação de correção de erro (FEC) mais robusta e maior consumo de energia. O NDR ocupa a posição de “padrão seguro de produção” nesse espectro: mais rápido e eficiente que o HDR (200 Gb/s), porém mais maduro, testado e disponível em volume do que o XDR (800 Gb/s, baseado em switches Quantum-X800 e SuperNICs ConnectX-8), que representa a fronteira para clusters de IA em escala verdadeiramente massiva.
Do ponto de vista de protocolo, o diferencial mais relevante do InfiniBand frente ao Ethernet tradicional é o uso nativo de RDMA com zero-copy: os dados são movidos diretamente do adaptador de rede para o espaço de memória da aplicação, contornando o kernel e a pilha TCP/IP convencional. Essa característica reduz drasticamente a sobrecarga de CPU e a latência ponta a ponta, dois fatores críticos quando milhares de GPUs precisam trocar gradientes de forma síncrona a cada passo de treinamento.
Outro elemento técnico central do NDR é o SHARP (Scalable Hierarchical Aggregation and Reduction Protocol), na sua terceira geração (SHARPv3), que permite que operações de agregação — como somas usadas em AllReduce — sejam executadas dentro dos próprios switches da rede, e não apenas nos endpoints. Esse processamento “in-network” é um dos fatores que permite que operações NCCL AllReduce atinjam algo próximo de 95% da taxa de linha teórica em clusters da ordem de 1.024 GPUs, um patamar de eficiência difícil de replicar em fabrics puramente baseados em Ethernet sem otimizações equivalentes.
Em termos de dimensionamento físico, um fat-tree não bloqueante de referência para 1.024 GPUs em NDR tipicamente combina switches Quantum-2 organizados em camadas de folha (leaf) e espinha (spine) — por exemplo, 32 leaves e 16 spines, totalizando cerca de 48 switches. O investimento correspondente em hardware de switching e em módulos ópticos é significativo e deve ser tratado como parte central do orçamento de infraestrutura de IA, não como um item acessório de rede.
4. Implementação Estratégica
A implementação de um fabric InfiniBand NDR bem-sucedida começa por uma decisão que parece simples, mas costuma ser subestimada: dimensionar a rede a partir do número de GPUs e da topologia de treinamento desejada, e só então definir switches, adaptadores e cabeamento — nunca o caminho inverso. Definir a rede em função do orçamento disponível para equipamentos, sem partir da carga de trabalho real, é uma das causas mais comuns de fabrics que “funcionam no papel” mas não sustentam o desempenho esperado em produção.
Um segundo ponto crítico de implementação é o dimensionamento da camada física. A geração NDR já impõe exigências relevantes de cabeamento óptico, orçamento térmico e compatibilidade entre módulos e cages dos switches; escolher a geração de rede errada tem impacto direto na engenharia do rack, incluindo refrigeração e densidade de cabeamento. Projetos que tratam a camada física como commodity, sem validar compatibilidade entre adaptador, switch e óptica, tendem a enfrentar problemas de estabilização de link e degradação de desempenho sob carga — problemas caros de diagnosticar depois que o cluster já está em operação.
Também é estratégico planejar a coexistência entre gerações. Como o InfiniBand mantém compatibilidade de protocolo entre gerações, é tecnicamente possível operar, na mesma organização, clusters HDR mais antigos e menores ao lado de novos clusters NDR — mas essa coexistência exige planejamento de topologia e de gateway entre domínios, e não deve ser tratada como plug-and-play. Organizações que planejam expandir para XDR no médio prazo devem considerar, desde já, se a infraestrutura física (cabeamento, refrigeração, espaço em rack) comporta a transição futura, evitando retrabalho estrutural.
5. Melhores Práticas Avançadas: Governança, Segurança e Otimização
Além da arquitetura de rede em si, a operação madura de um fabric NDR exige práticas de governança específicas para ambientes de HPC e IA. Do ponto de vista de segurança, é recomendável segmentar o fabric InfiniBand como uma rede isolada, dedicada exclusivamente à comunicação GPU-a-GPU e de armazenamento de alto desempenho, separada da rede de gestão e da rede corporativa geral — reduzindo superfície de ataque e simplificando auditoria de tráfego sensível de treinamento.
Em termos de compliance, organizações que operam em setores regulados ou que atendem clientes governamentais devem avaliar certificações e alinhamentos específicos de segurança para a infraestrutura de rede, incluindo controles de acesso físico aos racks de switches, criptografia de dados em trânsito quando aplicável, e políticas claras de retenção de logs de rede para fins de auditoria.
No campo da otimização operacional, equipes maduras de infraestrutura de IA monitoram continuamente indicadores como tempo de estabilização de link após reinicialização, taxa de erros corrigidos por FEC e eficiência real de operações coletivas (comparando a taxa de transferência observada em AllReduce com a taxa de linha teórica). Desvios recorrentes nesses indicadores costumam ser sinais precoces de problemas de cabeamento, óptica ou configuração de switch, e devem ser tratados como parte de um processo contínuo de manutenção, e não apenas investigados quando o treinamento falha.
6. Medição de Sucesso
Avaliar a eficácia de um investimento em InfiniBand NDR exige métricas que conectem desempenho técnico a resultado de negócio. No nível técnico, os indicadores centrais incluem a eficiência de operações coletivas (percentual da taxa de linha teórica efetivamente atingido em AllReduce), a latência ponta a ponta observada sob carga, a taxa de utilização média das portas do fabric e a frequência de eventos de degradação ou reinicialização de link.
No nível de negócio, esses indicadores técnicos devem ser traduzidos em métricas que a liderança executiva reconheça: tempo total até a conclusão de um ciclo de treinamento, custo efetivo por hora de GPU realmente produtiva (descontando tempo ocioso por gargalo de rede) e capacidade de escalar o cluster horizontalmente sem degradação proporcional de eficiência. Uma rede NDR bem dimensionada deve permitir que a eficiência de treinamento se mantenha estável — idealmente próxima dos patamares de referência de mercado — mesmo à medida que o número de GPUs no cluster cresce.
Conclusão
O InfiniBand NDR chega a 2026 como uma tecnologia madura, amplamente validada em produção e ainda como a escolha padrão para grande parte dos novos clusters de treinamento H100, H200 e GB200 — especialmente para organizações sem uma operação interna já consolidada em Ethernet de alto desempenho. Sua combinação de RDMA nativo, controle de fluxo lossless por hardware e processamento in-network via SHARP continua entregando níveis de eficiência em operações coletivas difíceis de igualar.
Ao mesmo tempo, o cenário de mercado está em transição real, com o Ethernet baseado em RoCEv2 ganhando participação relevante em data centers de grande escala. Isso não torna o NDR obsoleto, mas reforça a importância de decisões de arquitetura de rede tomadas com clareza sobre workload, orçamento térmico e físico, e horizonte de expansão futura — incluindo a eventual migração para XDR.
Como próximo passo prático, recomenda-se que equipes de infraestrutura avaliando ou expandindo clusters de IA realizem um dimensionamento de fabric a partir da contagem de GPUs e da topologia de treinamento alvo, validem a compatibilidade física completa entre adaptadores, switches e ópticas antes da aquisição, e estabeleçam desde o início um conjunto de métricas de eficiência de rede a serem monitoradas continuamente após a entrada em produção.