MLOps Infraestrutura: Guia Estratégico para IA em Produção
MLOps e Infraestrutura de IA: Como Construir uma Base Escalável, Governada e Eficiente em Custos
Em 2026, a pergunta que domina as reuniões de arquitetura de IA não é mais se a empresa consegue treinar um modelo. É se consegue operá-lo de forma confiável, auditável e com custo previsível. O MLOps deixou de ser um conjunto de scripts de deploy e passou a funcionar como o sistema de controle de toda a operação de IA, cobrindo modelos clássicos, LLMs, pipelines de RAG e agentes.
O desafio crítico está na infraestrutura. GPUs são caras, escassas ou subutilizadas, o Kubernetes virou o substrato padrão e a camada de serving precisa atender cargas muito diferentes entre si. Ao mesmo tempo, a regulação avança e exige rastreabilidade que muitas plataformas ainda não oferecem.
O custo da inação ou de uma implementação improvisada aparece em três frentes: capital imobilizado em hardware ocioso, incidentes de produção sem causa identificável e risco regulatório. Este artigo analisa o problema estratégico, as consequências de não agir, os fundamentos técnicos da solução, a implementação, as práticas avançadas e a forma de medir resultados.
O problema estratégico: do protótipo à operação contínua
O gargalo mudou de lugar
Durante dois anos, o debate de infraestrutura de IA girou em torno da escassez de GPUs. Hoje o gargalo é outro: utilização e operação. Em levantamento publicado em 2026, o Cast AI analisou cerca de 23 mil clusters Kubernetes e encontrou utilização média de GPU de apenas 5%, contra 8% de CPU e 20% de memória.
Dois cuidados de leitura são necessários. O Cast AI é um fornecedor de automação de Kubernetes, e o relatório se baseia em clusters sem otimização, então o número descreve o ponto de partida típico, não o teto do que é possível. Mesmo assim, ele é coerente com outro dado: a pesquisa ClearML 2025-2026 com grandes empresas aponta que 53% dos respondentes citam o controle de custos como principal desafio na gestão de cargas de IA.
O ponto estratégico é que comprar mais hardware raramente resolve o problema. Quando times esperam em fila enquanto GPUs ficam paradas, a falha está na orquestração, no compartilhamento e no agendamento, que são decisões de plataforma.
Convergência entre MLOps, LLMOps e AIOps
As fronteiras entre disciplinas estão se apagando. Análises de 2026 descrevem plataformas unificadas que gerenciam um classificador XGBoost e um modelo de linguagem ajustado com o mesmo registro, o mesmo monitoramento e a mesma esteira de deploy.
Os modos de falha, porém, continuam distintos. No ML clássico, o risco central é drift e latência. Em LLMs, entram qualidade da resposta, vazamento de prompt e segurança. Uma plataforma madura compartilha a infraestrutura, mas mantém métricas e alertas específicos para cada tipo de carga.
Na prática, isso muda o desenho organizacional. Em vez de uma equipe de infraestrutura para cada projeto, empresas que escalam tratam a plataforma de ML como um produto interno, com roadmap, clientes internos e acordos de nível de serviço.
Consequências da inação: custo, risco regulatório e perda de competitividade
O custo invisível da capacidade ociosa
A aritmética é simples e incômoda. O custo por hora útil de GPU é o preço da hora dividido pela utilização. Uma GPU de US$ 10 por hora operando a 20% desperdiça mais de US$ 70 mil por ano, cálculo apresentado pela vCluster com base em sua pesquisa AI Infrastructure 2025.
Em uma análise publicada em 2026, o mesmo raciocínio aplicado a uma GPU de US$ 3,93 por hora resulta em cerca de US$ 78,60 por hora útil a 5% de utilização, e US$ 9,83 a 40%. Esses números vêm de uma fonte secundária e devem ser tratados como ilustração do método, não como benchmark. O que importa é a lógica: cada ponto percentual de utilização recuperado reduz diretamente o custo unitário da inferência.
Há também um efeito de governança financeira. Segundo uma pesquisa de 2026 da FinOps Foundation, citada pela CloudBolt, 98% das equipes já gerenciam gastos com IA, contra 31% dois anos antes. A área financeira passou a cobrar visibilidade por modelo, por equipe e por produto.
Risco regulatório e de reputação
Na União Europeia, o Digital Omnibus on AI adiou as obrigações de sistemas de alto risco do Anexo III para 2 de dezembro de 2027 e as de produtos regulados do Anexo I para 2 de agosto de 2028. A Council aprovou o texto em 29 de junho de 2026, e escritórios de advocacia ressaltam que o adiamento não é uma pausa geral: boa parte das obrigações de transparência do Artigo 50 e as regras para modelos de uso geral continuam em vigor.
No Brasil, o PL 2338/2023, aprovado pelo Senado em dezembro de 2024, tramita na Câmara dos Deputados, e as fontes consultadas indicam que o país ainda não tem uma lei geral de IA. Isso não elimina a obrigação atual: a LGPD já se aplica a dados pessoais usados em treinamento e inferência, e o texto em discussão prevê avaliação de risco, transparência e responsabilidade sobre decisões automatizadas.
O ponto prático é que auditar um modelo exige saber qual versão estava em produção, com quais dados foi treinada e quem aprovou a promoção. Sem registro, linhagem e logs, a empresa não consegue responder a um regulador, a um cliente ou ao próprio conselho.
Dependência de fornecedor e perda de flexibilidade
Na mesma pesquisa da ClearML, 44% dos respondentes classificam como muito importante a flexibilidade para evitar lock-in. Plataformas construídas sobre abstrações proprietárias dificultam migrar cargas entre nuvem pública, ambiente híbrido e on-premises.
Esse risco cresce com o preço. Quando a capacidade custa mais e é contratada por períodos longos, a incapacidade de mover cargas passa a ser uma desvantagem competitiva concreta. Por isso o desenho da plataforma deve preservar portabilidade desde o início.
Fundamentos da solução: uma plataforma de ML sobre Kubernetes
Por que o Kubernetes virou o substrato
Cobertura do ecossistema CNCF em 2026 aponta Kubernetes com 82% de uso entre adotantes de contêineres, e KServe, Ray, Kubeflow, vLLM Production Stack e NVIDIA Triton têm o Kubernetes como alvo de implantação. A consequência é uma gama ampla de primitivas prontas para batching, roteamento, autoscaling e rollout progressivo.
Isso não significa que todo caso de uso exija um cluster próprio. Para cargas pequenas, serviços gerenciados de nuvem podem ser a decisão mais racional. O Kubernetes se justifica quando há várias equipes, vários modelos, requisitos de portabilidade ou ambiente híbrido.
A decisão de plataforma deve partir do portfólio de cargas, não da moda tecnológica. Um catálogo com poucos modelos estáveis e baixo volume tem necessidades muito diferentes de uma operação com dezenas de modelos, LLMs próprios e picos de tráfego.
As camadas de uma plataforma madura
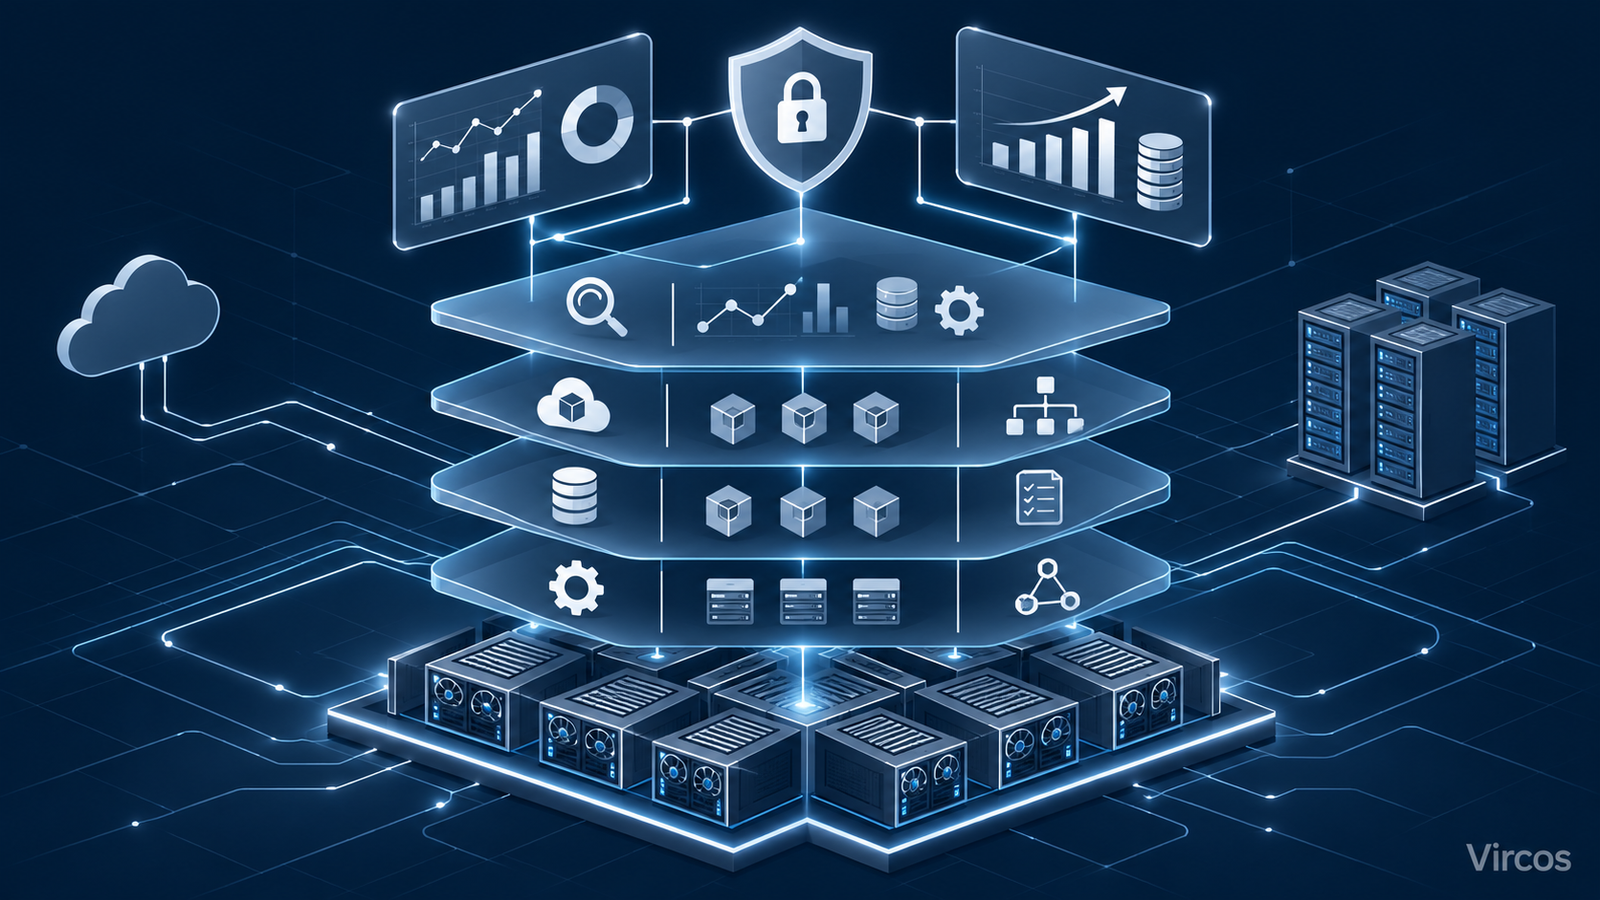
Uma arquitetura de referência para 2026 se organiza em camadas independentes e substituíveis. A primeira cuida de dados e features, com validação e versionamento. A segunda cuida de treinamento e experimentação, com agendamento de GPU e rastreamento de experimentos, por exemplo com MLflow.
A terceira é o registro de modelos, que guarda versões, metadados, linhagem e aprovações. A quarta é a de serving, responsável por expor modelos com autoscaling e rollout seguro. A quinta, transversal, é a de observabilidade e governança.
A tabela abaixo resume os componentes mais citados na camada de orquestração e serving em fontes de 2026.
| Componente | Função principal | Quando faz sentido |
|---|---|---|
| KServe | Operador Kubernetes que gerencia inferência preditiva e generativa por recursos customizados; projeto CNCF em incubação | Muitos modelos de tipos diferentes, necessidade de padronização e canary |
| vLLM | Motor de inferência para LLMs, com PagedAttention e batching contínuo | Inferência de LLM com foco em throughput |
| llm-d | Serving distribuído de LLMs sobre Kubernetes, com roteamento consciente de KV-cache | Modelos grandes, multi-nó, alta demanda |
| NVIDIA Triton | Servidor multiframework em um único runtime | Cargas heterogêneas em hardware NVIDIA |
| Kueue | Fila e admissão de jobs com quotas por equipe | Treinamento e batch compartilhando GPUs |
Fontes: Thoughtworks Technology Radar (nov/2026), Red Hat AI (fev/2026), documentação e análises de comunidade de 2026.
Implementação estratégica: agendamento, serving e entrega contínua
Agendamento de GPU: de contagem inteira a requisitos declarativos
O avanço mais relevante da camada de infraestrutura é a Dynamic Resource Allocation (DRA). Em vez de pedir um número inteiro de GPUs, a carga descreve o dispositivo de que precisa, como memória mínima ou modo de compartilhamento. Várias fontes situam a graduação da DRA para disponibilidade geral no Kubernetes 1.34, mas pelo menos uma a cita na 1.35, então confirme nas notas de versão da sua distribuição antes de planejar.
Sobre a DRA entram os agendadores de fila. O Kueue funciona como controlador de admissão com quotas por equipe, e o KAI Scheduler, alinhado à NVIDIA, adiciona gang scheduling e filas com topologia. Em um estudo de caso industrial publicado no arXiv em 2026, o uso de Kueue reduziu o tempo total de execução do lote em até 15%, resultado que depende do perfil de carga.
Há um trade-off conhecido: o gang scheduling evita que jobs distribuídos fiquem esperando indefinidamente por GPUs parciais, mas pode reduzir a utilização do cluster em alguma medida. A escolha entre vazão máxima e previsibilidade deve ser explícita e documentada.
Serving: escolher o motor e a camada de controle separadamente
Uma distinção útil é separar o motor de inferência da camada de controle. Segundo o Thoughtworks Radar, o KServe não executa a inferência por si; ele orquestra runtimes como vLLM, SGLang e Triton e separa o ciclo de vida do serviço do motor que o executa. Para LLMs avançados, o recurso LLMInferenceService, construído sobre llm-d e o Gateway API Inference Extension, suporta inferência multi-nó, separação entre prefill e decode e roteamento que prioriza réplicas com o prefixo já em cache.
Para um único modelo de LLM com tráfego alto, o vLLM sozinho pode bastar, e adicionar KServe só se justifica quando cresce a diversidade de modelos e a complexidade de deploy. Esse é um exemplo de decisão em que menos componentes costumam significar menos pontos de falha.
Um alerta sobre maturidade: relatos de comunidade indicam que o llm-d foi doado ao CNCF Sandbox em março de 2026 por Red Hat, Google, IBM, CoreWeave e NVIDIA. A informação vem de uma única fonte secundária, e projetos nesse estágio exigem avaliação cuidadosa antes de entrar em produção crítica.
Entrega contínua e pontos de falha
Versões de modelo e configurações de serving devem ser tratadas como código. A mesma cobertura da CNCF indica que Argo CD e Flux, juntos, são usados por 42% dos usuários de Kubernetes na entrega em produção, o que torna o GitOps a prática dominante.
Os pontos de falha mais comuns na implantação são previsíveis: drivers e operadores de GPU desalinhados com a versão do Kubernetes, imagens de contêiner sem versão fixa, ausência de quotas por equipe e rollouts sem tráfego parcial. Cada um deles pode ser mitigado com testes de integração em ambiente de homologação com a mesma topologia de GPU.
Recomenda-se também começar por um caso de uso piloto bem delimitado, com métricas de base já coletadas, e só então expandir. Plataformas construídas de uma só vez, sem cliente interno, tendem a ficar subutilizadas.
Melhores práticas avançadas: governança, segurança e FinOps
Infraestrutura como código e políticas como código
Orquestrar fluxos de ML manualmente é um risco operacional. Todo o ambiente, de clusters a pipelines e endpoints, deve ser descrito em IaC e versionado. Análises de 2026 destacam a integridade do IaC e a segurança do plano de controle da nuvem como prioridades, pois comprometem diretamente a propriedade intelectual dos modelos.
A tendência de policy-as-code leva essa lógica à governança: regras como exigir aprovação antes de promover um modelo, bloquear imagens sem varredura de vulnerabilidades ou impedir endpoints sem autenticação são codificadas e verificadas automaticamente. Isso transforma conformidade de checklist manual em controle contínuo.
Uma ressalva realista: policy-as-code reduz o trabalho de auditoria, mas não substitui a decisão humana sobre o que é aceitável. As políticas precisam ser revisadas com as áreas jurídica e de risco.
Multi-tenancy e isolamento
Na pesquisa citada pela vCluster, cerca de 90% das equipes apontam custo ou dificuldade de compartilhamento como principais bloqueios à utilização de GPU, e 54,5% citam o custo como maior dor. Compartilhar com segurança exige isolamento de rede, de identidade e de dados entre equipes.
As opções vão de namespaces com quotas a clusters virtuais e fatiamento de hardware com MIG, que divide GPUs compatíveis em instâncias isoladas. Quanto maior o requisito de isolamento, maior o custo operacional, e a escolha deve refletir a sensibilidade dos dados de cada carga.
Em setores regulados, vale tratar o isolamento como requisito de projeto, e não como otimização posterior. Reconfigurar o modelo de tenancy com a plataforma já em produção é muito mais caro.
FinOps de IA e consolidação de ferramentas
Custos precisam ser atribuídos por modelo, equipe e produto, com alertas de anomalia e revisão periódica de reservas. Fontes de 2026 apontam que ferramentas de otimização de custo estão entre as maiores prioridades de aumento de orçamento, e que arquiteturas construídas quando tokens eram tratados como custo irrelevante viram passivos sob preço por uso.
Há ainda um movimento de consolidação do ferramental. A abordagem que muitas empresas adotam é um núcleo aberto gerenciado: padrões abertos como MLflow e BentoML hospedados em infraestrutura corporativa reforçada. Isso preserva portabilidade sem abrir mão de suporte e segurança.
Medição de sucesso: métricas e indicadores
KPIs de infraestrutura
O primeiro grupo de indicadores mede a eficiência do hardware. A utilização efetiva de GPU, medida em segundos de GPU consumidos versus provisionados em janelas de pelo menos sete dias, é o ponto de partida. A ela se somam o tempo médio de espera em fila e o custo por hora útil de GPU.
Para inferência, o conjunto essencial é latência p95 e p99, vazão por réplica, taxa de erro e, em LLMs, tempo até o primeiro token e custo por mil tokens. Esses números devem ser coletados por modelo e por versão, de modo que um rollout ruim seja identificado em minutos.
Metas de utilização devem ser definidas por tipo de carga. Inferência com SLA rígido tolera menos ocupação do que treinamento em lote, e comparar ambos com a mesma régua leva a decisões ruins.
KPIs de modelo e de negócio
O segundo grupo mede a saúde dos modelos: drift de dados e de conceito, degradação de acurácia contra um conjunto de referência e, para LLMs, avaliação de qualidade e segurança das respostas. Sem esses sinais, a plataforma pode estar saudável enquanto o modelo erra silenciosamente.
O terceiro grupo liga tudo ao negócio: tempo entre o modelo aprovado e o modelo em produção, frequência de deploy, taxa de rollback, custo de inferência por transação e impacto no indicador que o modelo deveria melhorar, como receita retida ou fraude evitada.
Esses indicadores devem alimentar um painel único, acessível a engenharia, finanças e governança. O objetivo é que a conversa sobre investimento em IA seja baseada em dados comuns.
Conclusão: infraestrutura como vantagem operacional
Os dados de 2026 convergem em um diagnóstico: o gargalo da IA corporativa migrou da disponibilidade de modelos e de GPUs para a qualidade da operação. Utilização baixa, fragmentação de ferramentas e governança tardia explicam boa parte do custo e do risco que as empresas enfrentam.
A resposta passa por uma plataforma de ML tratada como produto, assentada em Kubernetes quando a escala e a portabilidade justificam, com agendamento declarativo de GPU, serving desacoplado do motor, entrega via GitOps, políticas codificadas e atribuição rigorosa de custos. Cada escolha envolve trade-offs que devem ser registrados e revistos.
Olhando adiante, espera-se consolidação em torno de plataformas que unam ML clássico, LLMs e agentes sob um mesmo plano de controle, e amadurecimento de padrões como DRA, KServe e llm-d. A regulação europeia e a brasileira devem seguir evoluindo, e arquiteturas auditáveis por padrão serão mais baratas do que adaptações posteriores.