InfiniBand XDR 800G: Guia Estratégico para Redes de IA 2026
Em 2026, o desempenho de um cluster de IA deixou de ser definido apenas pela quantidade de GPUs. Em treinamentos distribuídos, cada passo termina com operações coletivas, como o all-reduce, e o enlace mais congestionado dita o ritmo de todos os demais. A rede, portanto, passou a fazer parte do computador.
O InfiniBand XDR 800G é a resposta da NVIDIA e da InfiniBand Trade Association (IBTA) a essa pressão. A especificação XDR foi publicada em outubro de 2023 e consolidada na Release 2.0 em julho de 2025, usando SerDes de 200 Gb/s por lane para entregar 800 Gb/s por porta, o dobro do NDR 400G. Na prática, ela chega ao mercado pela plataforma Quantum-X800, pelos adaptadores ConnectX-8 e, agora, pelo ConnectX-9.
A decisão, porém, não é trivial. Segundo a Dell’Oro Group (junho de 2026), o Ethernet respondeu por cerca de dois terços das vendas de switches em redes back-end de IA no primeiro trimestre de 2026, ainda que o InfiniBand tenha mostrado recuperação. Escolher errado significa GPUs ociosas, capex imobilizado em uma geração que envelhece rápido e, em alguns casos, retrabalho de cabeamento e refrigeração.
Este artigo analisa o problema estratégico, os riscos da inação, os fundamentos técnicos do XDR, a implementação, as melhores práticas e as métricas de sucesso, separando com clareza o que já está em produção do que ainda é roadmap.
1. O problema estratégico: a rede como limitador do retorno sobre as GPUs
Por que as operações coletivas dominam o tempo de treinamento
Em treinamento de modelos grandes, as GPUs trocam gradientes e ativações continuamente. Essas trocas são síncronas: nenhuma GPU avança até que todas concluam a etapa coletiva. Isso significa que a latência de cauda (o enlace mais lento) importa mais do que a latência média.
Quando a banda por GPU é insuficiente, o resultado é um padrão conhecido: utilização de GPU abaixo do esperado, tempos de job maiores e custo por modelo treinado crescendo mesmo com mais hardware. O investimento mais caro do data center passa a esperar pelo componente mais barato.
Por isso a rede deve ser dimensionada junto com o acelerador, e não depois dele. Um cluster com GPUs de última geração e fabric de geração anterior transfere o gargalo, mas não o elimina.
A escalada de banda por GPU em 2026
O rack GB300 NVL72, baseado em Blackwell Ultra, usa o ConnectX-8 como NIC de scale-out, a 800 Gb/s por porta, conforme apresentado pela NVIDIA na CES 2026. A geração seguinte, Vera Rubin, adota o ConnectX-9, que, segundo o datasheet da NVIDIA, entrega até 1,6 Tb/s de vazão para as GPUs Rubin.
Esse salto transforma o 800G em piso, e não em teto. Em ambientes que ainda operam NDR 400G com Hopper, a lacuna entre acelerador e rede tende a ficar mais visível a cada atualização de GPU.
Implicações técnicas e de negócio
Do ponto de vista técnico, o desafio é escalar banda sem escalar a complexidade operacional. Do ponto de vista de negócio, o que está em jogo é o tempo até o primeiro modelo, o custo por GPU-hora efetivamente aproveitada e a previsibilidade de entrega de projetos de IA.
2. Consequências da inação
Riscos específicos de permanecer em 400G
A Dell’Oro Group projeta que a maioria das portas de switch em redes back-end de IA seria de 800 Gb/s em 2025, 1,6 Tb/s em 2027 e 3,2 Tb/s em 2030 (relatório de julho de 2025, previsões). Embora sejam projeções, elas indicam a direção do ecossistema de óptica, cabos e NICs.
Operar em 400G por tempo demais significa comprar peças de uma geração com volume decrescente, enfrentar custos de suporte maiores e correr o risco de uma migração forçada, geralmente sob pressão de cronograma.
Custos de oportunidade e desvantagem competitiva
O custo mais relevante não está no equipamento, mas no tempo. Se concorrentes treinam e iteram modelos mais rápido em fabrics mais eficientes, a vantagem se acumula a cada ciclo de experimentação.
É importante, porém, ser honesto quanto ao contrário. A própria NVIDIA afirma que o Quantum-2 NDR 400G continua sendo uma opção sólida para implantações com Hopper ou sensíveis a custo, e recomenda o Quantum-X800 principalmente para novos clusters de escala Blackwell. A inação só é um risco real quando o plano de GPUs já aponta para Blackwell Ultra ou Rubin.
O risco de escolher o fabric por inércia
Há ainda um risco oposto: adotar InfiniBand por hábito ou Ethernet por preço, sem avaliar a carga de trabalho. A Dell’Oro observa que o mercado se dividiu: a escolha depende do perfil do cliente, da escala e do ecossistema de software, e não de uma resposta universal.
3. Fundamentos da solução: como funciona o InfiniBand XDR 800G
Base técnica: 200 Gb/s por lane
Segundo a IBTA, a Release 2.0 das especificações (publicada em 31 de julho de 2025) suporta XDR com até 200 Gb/s por lane, o que resulta em links de 800 Gb/s com QSFP e de 1,6 Tb/s com QSFP-DD e OSFP. A revisão também introduz um novo mecanismo de correção de erros (FEC) para XDR, necessário para manter a integridade do sinal em taxas tão altas.
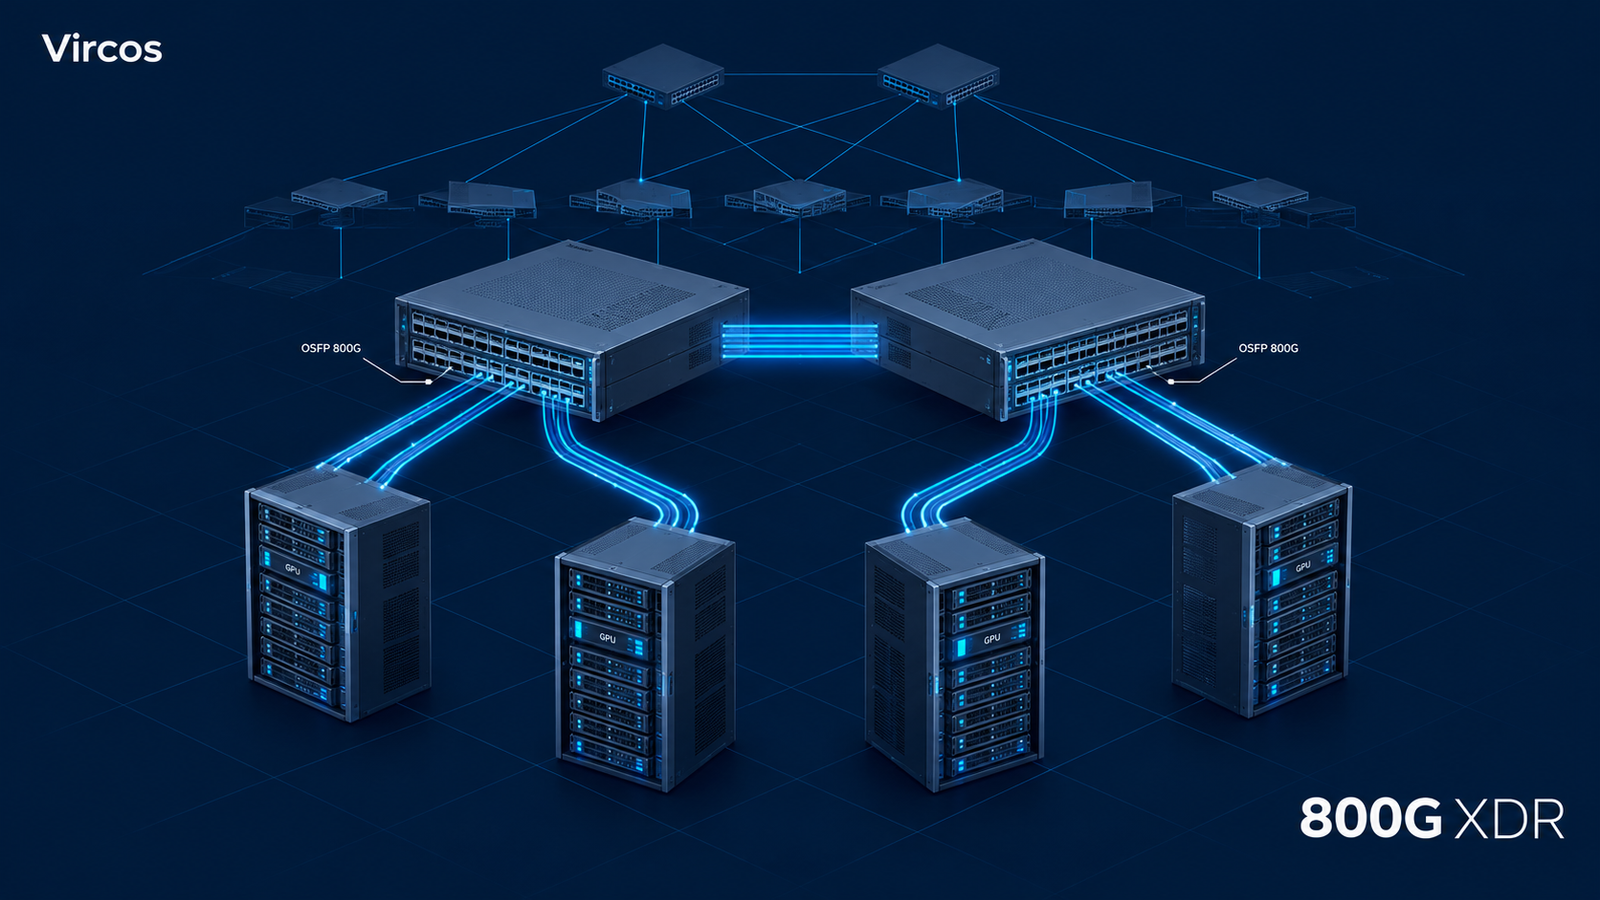
Na plataforma da NVIDIA, isso se traduz em um modelo de portas pouco intuitivo. O Q3400-RA oferece 144 portas de 800 Gb/s distribuídas em 72 gaiolas OSFP, em chassi de 4U, com capacidade equivalente a 115,2 Tb/s. Cada gaiola OSFP é do tipo twin-port, entregando duas portas de 800G.
O Q3200-RA, de 2U, abriga dois switches independentes no mesmo chassi, cada um com 36 portas de 800 Gb/s. Segundo a NVIDIA, ele é o modelo indicado para conectar ambientes XDR 800G a ambientes NDR 400G existentes, o que o torna relevante para migrações graduais.
| Característica | Q3400-RA | Q3200-RA | Quantum-X Photonics (Q3450-LD) |
|---|---|---|---|
| Formato | 4U | 2U (dois switches) | 4U |
| Portas de 800 Gb/s | 144 (72 gaiolas OSFP) | 72 (2 × 36) | 144 |
| Óptica | Plugável (OSFP) | Plugável (OSFP) | Co-packaged (CPO), conectores MPO |
| Refrigeração | Ar | Ar | Líquida |
| Papel típico | Spine/leaf de grande escala | Pontes NDR/XDR e clusters menores | Clusters de maior escala com foco em eficiência energética |
Fontes: NVIDIA, HPE, revendedores autorizados e notas técnicas de Glenn K. Klockwood (2026). Valores de revendedores devem ser confirmados nos datasheets oficiais antes de projetos.
Computação em rede, roteamento adaptativo e controle de congestionamento
O XDR não é apenas mais banda. A plataforma Quantum-X800 combina roteamento adaptativo, controle de congestionamento baseado em telemetria e o SHARP (Scalable Hierarchical Aggregation and Reduction Protocol), que executa parte das reduções coletivas dentro dos próprios switches, reduzindo o volume de dados que trafega pela rede.
Segundo a NVIDIA, aplicações que usam NCCL, OpenMPI, UCX ou outras pilhas MPI compatíveis se beneficiam com poucas alterações de código. Isso reduz o risco de adoção, pois a otimização ocorre abaixo da camada de aplicação.
Interoperabilidade e escala
Uma topologia fat-tree de dois níveis com Quantum-X800 suporta mais de 10.000 conexões de host a 800 Gb/s, conforme a NVIDIA e a HPE. No lado do servidor, o ConnectX-8 C8180 usa uma única gaiola OSFP, opera em 800 Gb/s XDR (ou 2 × 400 GbE) e utiliza PCIe Gen6 x16, o que exige plataformas de servidor compatíveis com essa geração de barramento.
O ConnectX-9 mantém portas de até 800 Gb/s sobre InfiniBand e Ethernet e entrega até 1,6 Tb/s às GPUs Rubin. As notas de firmware indicam versões GA em fevereiro e junho de 2026, com a ressalva de que clientes de sistemas GB devem usar o pacote designado para a sua plataforma.
4. Implementação estratégica
Abordagem metodológica
Um projeto XDR bem-sucedido começa pelo dimensionamento reverso: número de GPUs, banda por GPU, taxa de oversubscription aceitável e crescimento previsto em 24 a 36 meses. Só então se define a topologia, tipicamente fat-tree não bloqueante para treinamento de grande escala.
A segunda decisão é o modelo de conectividade: quantos adaptadores por servidor, quais portas do switch alimentam cada um e como o cabeamento será organizado fisicamente. Erros nessa etapa são caros, porque cabeamento óptico de alta densidade raramente é refeito sem parada.
Cabeamento e óptica: onde o 800G realmente se complica
Em 200 Gb/s por lane, o alcance do cobre cai de forma significativa. Segundo guias de conectividade do ecossistema, cabos DAC passivos de 1,6T para duas portas de 800G alcançam cerca de 1 m, enquanto cabos ativos (ACC/AEC) chegam a cerca de 3 m. Acima disso, é necessário usar óptica.
| Distância típica | Mídia | Aplicação |
|---|---|---|
| Até ~1 m | DAC passivo | Switch a NIC no mesmo rack ou rack adjacente; leaf a spine muito próximos |
| Até ~3 m | Cobre ativo (ACC/AEC) | Servidor a leaf em rack vizinho |
| Dezenas a centenas de metros | Transceptor óptico monomodo 2×DR4 | Leaf a spine no salão |
| Até ~2 km | Transceptor óptico 2×FR4 | Conexões entre salões ou prédios |
Fontes: guias de conectividade ConnectX-8/Quantum-X800 e catálogo NADDOD (2025-2026). Alcances variam por fabricante e devem ser validados na lista de compatibilidade da NVIDIA.
Esse ponto muda o orçamento. Em projetos de 800G, o custo e o consumo de energia da óptica pesam mais do que em gerações anteriores, o que explica o interesse crescente em co-packaged optics.
Fotônica em silício (CPO): produção inicial em 2026
O Quantum-X Photonics integra a óptica diretamente ao pacote do switch. Segundo a NVIDIA, a abordagem reduz a perda elétrica de cerca de 22 dB para aproximadamente 4 dB, com eficiência energética 3,5 vezes maior, resiliência 10 vezes superior e implantação 1,3 vez mais rápida em relação a transceptores plugáveis. São números do fabricante, e ainda dependem de validação independente em escala.
De acordo com as notas técnicas de Glenn K. Klockwood, o Q3450-LD oferece 144 portas XDR de 800G, é refrigerado a líquido e usa 18 módulos laser (8 portas por módulo). Segundo a mesma fonte, a Lambda foi uma das primeiras provedoras de GPU como serviço a colocá-lo em produção junto com GB300 NVL72, em junho de 2026. A Dell’Oro previu que 2026 seria o ano do início do ramp de volume de CPO em InfiniBand e Ethernet.
Pontos de falha potenciais
Os pontos mais comuns de falha em projetos XDR são: incompatibilidade entre versões de firmware de NIC, switch e transceptores; dissipação térmica de módulos OSFP de alta potência; servidores sem PCIe Gen6 adequado; e falta de planejamento de refrigeração líquida quando se opta por CPO.
Um erro recorrente é validar apenas o enlace físico. Um link que sobe a 800G não garante desempenho de aplicação: é preciso testar coletivas reais sob carga.
5. Melhores práticas avançadas
Operação e telemetria
A NVIDIA oferece o UFM (Unified Fabric Manager) em appliance 1U com adaptadores ConnectX-8 XDR para telemetria e gestão do fabric. A recomendação operacional é tratar a telemetria como requisito de projeto, e não como complemento: contadores de erro pré-FEC, flaps de link e congestionamento por porta são os primeiros sinais de degradação.
Antes de entrar em produção, execute um período de burn-in com testes de coletivas (por exemplo, NCCL tests) em escala crescente, comparando a banda efetiva com a taxa nominal. Falhas intermitentes em óptica tendem a aparecer apenas sob carga prolongada.
Governança, compliance e segurança
Os adaptadores ConnectX-8 listados na documentação da NVIDIA incluem criptografia e secure boot habilitados nos part numbers analisados. Para ambientes multi-inquilino, o InfiniBand oferece particionamento lógico do fabric, que deve ser combinado com política de acesso ao gerenciador de sub-rede e com controle de firmware.
Para empresas sujeitas à LGPD ou a requisitos setoriais, vale documentar onde ficam dados de treinamento, quem administra o fabric e como são auditadas mudanças de configuração. A rede de alto desempenho costuma ficar fora do escopo de auditorias tradicionais, o que cria lacunas de governança.
Trade-offs: InfiniBand XDR ou Ethernet de 800G?
A Dell’Oro registrou que 2025 foi o ano em que o Ethernet superou o InfiniBand em adoção nas redes back-end de IA, e que, no primeiro trimestre de 2026, o Ethernet respondeu por cerca de dois terços das vendas de switches nesse segmento. O InfiniBand, no entanto, mostrou recuperação no período.
O InfiniBand tende a se destacar quando há integração estreita com SHARP, gestão unificada pelo UFM e cargas fortemente sensíveis à latência de cauda. O Ethernet leva vantagem quando a organização já tem equipes, ferramentas e fornecedores multivendor, ou quando busca diversificar a cadeia de suprimentos. Vale lembrar que a própria NVIDIA oferece Spectrum-X Ethernet e que o ConnectX-9 opera nos dois protocolos, o que reduz o risco de aprisionamento.
Nossa recomendação consultiva é decidir por prova de conceito com a carga real, comparando tempo de job, estabilidade e esforço operacional, e não por benchmarks de fornecedor.
6. Medição de sucesso
KPIs técnicos
O principal indicador técnico é a razão entre a banda efetiva em coletivas (por exemplo, busbw do NCCL) e a taxa nominal do enlace. Acompanhe também a latência de cauda, a taxa de erros pré e pós-FEC, a frequência de flaps e a utilização por porta ao longo do tempo.
Esses números devem ser coletados continuamente, e não apenas na aceitação. Degradações lentas de óptica são o problema mais frequente na operação de 800G.
KPIs de negócio
Do lado do negócio, os indicadores relevantes são o tempo de conclusão de jobs de treinamento, a utilização efetiva das GPUs, o custo por GPU-hora aproveitada e o prazo entre a chegada do hardware e o primeiro job em produção. A NVIDIA cita ganhos em time-to-operation com CPO, e esse é um indicador que vale medir.
| Indicador | O que revela | Frequência |
|---|---|---|
| Banda efetiva em coletivas / taxa nominal | Eficiência real do fabric | Semanal e a cada mudança |
| Erros pré-FEC e flaps de link | Saúde da óptica e do cabeamento | Contínua |
| Tempo de conclusão de job | Impacto direto no negócio | Por job |
| Utilização efetiva de GPU | Retorno sobre o capex de aceleradores | Contínua |
| Tempo da chegada do hardware ao primeiro job | Eficiência de implantação | Por projeto |
| Consumo de energia por Tb/s | Eficiência energética e TCO | Mensal |
Avaliação de eficácia
Estabeleça uma linha de base antes da migração, com a mesma carga de trabalho no fabric atual, e compare depois da implantação. Sem baseline, qualquer ganho é anedótico. Revise os números a cada trimestre, pois firmware, drivers e bibliotecas coletivas evoluem rapidamente.
Conclusão
O InfiniBand XDR 800G está em produção. Os switches Quantum-X800 (Q3400-RA e Q3200-RA), os adaptadores ConnectX-8 e, mais recentemente, o ConnectX-9 compõem um ecossistema maduro para clusters de IA e HPC de grande escala. A variante com fotônica co-packaged já tem implantações iniciais em 2026, embora ainda seja cedo para generalizar seus ganhos.
Ao mesmo tempo, o mercado deixou de ser monopólio do InfiniBand. O Ethernet de 800G conquistou a maior parte das vendas em back-end de IA segundo a Dell’Oro, e a decisão correta depende de carga de trabalho, escala, equipe e estratégia de fornecedores. Para quem usa ou planeja GPUs Blackwell Ultra e Rubin, o XDR é uma escolha natural; para ambientes Hopper ou sensíveis a custo, o NDR ainda pode fazer sentido.
Em perspectiva (roadmap, não confirmado em produção), a evolução natural é 1,6 Tb/s por porta, com GDR e lanes de 400 Gb/s. O ConnectX-9 já entrega até 1,6 Tb/s às GPUs Rubin, e a disponibilidade de sistemas Vera Rubin é indicada para o segundo semestre de 2026 por parceiros de nuvem e OEMs.
Próximos passos práticos: (1) mapear o plano de GPUs para os próximos 36 meses; (2) definir o baseline de desempenho da rede atual; (3) validar a compatibilidade de servidores com PCIe Gen6; (4) levantar requisitos de energia e refrigeração, inclusive líquida; (5) executar uma prova de conceito comparando InfiniBand XDR e Ethernet de 800G com a carga real.