
Guia Estratégico de MLOps 2026
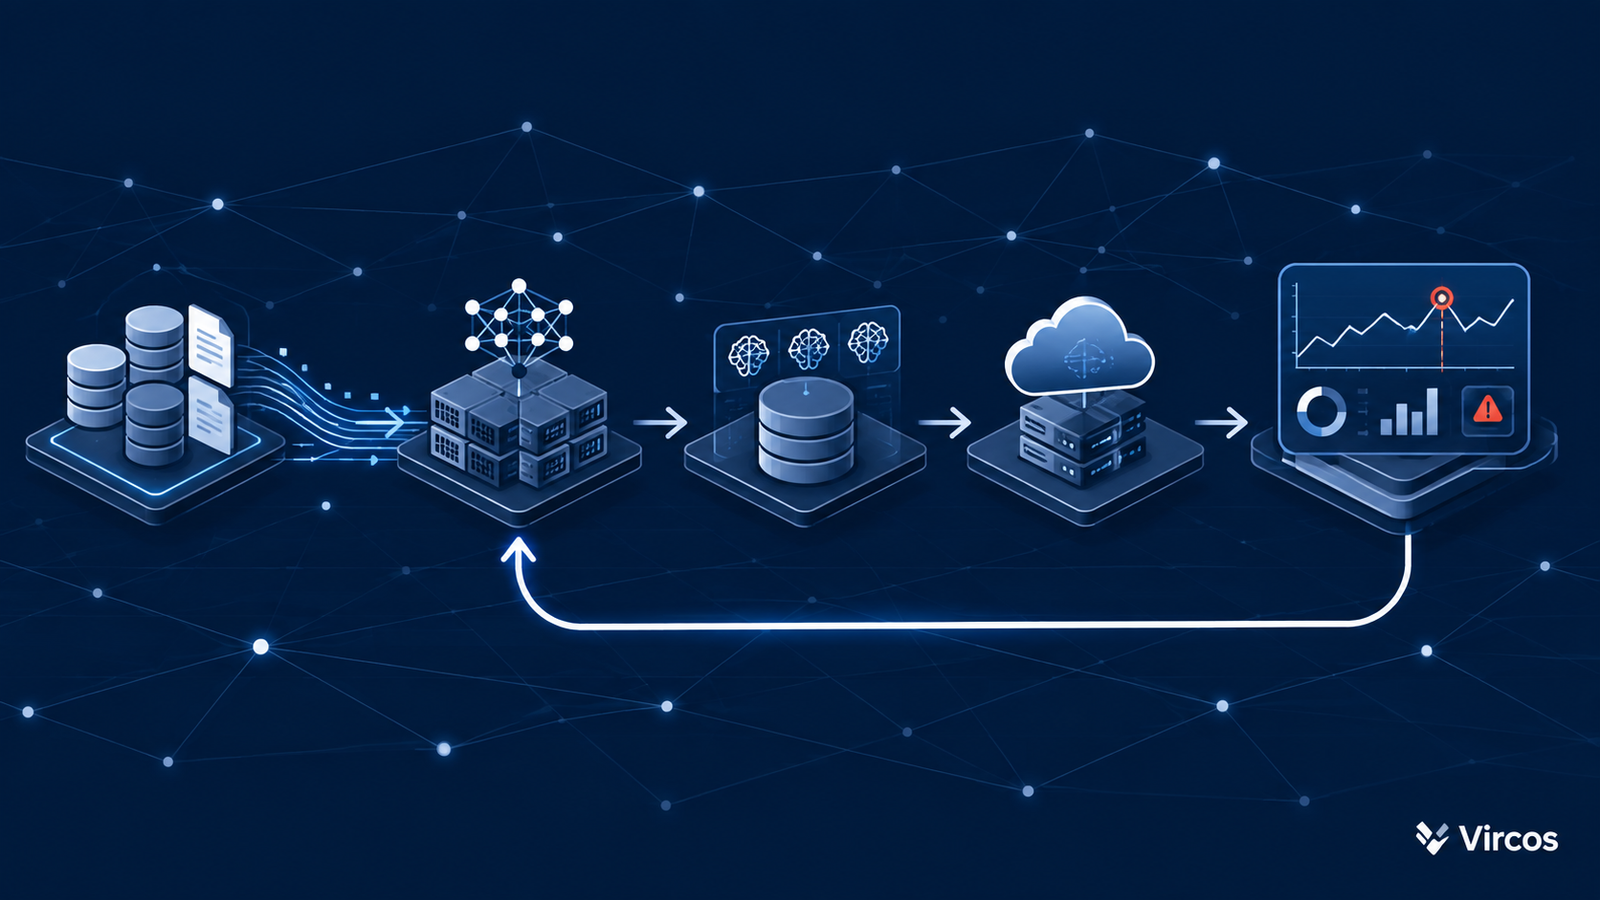
Machine Learning em Produção: Do Protótipo à Operação Confiável com MLOps
Em 2026, treinar um modelo deixou de ser a parte difícil. O gargalo está em colocar machine learning em produção e mantê-lo confiável, auditável e economicamente viável ao longo do tempo. É nessa etapa que a maioria dos investimentos em IA se perde.
Os números de mercado apontam na mesma direção. Segundo a Gartner (fevereiro de 2025), as organizações abandonarão 60% dos projetos de IA que não tiverem dados preparados para IA ao longo de 2026. Na mesma pesquisa, feita com 248 líderes de gestão de dados no terceiro trimestre de 2024, 63% das organizações disseram não ter, ou não saber se têm, as práticas de dados adequadas.
Uma pesquisa da S&P Global (2025), com 1.006 respondentes na América do Norte e na Europa, indica que 42% das empresas abandonaram a maior parte de suas iniciativas de IA antes da produção. Como o dado é autodeclarado, vale lê-lo como sinal de tendência, não como taxa universal.
Custos de infraestrutura ociosa, retrabalho de times de dados, decisões automatizadas com modelos degradados e exposição regulatória formam o preço da inação. Este guia mostra por que projetos travam, o que a disciplina de MLOps resolve e como implementar, governar e medir uma operação madura.
1. O problema estratégico: do notebook ao sistema em produção
Um modelo validado em notebook é um experimento. Um modelo em produção é um sistema de software que depende de dados vivos, infraestrutura de inferência, integração com processos de negócio e responsáveis claros. A distância entre os dois é maior do que a maioria dos orçamentos prevê.
Por que o protótipo não escala sozinho
Em produção, o modelo precisa receber dados no mesmo formato e com a mesma qualidade do treino, responder dentro de um limite de latência e conviver com sistemas legados. Um cenário ilustrativo: um modelo de detecção de fraude que performa bem em ambiente controlado pode falhar quando não consegue acessar transações em tempo real.
Esse tipo de falha raramente vem do algoritmo. Vem da integração de dados, do desenho da infraestrutura e da ausência de responsabilidade operacional depois do deploy.
Implicações técnicas e de negócio
Do ponto de vista técnico, a operação exige versionamento de dados, código e artefatos, pipelines reprodutíveis e observabilidade. Do ponto de vista de negócio, exige um dono para a métrica que o modelo move e um critério claro de quando intervir.
A própria Gartner enquadra a prontidão de dados como prática contínua, que começa no nível executivo. Não se trata de uma checklist técnica entregue uma única vez pela engenharia.
2. Consequências da inação
Riscos específicos
Modelos em produção sofrem dois tipos de degradação. O data drift ocorre quando a distribuição dos dados de entrada muda. O concept drift ocorre quando muda a relação entre entrada e resultado esperado. Sem monitoramento, ambos passam despercebidos até que um indicador de negócio piore.
Há também o risco de conhecimento concentrado. Se o pipeline depende de scripts manuais mantidos por uma ou duas pessoas, a saída delas interrompe a capacidade de retreinar, corrigir ou auditar o modelo.
Custos de oportunidade e desvantagem competitiva
Empresas com deploy manual levam mais tempo para cada iteração, e cada ciclo lento é um ciclo em que concorrentes aprendem com dados mais recentes. O custo de oportunidade aparece como casos de uso que nunca saem da fila de priorização.
Existe ainda o custo de credibilidade. Segundo a Gartner, o abandono de projetos costuma surgir em revisões orçamentárias, quando o retorno não é demonstrado. Um programa que perde a confiança da diretoria dificilmente recupera orçamento no ciclo seguinte.
3. Fundamentos da solução: MLOps como disciplina de engenharia
MLOps aplica ao ciclo de vida de machine learning as práticas de engenharia de software: CI/CD, controle de versão, testes automatizados e monitoramento. O objetivo é tornar previsível o que hoje depende de esforço individual.
Os quatro pilares operacionais
O guia de referência do Google Cloud sobre automação de pipelines de ML distingue quatro práticas. A integração contínua (CI) testa código, dados e modelos. A entrega contínua (CD) implanta um pipeline de treinamento que, por sua vez, implanta o serviço de predição. O treinamento contínuo (CT) retreina modelos automaticamente. O monitoramento contínuo (CM) acompanha dados de produção e métricas de desempenho.
O treinamento contínuo é a novidade em relação ao DevOps tradicional. Em software comum, o código muda quando o time decide. Em ML, o desempenho pode cair mesmo sem nenhuma alteração de código, porque o mundo mudou.
Níveis de maturidade
O mesmo guia descreve três níveis, úteis para um diagnóstico honesto do ponto de partida:
| Nível | Característica | Risco principal |
|---|---|---|
| 0 – Processo manual | Treino e deploy manuais, sem CI/CD nem monitoramento ativo | Baixa reprodutibilidade e dependência de pessoas |
| 1 – Automação do pipeline de ML | Treinamento contínuo automatizado e entrega contínua do serviço de predição | O próprio pipeline ainda é implantado manualmente |
| 2 – Automação de CI/CD | Implantação automatizada do pipeline, com testes e validações | Complexidade de governança e de plataforma |
Uma fonte secundária de 2026 sugere que a maioria das organizações está entre os níveis 1 e 2. Para a maior parte das empresas, o objetivo realista é chegar ao nível 1 com qualidade antes de investir em plataformas sofisticadas.
4. Implementação estratégica
Abordagem metodológica
Comece por um caso de uso com métrica de negócio clara, não por uma plataforma. Defina antes da construção qual resultado justifica o investimento e quem responde por ele. Esse é o antídoto contra o padrão de pilotos que nunca chegam a produção.
Depois, estabeleça a base de reprodutibilidade: versionamento de dados, código e modelos, e um model registry que funcione como fonte única da verdade. Em um registry típico, os modelos transitam por estágios como Staging, Production e Archived, com aprovações em cada transição.
Considerações críticas
Uma feature store, plataforma centralizada para gerenciar e servir features, reduz o risco de divergência entre os dados usados no treino e os usados na inferência. Essa divergência é uma das causas mais comuns de modelos que funcionam no laboratório e falham em produção.
Decida também o padrão de serviço: inferência em lote, em tempo real ou na borda. A escolha afeta custo, latência e a necessidade de GPUs, e deve seguir o requisito de negócio, não a preferência da equipe técnica.
Pontos de falha potenciais
Os pontos de falha mais frequentes são: pipelines sem testes de validação de dados, retreinamento agendado por calendário em vez de por evento, e ausência de critério de rollback. Um modelo novo só deve substituir o atual depois de passar por validação automatizada e, quando possível, por testes A/B ou implantação gradual.
Outro ponto é o custo de inferência, que cresce com o uso. Incorpore estimativas de custo por predição desde a fase de desenho, porque corrigir isso depois do lançamento é caro.
5. Melhores práticas avançadas
Monitoramento em camadas
Monitore simultaneamente o modelo (acurácia, F1), os dados (drift de features, medido por exemplo pelo Population Stability Index, o PSI), as predições (mudanças na distribuição das saídas) e a infraestrutura (latência de inferência). Segundo guias de 2026, fluxos de retreinamento disparados por eventos vêm substituindo os agendados por calendário, que reagem tarde às mudanças reais dos dados.
Em aplicações de LLM, acrescente o versionamento de prompts com o mesmo rigor do código, registrando qual versão gerou cada saída em produção. Para sistemas agênticos, o KDnuggets aponta o AgentOps como tendência de 2026, por exigir observabilidade de memória e planejamento dos agentes, algo que o MLOps clássico não cobre.
Governança e conformidade regulatória
O quadro regulatório mudou neste ano. O Digital Omnibus on AI entrou em vigor em 27 de julho de 2026 e adiou as obrigações de sistemas de alto risco do Anexo III do EU AI Act (como emprego, crédito e educação) de 2 de agosto de 2026 para 2 de dezembro de 2027. Os sistemas do Anexo I, embarcados em produtos regulados, passaram para 2 de agosto de 2028.
O adiamento não é um cancelamento. As obrigações de transparência do Artigo 50 seguem valendo desde 2 de agosto de 2026, com carência até 2 de dezembro de 2026 para a marcação de conteúdo sintético em sistemas já no mercado. Para alto risco, o que virá inclui gestão de riscos, documentação técnica, supervisão humana e monitoramento pós-mercado, itens que uma operação MLOps madura já produz como subproduto.
No Brasil, o PL 2338/2023 foi aprovado pelo Senado em 10 de dezembro de 2024. Segundo o registro de dados abertos da Câmara, reportado pela CASRAI, ele seguia em setembro de 2026 na situação “Aguardando Parecer”, sem efeito legal. Vale acompanhar a tramitação, e a LGPD continua aplicável a dados pessoais usados em treino e inferência.
Segurança e explicabilidade
Controle acesso ao registry e aos pipelines, registre a linhagem dos artefatos e trate dados de treino como ativos sensíveis. A explicabilidade operacional também ganha peso em 2026: o KDnuggets a descreve como capacidade de produção, demandada por auditores, reguladores e áreas de negócio, e útil para detectar drifts prejudiciais.
6. Medição de sucesso
Métricas técnicas
Acompanhe o tempo entre a aprovação de um modelo e seu deploy, a frequência de retreinamento, o tempo de detecção e de correção de drift e a disponibilidade do serviço de inferência. Esses indicadores mostram se o pipeline é realmente automatizado ou só parece ser.
Inclua métricas de qualidade de dados e a proporção de modelos com monitoramento ativo. Um portfólio em que apenas parte dos modelos é monitorada carrega risco invisível.
Métricas de negócio
A métrica decisiva é o impacto no indicador para o qual o modelo foi criado: redução de perdas por fraude, ganho de conversão, economia operacional. Sem essa ligação, o time de dados fica sem argumento no ciclo orçamentário seguinte.
Meça também o custo por predição e o custo total de operação. Indicadores de custo ajudam a decidir entre manter, otimizar ou aposentar um modelo.
Avaliação de eficácia
Reavalie a maturidade a cada semestre contra os níveis da seção 3. O mercado de MLOps reflete essa urgência: a Persistence Market Research (setembro de 2026) projeta US$ 4,27 bilhões em 2026, chegando a US$ 48,47 bilhões em 2033 (CAGR de 41,5%), com software e plataformas respondendo por cerca de 74% do segmento. Outras consultorias divulgam valores próximos, mas não idênticos, como US$ 4,38 bilhões para 2026, então trate as projeções como ordem de grandeza.
Conclusão
O principal ponto é que o sucesso de machine learning em produção depende menos do modelo e mais do sistema ao redor dele: dados preparados, pipelines automatizados, monitoramento contínuo, governança clara e métricas ligadas ao negócio.
Em termos de implementação, comece pequeno e mensurável, suba para o nível 1 de maturidade com qualidade e só então avance para CI/CD completo. A regulação reforça esse caminho. O adiamento do alto risco na UE dá prazo até dezembro de 2027, mas a documentação e o monitoramento que ele exigirá levam tempo para amadurecer.
Olhando adiante, a operação de sistemas com LLMs e agentes tende a ampliar o escopo do MLOps, com versionamento de prompts, observabilidade de agentes e explicabilidade como capacidades padrão.


