Guia Estratégico de Infraestrutura para IA 2026
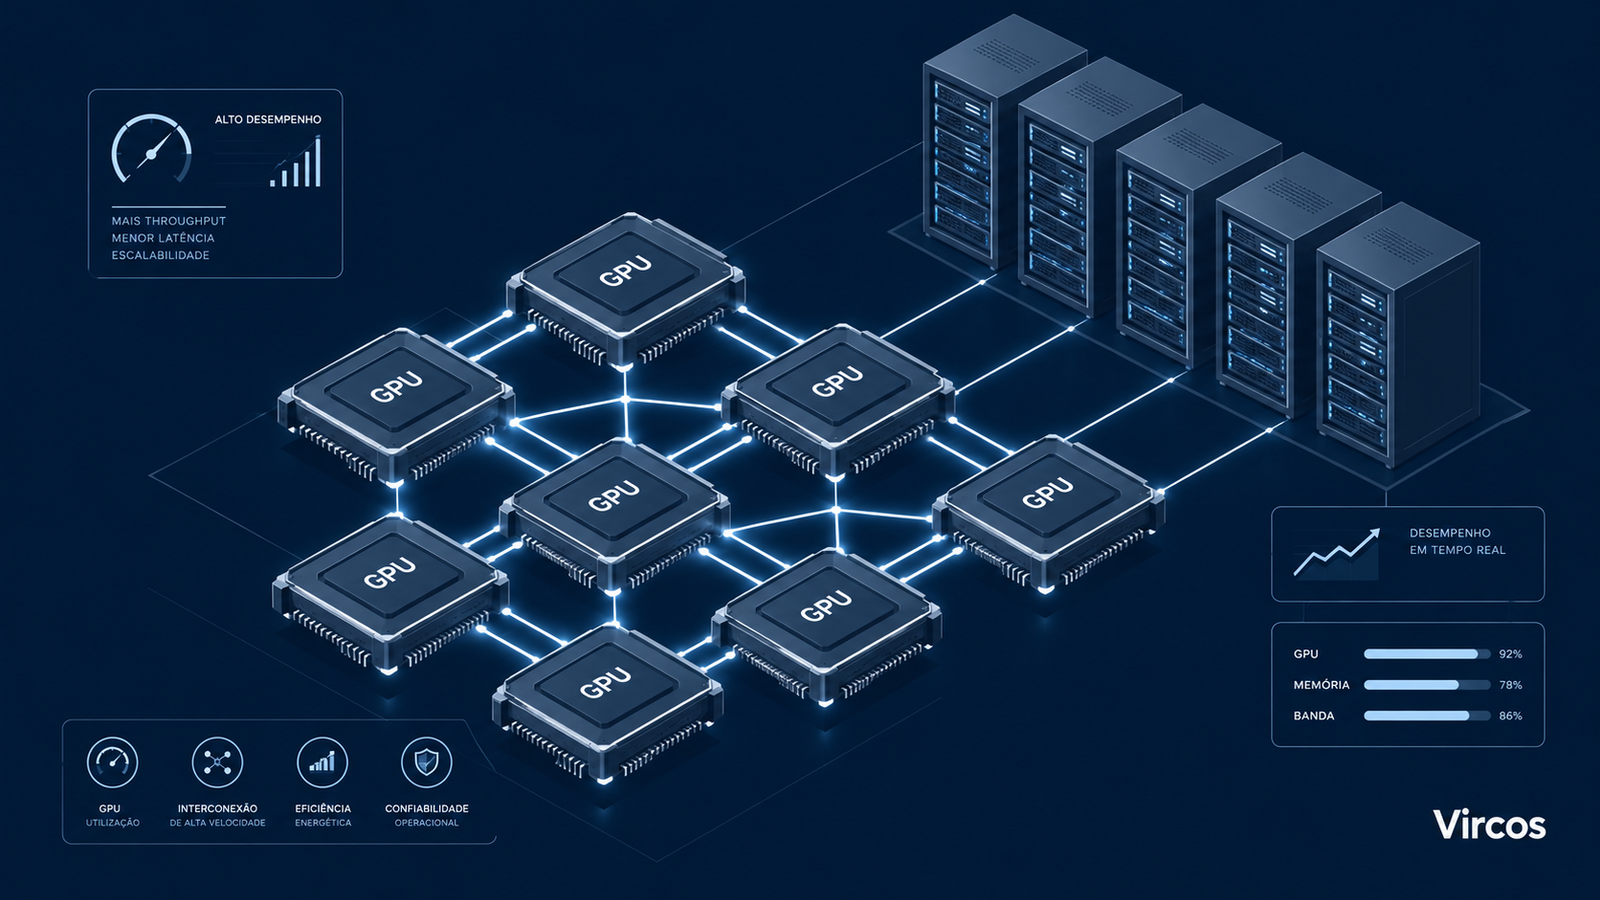
Em 2026, a pergunta central de quem planeja infraestrutura de IA deixou de ser quantas GPUs comprar e passou a ser como essas GPUs se comunicam entre si. Modelos Mixture-of-Experts, simulações de engenharia e serviços de inferência com milhares de usuários simultâneos já não cabem em uma única placa e, cada vez mais, nem em um único servidor.
O desafio é crítico porque a configuração multi-GPU não escala por simples soma. Sem interconexão adequada, estratégia de paralelismo coerente e projeto de energia e refrigeração, parte relevante do investimento fica ociosa, esperando dados que trafegam por caminhos estreitos demais.
O custo da decisão errada aparece de duas formas: capital imobilizado em hardware subutilizado e atraso de projetos que entrega vantagem a concorrentes. Um único rack de GPUs de última geração, por exemplo, pode exigir cerca de 120 kW de potência, segundo integradores e fabricantes, e essa é uma infraestrutura que não se corrige depois da compra.
Este guia analisa o problema estratégico, as consequências da inação, os fundamentos técnicos (NVLink, UALink e PCIe), a implementação, as melhores práticas e as métricas de sucesso, sempre com dados de 2025 e 2026.
O problema estratégico: quando uma GPU não basta
O muro da memória
Uma GPU de ponta como a B300 (Blackwell Ultra) oferece 288 GB de memória HBM3e com até 8 TB/s de largura de banda, segundo a NVIDIA e análises de mercado. Parece muito, mas modelos de fronteira, janelas de contexto longas e o cache KV de muitos usuários simultâneos consomem essa capacidade rapidamente.
A resposta de arquitetura é agregar memória. O rack GB300 NVL72 reúne 72 GPUs em um único domínio NVLink, formando cerca de 20 TB de HBM3e utilizável, conforme o SemiAnalysis InferenceX. Na outra ponta do espectro, um servidor com oito placas RTX PRO 6000 Blackwell soma 768 GB de GDDR7 (8 × 96 GB, cálculo próprio). São escalas diferentes, para problemas diferentes.
Na prática, o primeiro passo de qualquer projeto é medir quanta memória o modelo e a carga exigem. Essa conta define se a solução é um servidor de 2 a 8 GPUs, um rack inteiro ou um cluster com vários racks.
O muro da comunicação
Memória agregada só gera valor se as GPUs conseguirem trocar dados rápido o bastante. Quando um modelo é dividido, os aceleradores sincronizam tensores a cada camada ou a cada passo de treinamento, e qualquer gargalo vira tempo ocioso de hardware caro.
Um relatório técnico da NVIDIA sobre o Megatron-Core MoE (março de 2026) descreve a parede de comunicação como um dos três obstáculos acoplados no treinamento de modelos MoE. Nesses modelos, o paralelismo de especialistas exige troca intensa de tokens entre GPUs, o que pressiona diretamente a interconexão.
Para o negócio, a implicação é direta: cada ponto percentual de GPU esperando dados é custo de capital e energia sem retorno. Por isso, a topologia de rede importa tanto quanto a escolha do acelerador.
Consequências da inação (ou da implementação inadequada)
Riscos técnicos e financeiros
Subdimensionar a interconexão é o erro clássico. Um servidor com várias GPUs conectadas apenas por PCIe pode funcionar bem em certas cargas, mas degradar fortemente quando o modelo é dividido entre placas com paralelismo de tensor, que exige troca de dados a cada camada.
O erro oposto também é caro. Segundo a análise da OpenMetal, a RTX PRO 6000 Blackwell atende bem inferência com uma ou poucas GPUs para modelos de até cerca de 70 bilhões de parâmetros e ajuste fino em escala LoRA/QLoRA. Contratar um rack NVLink completo para essa carga seria pagar por capacidade que não será usada.
Custos de oportunidade e desvantagem competitiva
A eficiência por GPU melhora a cada geração. A NVIDIA afirma que o Vera Rubin NVL72 treina grandes modelos MoE com um quarto das GPUs necessárias na plataforma Blackwell e entrega até 10 vezes mais throughput de inferência por watt, a um décimo do custo por token. São alegações do fabricante, com valores preliminares, mas indicam a direção do mercado.
Empresas que planejam bem reduzem o custo por token e por experimento mais rápido que as demais. Quem adia o planejamento acaba comprando às pressas, com menos opções e prazos de entrega mais longos.
Risco de dependência de fornecedor
A decisão multi-GPU também é uma decisão sobre ecossistema. O NVLink é proprietário e maduro, enquanto a AMD aposta em padrões abertos (UALink e Ultra Ethernet) com seu rack Helios. Cada caminho tem trade-offs de maturidade de software, disponibilidade e flexibilidade que devem entrar na análise de risco.
Fundamentos da solução: como GPUs se conectam
Scale-up versus scale-out
Há dois níveis de conexão. O scale-up liga GPUs dentro de um mesmo domínio de alta banda (servidor ou rack), onde elas operam quase como uma única máquina. O scale-out liga domínios entre si por redes como InfiniBand ou Ethernet.
A diferença de ordem de grandeza é grande. No GB300 NVL72, o domínio NVLink atinge 130 TB/s agregados, enquanto a rede externa soma 57,6 Tb/s (cada GPU com uma SuperNIC ConnectX-8 de 800 Gb/s), ou 7,2 TB/s. Isso significa que o tráfego interno tem cerca de 18 vezes mais banda que o externo (cálculo próprio a partir de dados da Oxmaint e da Spheron).
Essa assimetria orienta o projeto: o que depende de banda extrema deve ficar dentro do domínio scale-up, e apenas o que tolera mais latência cruza a rede.
NVLink: a referência proprietária
A quinta geração do NVLink entrega 1,8 TB/s por GPU, em 18 links, nas plataformas Blackwell. No GB300 NVL72, 72 GPUs formam um domínio único, e um servidor HGX B300 de oito GPUs chega a 14,4 TB/s de banda NVLink agregada, segundo a AceCloud.
A sexta geração, que acompanha o Vera Rubin NVL72, dobra a banda para 3,6 TB/s por GPU e 260 TB/s por rack, conforme o blog técnico da NVIDIA. De acordo com a Inside Deep Tech, que cita a teleconferência de resultados da empresa, os envios de produção começaram em agosto de 2026; o acesso amplo para a maioria das empresas deve ocorrer em 2027, segundo a Metro Colo Advisory.
UALink e Ultra Ethernet: a alternativa aberta
O rack Helios da AMD combina 72 aceleradores Instinct MI455X, 31 TB de HBM4 e até 2,9 exaFLOPS em FP4 (valores de pico), de acordo com a Tom’s Hardware. O scale-up usa Infinity Fabric com UALink, com até 260 TB/s no rack, e o scale-out usa Ultra Ethernet, com até 43 TB/s, segundo a Supermicro.
Há ressalvas importantes. O ServeTheHome informa que o UALink trafega sobre Ethernet (UALoE) no Helios, e a Tom’s Hardware lembra que a adoção ampla depende de fornecedores entregarem silício de switch na segunda metade de 2026. Além disso, as fontes consultadas indicavam que benchmarks independentes em nível de rack ainda não estavam disponíveis em junho de 2026, portanto convém validar desempenho real antes de decidir.
PCIe: a opção de entrada
A RTX PRO 6000 Blackwell oferece 96 GB de GDDR7, mas não tem suporte a NVLink e usa PCIe Gen 5 x16. Segundo a Lenovo, um slot PCIe Gen 5 x16 provê 128 GB/s, cerca de 14 vezes menos que o 1,8 TB/s do NVLink 5 (cálculo próprio).
Isso não inviabiliza a plataforma. Para inferência com muitas requisições concorrentes, o paralelismo de pipeline reduz o volume de comunicação entre placas, e fornecedores como a Petronella defendem que ele aproxima o throughput de sistemas NVLink mais caros. Trata-se de uma afirmação de fornecedor, que deve ser testada com a sua carga.
Comparativo das plataformas
A tabela resume as principais opções, com valores de pico informados por fabricantes e fontes de mercado.
| Plataforma | Domínio scale-up | Interconexão | Banda por GPU | Status (out/2026) |
|---|---|---|---|---|
| HGX B300 | 8 GPUs | NVLink 5 | 1,8 TB/s | Disponível |
| GB300 NVL72 | 72 GPUs | NVLink 5 | 1,8 TB/s | Em operação desde 2025 |
| Vera Rubin NVL72 | 72 GPUs | NVLink 6 | 3,6 TB/s | Envios iniciados em ago/2026 |
| AMD Helios | 72 GPUs | UALink / UALoE | ~3,6 TB/s* | Meta de disponibilidade geral: 2S 2026 |
| 8x RTX PRO 6000 Blackwell | Sem domínio dedicado | PCIe Gen 5 x16 | ~128 GB/s (bidirecional) | Disponível |
*Derivado de 260 TB/s divididos por 72 GPUs (cálculo próprio).
Implementação estratégica
Comece pela carga de trabalho, não pelo hardware
O ponto de partida é caracterizar a carga: tamanho do modelo, precisão numérica, padrão de comunicação e perfil de uso (treinamento contínuo, ajustes pontuais ou inferência em produção). Esses fatores determinam quanta memória e quanta banda entre GPUs são realmente necessárias.
Um projeto de inferência com modelos de até 70 bilhões de parâmetros tem requisitos muito diferentes de um treinamento MoE de centenas de bilhões. Tratar os dois como o mesmo problema é a origem da maioria dos projetos superdimensionados ou subdimensionados.
Escolha da estratégia de paralelismo
O paralelismo de dados replica o modelo e sincroniza gradientes uma vez por passo. O de tensor divide cada camada entre GPUs e exige comunicação intensa. O de pipeline divide o modelo em estágios sequenciais, trocando apenas ativações nas fronteiras.
Modelos MoE adicionam o paralelismo de especialistas, que distribui especialistas entre GPUs e gera tráfego do tipo all-to-all. O Megatron-Core MoE combina cinco dimensões (tensor, especialistas, contexto, dados e pipeline) justamente porque nenhuma isolada resolve o problema, segundo o relatório da NVIDIA de março de 2026.
A regra prática é manter os padrões mais intensivos em comunicação (tensor e especialistas) dentro do domínio de maior banda, deixando pipeline e dados atravessarem a rede externa. A NVIDIA também publicou o NCCL EP, biblioteca construída sobre a Device API do NCCL para comunicação de especialistas, o que mostra que essa camada de software evolui junto com o hardware.
Pontos de falha potenciais
O primeiro ponto de falha é a incompatibilidade entre estratégia e topologia, como rodar paralelismo de tensor por PCIe. O segundo é o desbalanceamento entre especialistas, que deixa algumas GPUs sobrecarregadas enquanto outras esperam.
O terceiro é a falha de hardware em jobs longos. Em clusters grandes, falhas de GPU ou de link são eventos esperados, e a ausência de checkpoints frequentes e de procedimentos de recuperação transforma um defeito pontual em dias de trabalho perdido.
Melhores práticas avançadas
Energia e refrigeração como requisito de projeto
O GB300 NVL72 é um rack de 48U totalmente refrigerado a líquido e com consumo em torno de 120 kW, segundo a Oxmaint. A Microsoft descreveu configurações de até 136 kW por gabinete, de acordo com a AceCloud. O Helios usa um rack de largura dupla no padrão OCP, conforme análise da Jared Watkins.
Para o Vera Rubin NVL72, as fontes divergem: algumas indicam 120 a 130 kW, outras 190 a 230 kW. Confirme sempre o valor no datasheet oficial do fornecedor antes de dimensionar energia, refrigeração e piso do datacenter.
Software, validação e observabilidade
Antes de levar cargas à produção, valide a rede com testes de coletivas (como o nccl-tests) e compare o resultado com o valor teórico. A Verda reportou, em teste multi-nó em NVL72, banda de barramento média de cerca de 837 GB/s, um bom ponto de referência para calibrar expectativas.
Em ambientes AMD, a maturidade do ROCm e a compatibilidade com seus frameworks merecem testes específicos. O ServeTheHome relata que a AMD vem investindo em facilitar a migração a partir do CUDA, mas a migração real depende de cada código e biblioteca.
Governança, segurança e compliance
Clusters multi-GPU concentram dados sensíveis e propriedade intelectual. Defina controle de acesso por projeto, isolamento entre cargas e trilhas de auditoria, especialmente quando houver dados pessoais sujeitos à LGPD em treinamento ou ajuste fino.
Recursos como o Multi-Instance GPU (MIG) permitem dividir uma GPU em instâncias isoladas, útil em ambientes compartilhados. O número de instâncias varia conforme a edição do produto, então consulte a ficha técnica do modelo adquirido.
Medição de sucesso
Indicadores técnicos
Acompanhe a utilização das GPUs e a eficiência de escala, ou seja, quanto do ganho teórico você obtém ao adicionar placas. Meça também a banda efetiva das coletivas contra o valor teórico e o goodput, que é a fração do tempo em trabalho útil, descontando falhas e reinícios.
Para inferência, os indicadores centrais são tokens por segundo, tempo até o primeiro token e latência no percentil 95. Eficiência energética, medida em tokens por watt, conecta o desempenho ao custo operacional.
Indicadores de negócio
No nível executivo, os KPIs relevantes são custo por token ou por experimento, tempo até colocar um modelo em produção e taxa de ocupação do ativo ao longo do tempo. Um cluster com alta utilização e baixo custo por unidade entregue sustenta o argumento de retorno do investimento.
Revise essas métricas a cada trimestre. A evolução rápida de hardware e software pode mudar o ponto de equilíbrio entre comprar, alugar capacidade em nuvem ou combinar as duas abordagens.
Conclusão
A infraestrutura multi-GPU em 2026 é uma decisão de arquitetura, não apenas de compra. A interconexão (NVLink, UALink ou PCIe), a estratégia de paralelismo e o projeto de energia e refrigeração determinam se o investimento se converte em desempenho ou em hardware ocioso.
O mercado se organiza em torno de racks de 72 GPUs: o GB300 NVL72 em operação, o Vera Rubin NVL72 em ramp-up desde agosto de 2026 e o AMD Helios com disponibilidade prevista para a segunda metade do ano. Para muitas empresas, porém, servidores de 2 a 8 GPUs com PCIe ou NVLink continuam sendo a escolha mais racional.
Olhando adiante, o roadmap da NVIDIA inclui o Rubin Ultra NVL576, com meta de 2027, e racks com potência na casa de centenas de kW, segundo a Metro Colo Advisory. Trata-se de roadmap, sujeito a mudanças.
Como próximos passos práticos, caracterize suas cargas de trabalho, execute um piloto com benchmarks próprios, valide energia e refrigeração com o fornecedor e só então decida a plataforma. Essa sequência reduz o risco de comprar a configuração errada.