Escalabilidade de Cluster GPU: Guia Estratégico para 2026
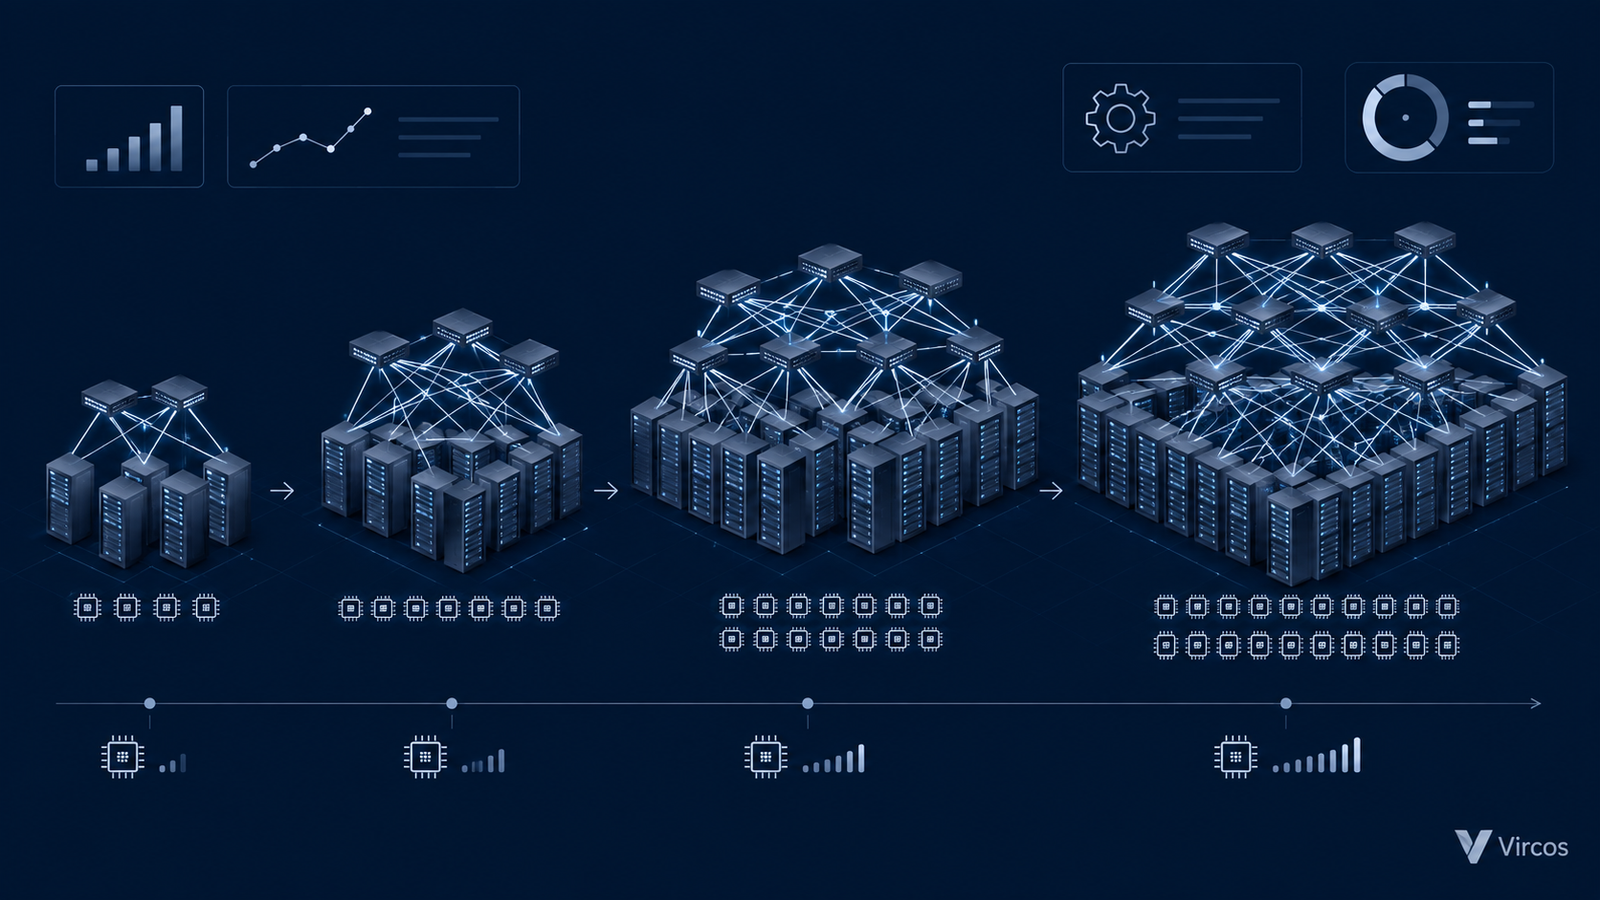
Em 2026, escalar um cluster deixou de ser uma questão de comprar mais servidores. Escalabilidade de cluster passou a ser uma disciplina que combina arquitetura de rede, tolerância a falhas, orquestração e economia de capacidade. Organizações que tratam o crescimento como simples expansão linear descobrem, quase sempre tarde demais, que a eficiência por GPU cai conforme o ambiente cresce.
O desafio é que os gargalos mudam de lugar a cada salto de escala. Com poucos nós, o limite costuma ser a memória da GPU. Com dezenas de racks, a rede passa a ditar o tempo de conclusão dos jobs. Com milhares de aceleradores, a confiabilidade se torna o fator dominante, porque falhas deixam de ser exceção e viram rotina operacional.
O custo de errar é alto. Uma rede subdimensionada deixa GPUs caras esperando sincronização, e uma estratégia de checkpointing mal calibrada desperdiça horas de computação a cada falha. Já a superdimensionação imobiliza capital em infraestrutura que ainda não tem carga para justificá-la.
Neste artigo, analisamos o problema estratégico da escalabilidade, as consequências de não enfrentá-lo, os fundamentos técnicos da solução, a implementação em estágios, as melhores práticas avançadas e as métricas que comprovam resultado. Todos os dados citados são de 2025 e 2026, com as devidas indicações de fonte.
O problema estratégico: escalar não é crescer em linha reta
Por que a escala muda a natureza do problema
A NADDOD, fornecedora de interconexão óptica, resume bem o ponto ao afirmar que um cluster de 100 mil GPUs não é uma expansão linear de um cluster de 10 mil, e sim uma reestruturação fundamental da arquitetura de rede. Segundo a empresa, em 2026 clusters dessa ordem já saíram do planejamento e entraram em implantação.
Isso importa mesmo para quem opera ambientes menores. As decisões tomadas no primeiro cluster, como topologia, velocidade de porta e modelo de armazenamento, definem o teto de crescimento dos próximos anos. Remediar essas escolhas depois costuma significar reconstruir a malha de rede, não apenas ampliá-la.
Um guia de redes para IA on-premises publicado pela Network Devices (2026) descreve esse percurso em estágios. Até cerca de 128 GPUs, distribuídas em alguns racks, o tráfego leste-oeste entre servidores cresce de forma pronunciada e passa a exigir planejamento deliberado de oversubscription e de comportamento sem perdas.
Implicações técnicas e de negócio
Do ponto de vista técnico, a pergunta central é quanto da malha de rede pode ser reaproveitada. A Mirantis (2026) observa que, em implantações de IA, a rede costuma representar 15% ou menos do custo total, e que reutilizar switches existentes frequentemente resulta em pior relação preço/desempenho. Um relatório do setor sobre redes de data center em 2026 estima esse peso em cerca de 10% do custo de um cluster de IA.
Esse número muda a conversa de negócio. Economizar em uma parcela tão pequena do investimento, ao custo de ociosidade em GPUs que representam a maior parte do orçamento, raramente fecha a conta. A rede deve ser dimensionada pelo que ela impede de desperdiçar.
Para clusters menores, a mesma fonte indica que, abaixo de 500 GPUs, um ou dois switches físicos frequentemente bastam. Acima desse patamar, uma malha Ethernet dedicada para IA se justifica. Reconhecer em qual faixa a organização está evita tanto o excesso quanto a falta de infraestrutura.
Consequências da inação: o preço da ineficiência em escala
Falhas deixam de ser eventos raros
Dados de pesquisa da Meta, replicados por análises da Crusoe e da CoreWeave, mostram a relação inversa entre tamanho do cluster e confiabilidade. Com 8 GPUs, o tempo médio entre falhas é de cerca de 47 dias. Com 1.024 GPUs, cai para aproximadamente 8 horas, e com 16.384 GPUs, para cerca de 1,8 hora.
No treinamento do Llama 3, a Meta registrou 419 interrupções inesperadas em 54 dias em 16.384 GPUs H100, o que equivale a uma falha a cada três horas em média. Uma análise acadêmica de 2026 projeta que um job de 131.072 GPUs teria tempo médio até falha de cerca de 14 minutos. Trata-se de uma projeção, não de uma medição em produção.
Um dado da Crusoe ilustra o efeito financeiro: falhas afetaram apenas 0,2% dos jobs analisados pela Meta, mas consumiram 18,7% do tempo total de execução. Os jobs maiores e mais longos concentram as falhas, e cada falha desperdiça muitas horas de GPU.
Eficiência abaixo do potencial
Em relatório citado pela CoreWeave, a Signal65 aponta que a utilização de FLOPs do modelo (MFU) em treinamentos de grande escala fica tipicamente entre 35% e 45%. O goodput, percentual do tempo gasto em trabalho útil de treinamento, gira em torno de 90% na média do setor.
Esses percentuais parecem confortáveis até serem convertidos em dinheiro. A equipe de infraestrutura do Google estima que, em um treinamento de milhares de aceleradores por várias semanas, cada 1% de goodput vale mais de um milhão de dólares, segundo análise da CUDO Compute.
Desvantagem competitiva e custo de oportunidade
Há também o desperdício silencioso. Segundo a CoreWeave, uma GPU que reduz a frequência para respeitar limites de energia ou temperatura vira um straggler permanente, obrigando todas as GPUs saudáveis a esperar na próxima barreira de sincronização. A perda não é de uma GPU, e sim da vazão agregada do job.
O resultado competitivo é direto. Quem converte o mesmo orçamento em menos tokens treinados ou menos jobs concluídos entrega modelos mais tarde e a custo maior. Em mercados em que o ciclo de iteração define vantagem, essa defasagem se acumula.
Fundamentos da solução: scale-up, scale-out e a escolha da malha
Dois eixos de crescimento
A arquitetura de clusters de IA se organiza em dois eixos. O scale-up conecta aceleradores dentro de um domínio fortemente acoplado, como o NVLink dentro de um servidor ou de um rack. O scale-out conecta esses domínios entre si por meio de uma malha de rede, usada para trocar gradientes, sincronizar atualizações e acessar armazenamento.
O relatório de redes de data center de 2026 menciona que o NVL72 chega a 72 aceleradores em um domínio de scale-up, ou 576 em configuração multi-pod, com hardware já em produção. Alternativas de scale-up baseadas em Ethernet e em outros padrões abertos aparecem como esperadas para o fim de 2026 e início de 2027, ou seja, ainda são roadmap.
Na prática, a divisão determina o desenho do software. Paralelismo de tensor tende a ficar dentro do domínio de scale-up, enquanto paralelismo de dados e de pipeline atravessa a malha de scale-out. Compreender essa fronteira orienta onde investir em largura de banda.
Ethernet versus InfiniBand em 2026
O cenário de mercado mudou de forma marcante. A Dell’Oro Group informou que o InfiniBand detinha cerca de 80% das vendas de switches de back-end de IA em 2023 (contexto histórico). Em 2025, a Ethernet o superou, e no primeiro trimestre de 2026 respondeu por cerca de dois terços das vendas de switches em clusters de IA.
A mesma análise registra um fato importante: as vendas de InfiniBand mais que triplicaram no trimestre, impulsionadas por switches de 800 Gbps que acompanham a plataforma Blackwell Ultra da NVIDIA. O mercado não é, portanto, uma disputa em que um lado desaparece. A Dell’Oro também aponta que Amazon, Microsoft, Meta, Oracle e xAI adotam Ethernet, em parte pela necessidade de diversificar fornecedores.
Para clusters de porte médio, a Computer Weekly (2025) argumenta que Ethernet é alternativa viável ao InfiniBand até alguns milhares de GPUs, considerando confiabilidade, desempenho e amplitude do ecossistema de fornecedores. Para clusters muito maiores, o relatório de redes de 2026 afirma que o prêmio de custo do InfiniBand se torna difícil de justificar.
| Critério | InfiniBand | Ethernet com RoCE v2 |
|---|---|---|
| Posição de mercado (1T 2026, Dell’Oro) | Rebote forte, vendas mais que triplicaram no trimestre | Cerca de dois terços das vendas de switches de back-end de IA |
| Diversidade de fornecedores | Ecossistema mais concentrado | Ampla, favorece vendor diversity |
| Velocidade de porta | 800 Gbps com Blackwell Ultra | 800 Gbps na maioria dos envios; 1,6 Tbps esperado em volume no 2º semestre de 2026 |
| Exemplo de escala | Cluster Azure com mais de 4.600 GPUs Blackwell Ultra (GB300 NVL72) | OCI Supercluster de 16 mil a 128 mil GPUs |
Interoperabilidade e escala observada em produção
A Oracle documenta o OCI Supercluster com rede RoCE v2, latência de cluster entre 2,5 e 9,1 microssegundos e até 3.200 Gb/s de largura de banda, escalando de 16 mil até 128 mil GPUs. A Microsoft, por sua vez, opera um cluster de produção com mais de 4.600 GPUs Blackwell Ultra em GB300 NVL72 com InfiniBand, segundo levantamento da HostingSeekers atualizado em julho de 2026.
Essas referências mostram que ambas as famílias sustentam escala de produção. A escolha depende menos de um vencedor absoluto e mais de fornecedores disponíveis, equipe de operação e integração com o software de orquestração já adotado.
Para o horizonte seguinte, a NADDOD descreve o uso de switches de 1,6 Tbps para reduzir camadas da malha, com o objetivo de sustentar 100 mil GPUs em dois níveis de rede. Menos camadas significam menos saltos, menos links e uma malha mais simples de operar.
Implementação estratégica: crescer em estágios, não em saltos
Abordagem metodológica
A implementação mais segura trata a escalabilidade como um programa, não como um projeto pontual. A Network Devices alerta que a maior parte das reconstruções de rede de GPU acontece porque as equipes planejaram para o piloto, não para o programa. Defina desde o início o tamanho-alvo do cluster em 24 a 36 meses e valide se a malha escolhida comporta esse patamar sem redesenho.
Um guia de arquitetura de produção de 2026, da markaicode, propõe como padrão uma topologia fat-tree sem bloqueio, com InfiniBand NDR400 entre nós, NVLink dentro dos nós e Kubernetes com o GPU Operator. A fonte é um guia independente de comunidade técnica e deve ser lida como referência de mercado, não como norma. O princípio útil é adicionar nós em múltiplos de 8, sem reestruturar a malha.
Em paralelo, a camada de armazenamento precisa crescer na mesma proporção. Checkpoints, datasets e artefatos compartilhados competem pela mesma infraestrutura, e um sistema de arquivos que satura interrompe o treinamento tanto quanto uma rede lenta.
Orquestração e uso eficiente de GPUs
O agendamento com reconhecimento de GPU é decisivo. A combinação de device plugin e MIG permite que um mesmo cluster atenda treinamento com GPUs inteiras e inferência com frações de GPU, sem separar manualmente os nós. A Mirantis acrescenta que tratar vários clusters como um único pool lógico reduz a fragmentação de GPUs.
Separe também as classes de carga. Filas de treinamento e de inferência com classes de prioridade distintas evitam que um job longo bloqueie atendimentos sensíveis à latência, e o tempo de espera na fila se torna um indicador direto de quando é hora de crescer.
Pontos de falha potenciais
Três pontos de falha merecem atenção prioritária. O primeiro é a rede, onde congestionamento e perda de pacotes degradam o job inteiro sem derrubá-lo. O segundo é o armazenamento de checkpoints, que pode virar o gargalo no momento da recuperação. O terceiro é o software de comunicação, já que, segundo a análise sobre falhas na Llama 3, problemas de software e rede responderam por cerca de 41% das interrupções, ao lado de falhas de GPU e NVLink (30%) e de memória HBM3 (17%).
Planeje a recuperação junto com a expansão. Nós sobressalentes, automação de substituição e testes periódicos de restauração fazem parte do projeto de escala, não de uma etapa posterior.
Melhores práticas avançadas: checkpointing, resiliência e governança
Calibrar o checkpointing
Checkpointing é um compromisso entre perda de trabalho e tempo ocioso. Salvar raramente faz cada falha descartar horas de progresso, e salvar com frequência excessiva transforma o próprio salvamento em arrasto sobre o treinamento. A AWS ilustra com um modelo teórico: checkpoints síncronos a cada 30 minutos, com 3 minutos cada, consomem 2,4 horas por dia de ociosidade e cerca de 9.600 horas de GPU diárias em um cluster de 4.000 aceleradores.
O modelo de Young e Daly fornece o ponto de partida. Segundo a CUDO Compute, para um cluster de cerca de 1.000 GPUs com aproximadamente duas falhas por dia, o intervalo ótimo fica entre uma e três horas. Esse valor depende do tempo de salvamento e do custo de reinício, e deve ser recalculado a cada mudança de escala.
Estratégias em camadas reduzem o custo. O TierCheck, proposta acadêmica de 2026, alinha o local de armazenamento ao tipo de falha e reporta tempo total de checkpoint inferior a 10 segundos em modelos de até 40 bilhões de parâmetros. O relatório técnico do Yi-Lightning descreve checkpointing assíncrono em memória como base para goodput acima de 99% em seu cluster. Ambos são resultados de pesquisa e dependem de validação no seu ambiente.
Monitoramento proativo e governança
A detecção precoce de falhas reduz o impacto. A Yi-Lightning combina descoberta proativa e reativa de falhas, e a Mirantis recomenda observabilidade unificada, em que alocação de GPUs, verificações de saúde e decisões de escala fiquem visíveis em uma única pilha, em vez de espalhadas por painéis de fornecedores.
Do lado da governança, defina quem pode reservar capacidade, como cotas são atribuídas e como o consumo é atribuído a centros de custo. Em ambientes compartilhados, isolamento entre equipes e trilhas de auditoria de acesso a dados e a modelos devem ser requisitos de projeto, com atenção às obrigações de proteção de dados aplicáveis à organização.
Segurança e desempenho em conjunto
Segmentação de rede e controle de acesso ao plano de gerenciamento não podem comprometer o desempenho da malha de dados. Separe a rede de front-end, usada para acesso e armazenamento, da rede de back-end de treinamento, como na arquitetura documentada pela Oracle, que distingue largura de banda de cluster (até 3.200 Gb/s) de largura de banda de front-end (até 400 Gb/s).
Revise ainda a dependência de fornecedor. A Dell’Oro destaca que restrições de cadeia de suprimentos impulsionam a diversificação, de modo que projetos com componentes intercambiáveis se adaptam melhor a atrasos de entrega.
Medição de sucesso: métricas que comprovam a escala
Indicadores técnicos
O primeiro indicador é o goodput, a fração do tempo em que o cluster realiza progresso útil. Ele captura o efeito combinado de falhas, checkpoints e reinícios, e por isso diz mais sobre eficiência do que a simples utilização de GPU, já que, segundo a Nebius, um cluster pode parecer ocupado enquanto os jobs reiniciam, esperam em fila ou se recuperam de falhas.
O segundo é o MTBF em horas de GPU. A Nebius o define como o número de GPUs multiplicado pelo tempo operacional e dividido pelo número de falhas de infraestrutura. Em seu exemplo, um cluster de 1.024 GPUs operando por 336 horas com 13 falhas resulta em MTBF de 26.446 horas de GPU. Acompanhar a tendência do MTBF revela degradação de hardware antes que ela afete prazos.
O terceiro é o MFU, que mostra quanto da capacidade teórica de cálculo é convertida em treinamento. Com a referência de 35% a 45% apontada pela Signal65 para treinamentos de grande escala, desvios para baixo sugerem gargalo de rede, de dados ou de balanceamento.
Indicadores de negócio e avaliação de eficácia
Do lado de negócio, acompanhe o tempo de espera na fila, o prazo de entrega de cada rodada de treinamento e o custo por experimento concluído. A estimativa do Google de que cada ponto percentual de goodput vale mais de um milhão de dólares em treinamentos grandes mostra por que esses números devem chegar à diretoria.
| Indicador | O que revela | Referência de 2025-2026 |
|---|---|---|
| Goodput | Tempo útil de treinamento | Cerca de 90% na média do setor (Signal65, via CoreWeave) |
| MFU | Aproveitamento do cálculo teórico | 35% a 45% em treinamentos de grande escala |
| MTBF | Confiabilidade por tamanho de cluster | Cerca de 8 h em 1.024 GPUs; cerca de 1,8 h em 16.384 GPUs (Meta) |
| Intervalo de checkpoint | Equilíbrio entre perda e overhead | 1 a 3 h para cerca de 1.000 GPUs com duas falhas por dia (CUDO) |
| Tempo de fila | Sinal para ampliar capacidade | Definir meta interna por classe de carga |
Revise esses indicadores a cada marco de expansão. Se o goodput cai quando o cluster dobra de tamanho, o problema está na arquitetura de recuperação ou de rede, não na falta de GPUs.
Conclusão e próximos passos
A escalabilidade de cluster em 2026 depende de tratar rede, confiabilidade e operação como parte do dimensionamento. Os dados mostram que a confiabilidade cai de forma proporcional ao tamanho do cluster e que o goodput, mais do que a contagem de GPUs, determina o custo real de cada treinamento. A rede, que responde por uma fração modesta do investimento, é a principal alavanca para proteger o retorno sobre as GPUs.
No mercado de redes, a Ethernet lidera as vendas em clusters de IA, enquanto o InfiniBand mostra rebote com a geração Blackwell Ultra. Para a maioria das organizações, a decisão deve se apoiar em escala-alvo, diversidade de fornecedores e capacidade da equipe, não em uma preferência fixa por protocolo.
Olhando adiante, a Dell’Oro projeta que switches de 1,6 Tbps entrem em rampa no segundo semestre de 2026 e que a óptica co-empacotada (CPO) inicie sua rampa em volume em 2026, ambos ainda em fase de ramp-up. Alternativas de scale-up em Ethernet também estão no roadmap. Acompanhe esses marcos antes de fechar contratos de longo prazo.
Para começar, recomendamos quatro passos práticos: defina o tamanho-alvo do cluster para os próximos 24 a 36 meses; meça o goodput e o MTBF atuais antes de qualquer expansão; recalcule o intervalo de checkpoint pelo modelo de Young e Daly; e escolha a malha de rede com base nesse tamanho-alvo e na disponibilidade de fornecedores.