Container Kubernetes: Guia Estratégico para Empresas 2026
Em 2026, falar de container Kubernetes deixou de ser falar de uma tecnologia emergente. A pesquisa anual da CNCF, divulgada em janeiro de 2026, mostra que 82% dos usuários de containers já executam Kubernetes em produção, contra 66% em 2023. A plataforma tornou-se a infraestrutura-base de aplicações corporativas e, cada vez mais, de cargas de inteligência artificial.
Esse sucesso trouxe um novo conjunto de desafios. A mesma pesquisa da CNCF aponta que, pela primeira vez, o principal obstáculo à adoção cloud native não é técnico, e sim organizacional. Equipes de plataforma precisam lidar com ciclos de lançamento rápidos, componentes que saem de suporte, custos de nuvem crescentes e a pressão para hospedar GPUs e modelos de IA no mesmo ambiente.
O custo de operar mal é concreto. Dados da Cast AI, baseados em cerca de 23.000 clusters, indicam que a utilização média de CPU caiu para 8% em 2025, e a de GPU é de apenas 5%. Ao mesmo tempo, componentes críticos como o Ingress NGINX foram aposentados, e versões antigas do Kubernetes migram para suporte estendido ou deixam de receber correções.
Este guia analisa o tema em seis dimensões: o problema estratégico, as consequências da inação, os fundamentos técnicos, a implementação, as práticas avançadas e a medição de sucesso. O objetivo é apoiar decisões de arquitetura e governança com dados de 2025 e 2026.
1. O problema estratégico: Kubernetes como plataforma, não como projeto
O desafio empresarial contextualizado
Muitas organizações ainda tratam o Kubernetes como um projeto de infraestrutura com início, meio e fim. Na prática, ele funciona como uma plataforma de produto interno, com roadmap, usuários, SLAs e ciclo de vida próprios. Quando essa mudança de mentalidade não acontece, o cluster vira um repositório de exceções: cada equipe configura do seu jeito e ninguém responde pelo todo.
O dado da CNCF sobre o fator organizacional reforça esse ponto. Se o gargalo não é a tecnologia, ele está em papéis mal definidos, falta de padronização e ausência de um modelo claro de responsabilidade entre desenvolvimento, operações e segurança. Um exemplo comum é o time de aplicação que define requests de CPU sem critério, enquanto o time de plataforma paga a conta sem visibilidade sobre a origem do consumo.
Além disso, a plataforma precisa atender perfis muito diferentes de carga. Serviços web stateless, bancos de dados, pipelines de dados e treinamento ou inferência de modelos têm requisitos distintos de rede, armazenamento e agendamento. Um desenho único, sem camadas de abstração, tende a atender mal todos eles.
Implicações técnicas e de negócio
Do ponto de vista técnico, o Kubernetes consolidou-se como camada de orquestração para IA. Segundo a CNCF, 66% das organizações que hospedam modelos de IA generativa usam Kubernetes para gerenciar parte ou toda a inferência. Isso eleva a criticidade do cluster: uma falha de agendamento de GPU deixa de ser um incômodo de desenvolvimento e passa a afetar receita.
Do ponto de vista de negócio, a decisão deixa de ser “adotar ou não” e passa a ser “como operar com previsibilidade”. Isso envolve escolher entre serviços gerenciados e operação própria, definir a cadência de atualização e decidir quanto da complexidade será escondida atrás de uma plataforma interna para os desenvolvedores.
Análise de cenários críticos
Três cenários merecem atenção especial. O primeiro é o de múltiplos clusters sem governança, comum após fusões ou crescimento acelerado, em que versões e políticas divergem. O segundo é o de cargas de IA improvisadas, com GPUs alocadas de forma estática e sem compartilhamento. O terceiro é o de dependências que desaparecem, como o Ingress NGINX, cuja retirada exigiu planejamento de migração em larga escala.
2. Consequências da inação: o custo de não gerenciar o ciclo de vida
Riscos específicos
O risco mais imediato é operar versões sem suporte. As notas de versão do Azure Kubernetes Service de julho de 2026 mostram, por exemplo, a versão 1.30 como descontinuada e a 1.33 disponível apenas sob suporte de longo prazo (LTS). Quem não acompanha o calendário acaba pagando por suporte estendido ou convivendo com vulnerabilidades sem correção.
Há também o risco de ruptura por componentes removidos. O Kubernetes 1.35 foi a última versão a suportar containerd 1.x, e o campo externalIPs dos Services foi marcado como obsoleto no 1.36, com remoção prevista para a versão 1.43. Ignorar esses avisos transforma upgrades rotineiros em projetos emergenciais.
Um terceiro risco é o de segurança por omissão. Recursos como user namespaces, que isolam o usuário root do contêiner do root do host, só protegem quem os habilita e testa. Sem uma política deliberada de adoção, o cluster permanece com o conjunto de defaults mais antigo.
Custos de oportunidade
O relatório 2026 da Cast AI traz números expressivos: a sobrecarga de CPU (overprovisioning) atinge 69% dos clusters, contra 40% no ano anterior, e a de memória chega a 79%. A utilização média de memória é de 20%. Trata-se de uma fonte de fornecedor, portanto convém tratar os valores como indicativos de tendência, mas o diagnóstico é consistente com a experiência de mercado.
No caso de GPUs, o impacto financeiro é ainda maior. Uma CPU ociosa custa centavos por hora; uma GPU ociosa custa dólares. Com utilização média de 5%, a Cast AI estima que as organizações aloquem cerca de 20 vezes mais capacidade de GPU do que realmente usam. Cada ponto percentual recuperado tem valor direto no orçamento.
Desvantagens competitivas
Equipes que dedicam a maior parte do tempo a apagar incêndios de versão, rede e capacidade entregam menos funcionalidades. Já as que automatizam o ciclo de vida e a alocação de recursos liberam engenheiros para trabalho de maior valor. Em um mercado em que a inferência de IA é diferencial competitivo, a eficiência da plataforma torna-se vantagem estratégica.
3. Fundamentos da solução: a arquitetura do container Kubernetes em 2026
Base técnica aprofundada
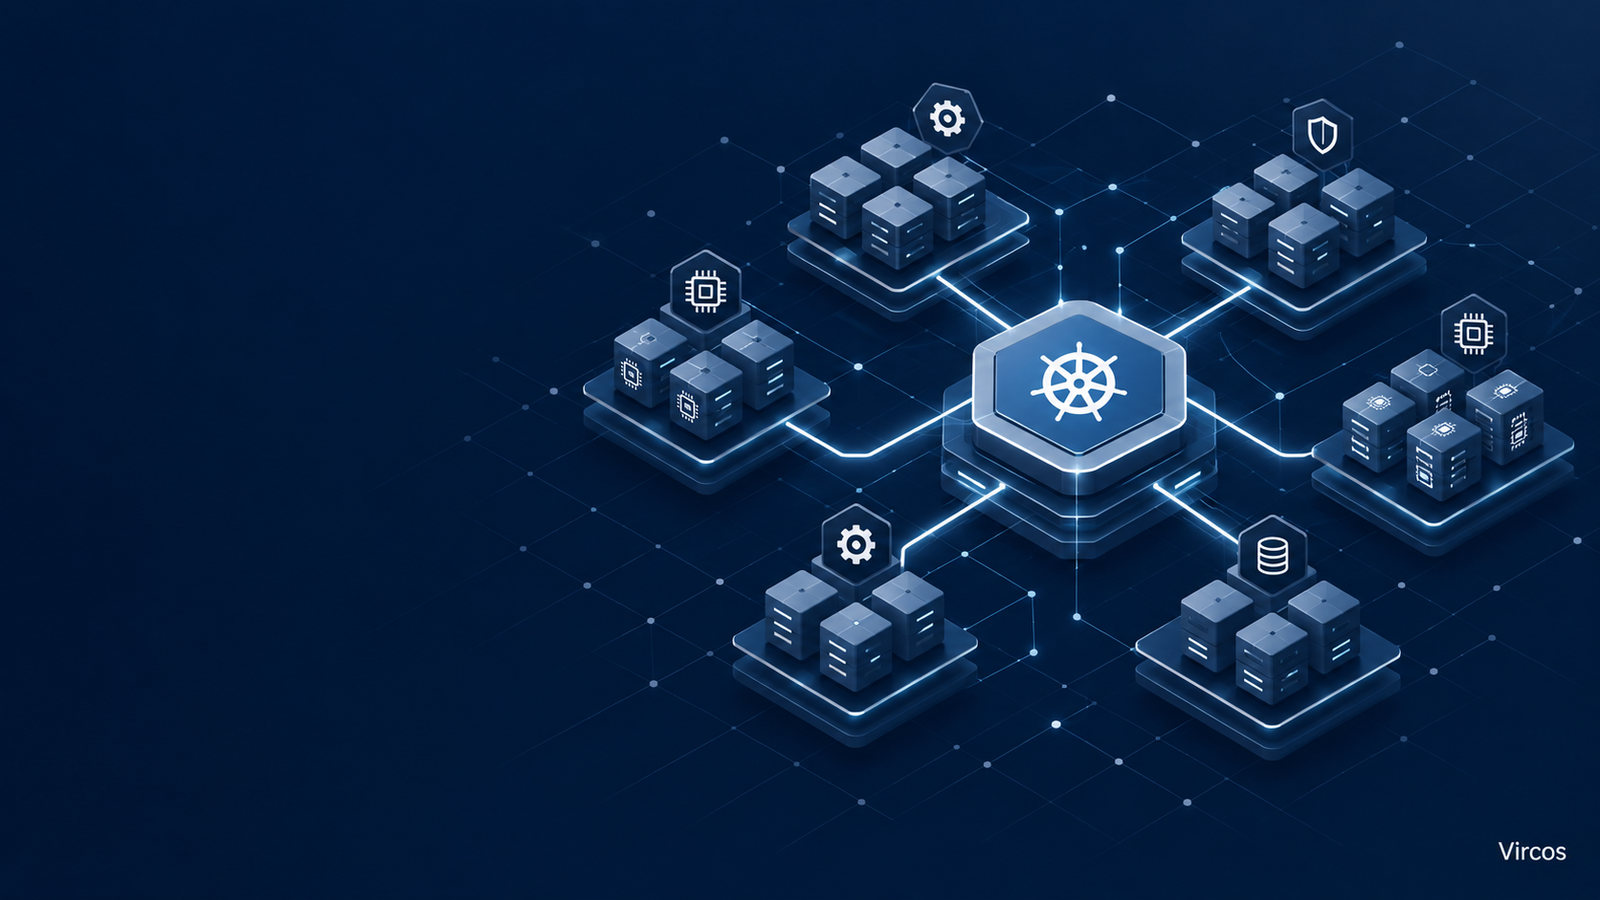
O Kubernetes organiza contêineres em pods, agendados em nós por um scheduler e mantidos em estado desejado por controladores. O plano de controle (API server, etcd, scheduler e controllers) decide; o kubelet em cada nó executa, usando um runtime compatível com a interface CRI, normalmente o containerd. A arquitetura é declarativa: você descreve o resultado e a plataforma reconcilia.
Três interfaces garantem a extensibilidade: CRI para runtimes, CNI para rede e CSI para armazenamento. Isso permite trocar componentes sem alterar a aplicação. Em armazenamento, por exemplo, o VolumeAttributesClass tornou-se estável na versão 1.34 e o VolumeGroupSnapshot, na 1.36, ampliando o controle sobre desempenho e consistência de volumes.
Para cargas de IA, o avanço mais relevante é o Dynamic Resource Allocation (DRA). As APIs centrais do DRA tornaram-se estáveis na versão 1.34, e a 1.36 trouxe novas funções como acesso administrativo e listas priorizadas, além de recursos em beta para particionamento de dispositivos e capacidade consumível. Na versão 1.37, o campo .status.devices de ResourceClaim chegou à versão estável, permitindo que drivers informem o estado de cada dispositivo.
Princípios arquitetônicos
Três princípios orientam um desenho saudável: separação entre plano de controle e carga de trabalho, isolamento por namespaces e políticas, e tratamento de infraestrutura como código. O Kubernetes 1.35 reforçou o último ao estabilizar os volumes de imagem OCI, que permitem montar artefatos (como pesos de modelos) a partir de um registro, sem embuti-los na imagem do contêiner.
No tráfego de entrada, o princípio é migrar do modelo Ingress, limitado e dependente de anotações, para o Gateway API, orientado a papéis e com recursos como divisão de tráfego previstos na especificação. O Google Open Source Blog descreve o Gateway API como uma espécie de “Ingress 2.0”, e a SIG Network recomenda a migração para quem usava o Ingress NGINX.
Interoperabilidade com sistemas existentes
O Kubernetes raramente opera isolado. Ele precisa integrar-se a identidade corporativa, a registries, a pipelines de CI/CD, a observabilidade e a sistemas legados. A estabilização da API externa de assinatura de tokens de ServiceAccount, na versão 1.36, ilustra esse movimento: tokens padrão podem ser emitidos por sistemas externos de gestão de chaves, mantendo a integração limpa com a API.
4. Implementação estratégica: decisões que definem os próximos três anos
Abordagem metodológica
A primeira decisão é entre serviço gerenciado e operação própria. Serviços como EKS, AKS e GKE assumem o plano de controle e acompanham as versões upstream de perto, o que reduz o esforço de operação. A operação própria faz sentido quando há requisitos de soberania, latência ou integração com hardware específico, mas exige equipe dedicada e disciplina de atualização.
A segunda decisão é o ciclo de upgrade. O projeto lança versões várias vezes ao ano: a 1.36 saiu em 22 de abril de 2026, a 1.37 em 26 de agosto de 2026 e a 1.38 é esperada para dezembro de 2026. Uma política prática é manter produção a no máximo uma ou duas versões menores atrás da mais recente, testando antes em ambientes de homologação.
A terceira decisão é a topologia: poucos clusters grandes ou muitos clusters menores. Mais clusters aumentam o isolamento e reduzem o raio de impacto de falhas, mas multiplicam a gestão. A resposta depende do perfil de risco, e a gestão de frota (fleet management) deve ser planejada desde o início.
Considerações críticas
Dimensionamento merece atenção. O Kubernetes 1.35 tornou estável o redimensionamento de pods in-place, que permite ajustar CPU e memória sem reiniciar o contêiner, e a versão 1.36 levou o redimensionamento vertical de recursos em nível de pod ao beta. Isso viabiliza rightsizing contínuo com menos interrupções, mas exige observabilidade confiável para decidir os valores.
Também é preciso tratar o estado. Cargas stateful dependem de classes de armazenamento adequadas, snapshots consistentes (agora com VolumeGroupSnapshot estável) e planos de recuperação testados. Backup sem teste de restauração é apenas uma hipótese.
Pontos de falha potenciais
Entre os pontos de falha mais comuns estão: dependência do Ingress NGINX sem plano de saída; nós ainda em cgroup v1, cujo uso está obsoleto (desde a 1.35, o kubelet falha por padrão nesse cenário, com possibilidade de override); e o volume gitRepo, desativado permanentemente na versão 1.36. Um inventário prévio dessas dependências, antes de cada upgrade, evita surpresas.
5. Melhores práticas avançadas
Otimizações baseadas em experiência prática
A prática de maior retorno é o rightsizing baseado em telemetria. Requests definidos por intuição tendem a ser inflados “por segurança”, e o autoscaler de cluster escala com base em requests, não no consumo real. Resultado: nós adicionais para capacidade que ninguém usa. Revisar requests periodicamente, com dados de utilização, é o primeiro passo.
Para GPUs, o caminho é compartilhar e agendar com inteligência. O DRA e seus recursos de particionamento permitem fracionar aceleradores entre cargas, em vez de reservar uma placa inteira por pod. O próprio relatório da Cast AI cita um cluster de 136 GPUs H200 sustentando 49% de utilização, evidência de que o teto não é teórico.
Na camada de rede, vale priorizar o Gateway API em novos projetos e planejar a migração gradual dos Ingress existentes. Muitas organizações combinam as duas etapas: primeiro trocam o controlador, depois adotam o Gateway API com calma.
Requisitos de governança e compliance
Governança em Kubernetes significa políticas aplicadas de forma automática e auditável. O MutatingAdmissionPolicy tornou-se estável na versão 1.36, permitindo declarar mutações de admissão em CEL, sem webhooks externos, o que simplifica a operação e reduz pontos de falha. A versão 1.37 avança com o controle de admissão baseado em manifestos.
Padrões de rotulagem, limites de recursos por namespace, políticas de imagem aprovada e trilhas de auditoria devem constar de um catálogo versionado em repositório, com revisão por pares. Em setores regulados, essa rastreabilidade é pré-requisito, e não diferencial.
Considerações de segurança
Duas evoluções de 2026 merecem destaque. Os user namespaces chegaram à versão estável na 1.36, reduzindo o impacto de uma fuga de contêiner ao mapear o root interno para um usuário sem privilégios no host. E o kubelet em modo rootless avança para beta na 1.37, estendendo o princípio de menor privilégio ao próprio nó.
Soma-se a isso a rotação e a emissão de certificados para pods, que chegou à versão estável na 1.37. Um ponto de atenção: o AppArmor foi marcado como obsoleto na 1.34, então políticas baseadas nele merecem revisão. A segurança deve ser tratada em camadas, da imagem ao runtime, sem depender de um único controle.
6. Medição de sucesso: o que acompanhar
Métricas e indicadores
A medição começa pela utilização real versus a solicitada. Acompanhe, por namespace e carga, a relação entre requests e consumo de CPU, memória e GPU. Os benchmarks de mercado (8% de CPU, 20% de memória, 5% de GPU na média) servem como ponto de partida para saber se a sua plataforma está acima ou abaixo do padrão.
Outro indicador é a defasagem de versão: quantas versões menores o ambiente de produção está atrás da última estável. Esse número resume a saúde do ciclo de vida e antecipa riscos de suporte. Com a Metrics API estável na 1.37, após quase nove anos em beta, a coleta de métricas de recursos ganha uma base mais previsível.
KPIs técnicos e de negócio
Do lado técnico, monitore tempo de implantação, taxa de falhas de mudança, tempo médio de recuperação (MTTR) e disponibilidade por serviço. Do lado financeiro, acompanhe custo por carga de trabalho, custo por ambiente e custo por unidade de negócio (por exemplo, por transação ou por inferência).
Para IA, adicione a utilização de GPU, o tempo de fila de jobs e o custo por mil inferências. Esses indicadores conectam a decisão de infraestrutura ao resultado de negócio, e permitem justificar investimentos em otimização.
Avaliação de eficácia
Revise os indicadores em ciclos trimestrais, alinhados ao calendário de releases. Compare o antes e o depois de cada iniciativa (rightsizing, migração para Gateway API, adoção de DRA) e registre o ganho obtido. Isso cria memória institucional e evita que boas práticas se percam com a rotatividade da equipe.
Comparativo: evolução recente do Kubernetes
| Versão | Destaques relevantes | Impacto para a empresa |
|---|---|---|
| 1.34 | APIs centrais do DRA estáveis; VolumeAttributesClass estável; AppArmor obsoleto | Base para agendamento de GPUs; revisão de políticas AppArmor |
| 1.35 | Redimensionamento in-place estável; volumes de imagem OCI estáveis; última versão com containerd 1.x | Rightsizing sem reinício; migrar runtimes antigos |
| 1.36 (abr/2026) | User namespaces e MutatingAdmissionPolicy estáveis; VolumeGroupSnapshot estável; externalIPs obsoleto | Mais isolamento e governança nativa; revisar Services |
| 1.37 (ago/2026) | Metrics API estável; kubelet rootless em beta; certificados de pod estáveis; agendamento por workload em alfa | Segurança de nó e telemetria mais previsíveis |
Conclusão
O container Kubernetes consolidou-se como plataforma central da infraestrutura corporativa, com 82% de uso em produção entre os usuários de containers e papel crescente na inferência de IA. O desafio de 2026 não é adotar a tecnologia, mas operá-la com disciplina: ciclo de vida previsível, custos sob controle, segurança em camadas e governança automatizada.
Os dados de utilização mostram onde estão as maiores oportunidades. Com CPU a 8% e GPU a 5% em média, o espaço para ganho de eficiência é grande, e as funcionalidades recentes (redimensionamento in-place, DRA, MutatingAdmissionPolicy) fornecem as ferramentas para capturá-lo. Já a retirada do Ingress NGINX e a obsolescência de componentes antigos reforçam a necessidade de inventário e planejamento.
Olhando adiante, a versão 1.38 é esperada para dezembro de 2026, e o agendamento orientado a workloads, hoje em alfa, tende a ganhar relevância para cargas de IA. Convém acompanhar o roadmap oficial, lembrando que itens em alfa ou beta podem mudar antes de se tornarem estáveis.