Análise Preditiva: Guia Estratégico para Empresas em 2026
Em 2026, a pergunta que diretores de TI e de operações fazem sobre análise preditiva mudou. Já não se discute se a técnica funciona, e sim por que tantos projetos não saem do piloto. O investimento cresce, mas a distância entre construir um modelo e tomar decisões melhores com ele continua grande.
Os números de mercado mostram o apetite. Relatórios de 2025 e 2026 estimam o mercado global de analytics preditivo entre cerca de US$ 17 bilhões e US$ 23 bilhões em 2025, com crescimento anual projetado de 18% a 34%, conforme a metodologia de cada consultoria. A divergência é grande, mas a direção é unânime: expansão de dois dígitos por vários anos.
O custo de errar na implementação também é concreto. A Gartner prevê que, ao longo de 2026, 60% dos projetos de IA sem dados preparados para IA serão abandonados. No Panorama 2026, da Amcham Brasil com a Humanizadas, 61% dos 629 executivos de médias e grandes empresas ouvidos disseram não ter percebido impacto relevante da inteligência artificial em seus negócios.
Este guia analisa o tema com olhar consultivo: o problema estratégico, o preço de adiar, os fundamentos técnicos, a implementação, as boas práticas de governança e a medição de resultado. O objetivo é separar o que gera valor do que apenas consome orçamento.
O problema estratégico: decisões reativas em um ambiente de dados abundantes
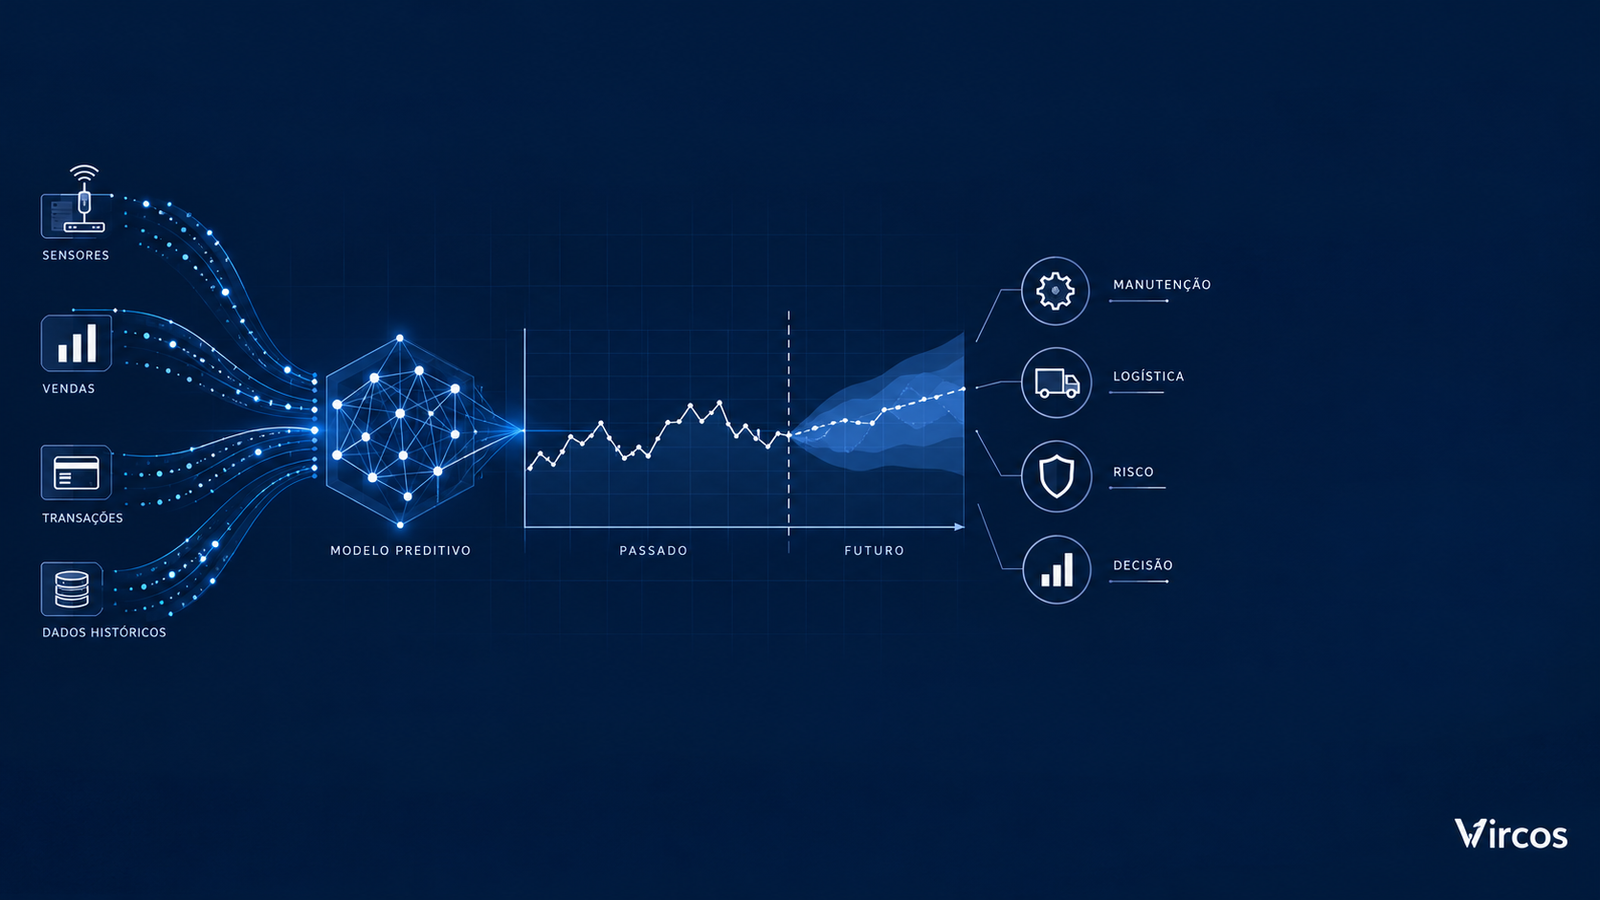
A maioria das organizações já coleta dados de sobra. O que falta é antecipação. A modelagem preditiva usa histórico, estatística e machine learning para estimar a probabilidade de eventos futuros, como falha de equipamento, cancelamento de cliente, inadimplência ou ruptura de estoque.
O valor está na antecedência. Uma decisão tomada antes do evento custa menos do que a resposta a um evento já consumado. Por isso, o ganho da análise preditiva se mede em decisões que mudaram, e não em modelos que existem.
Implicações técnicas
O principal obstáculo costuma ser o dado, e não o algoritmo. A Gartner apontou em 2025 que 63% das organizações não têm, ou não sabem se têm, práticas de gestão de dados adequadas para IA. Silos entre sistemas, definições inconsistentes e histórico sem rótulos confiáveis degradam qualquer modelo, por mais sofisticado que seja.
Implicações de negócio e cenários críticos
Previsão sem ação é apenas um relatório. Um modelo de churn pode acertar e ainda assim não gerar retenção, se a área comercial não tem processo para agir sobre a lista. Um alerta de falha pode ser correto e inútil, se não vira ordem de serviço no sistema de manutenção.
Os cenários mais críticos estão em setores regulados e de alto impacto. Só o mercado de analytics preditivo em saúde foi estimado em US$ 20,57 bilhões em 2025 pela SNS Insider (julho de 2026). Em crédito, saúde e seguros, um erro de previsão tem consequência financeira, jurídica e reputacional.
Consequências da inação: o custo de decidir tarde
O exemplo mais mensurável vem da manutenção industrial. O estudo True Cost of Downtime 2024, da Siemens com a Senseye, estima que as 500 maiores empresas do mundo perdem cerca de US$ 1,4 trilhão por ano com paradas não planejadas, algo próximo de 11% da receita. Uma linha parada em uma fábrica automotiva pode custar até US$ 2,3 milhões por hora.
São números de gigantes, mas a lógica escala para qualquer operação. Parada imprevista custa mais do que parada planejada, porque combina produção perdida, reparo emergencial e atraso de entrega. Um levantamento divulgado por um fornecedor de software de manutenção indica que 71% dos profissionais da área ainda dependem principalmente de manutenção preventiva por calendário em 2026. Vale ler o dado com cautela, por vir de fonte comercial, mas ele sugere que a maturidade preditiva ainda é minoria.
Custos de oportunidade
Na previsão de demanda, o custo de não prever bem aparece como estoque parado ou venda perdida. Estimativas atribuídas à McKinsey indicam que previsões baseadas em IA reduzem erros de 20% a 50% e, nos melhores casos, cortam em até 65% as vendas perdidas por indisponibilidade. São resultados de melhores implementações, e não médias de mercado.
Em risco e fraude, o custo da inação é a perda direta. Segundo a Straits Research, risk & fraud management foi o maior segmento do mercado em 2025, com 17,8% de participação. Esse peso indica onde as empresas já aprenderam que antecipar é mais barato do que remediar.
Desvantagem competitiva
A barreira de entrada está caindo. Segundo a Next Move Strategy Consulting, o AutoML é o subsegmento de software de crescimento mais rápido, com 22,6% ao ano até 2035, e as pequenas empresas são o porte que mais cresce, com 19% ao ano. Concorrentes menores passam a acessar capacidades que antes exigiam grandes times de ciência de dados, e por isso adiar deixa de ser uma posição neutra.
Fundamentos da solução: da pergunta de negócio à arquitetura
A base técnica é uma família de métodos, e a escolha depende da pergunta. Classificação serve para fraude, inadimplência e churn. Regressão e séries temporais servem para demanda, preço e consumo de energia. Análise de sobrevivência (tempo até a falha) serve para manutenção de ativos. Escolher o método errado para a pergunta é um dos erros mais comuns e mais caros.
Em termos de arquitetura, um sistema preditivo maduro tem etapas bem separadas: ingestão com validação de qualidade, engenharia de atributos, treinamento e validação, registro de modelos, serviço de previsões (em lote ou em tempo real) e monitoramento. Uma feature store garante que o atributo seja calculado da mesma forma no treino e na produção. A pesquisa MLOps da Datatalks.club (2024-2025) mostrou que 75% dos respondentes ainda não usavam esse recurso.
A interoperabilidade decide se o modelo será usado. A previsão precisa chegar ao ERP, ao sistema de manutenção, ao CRM ou ao data warehouse, no ponto em que a decisão acontece: pedido de compra, ordem de serviço, régua de cobrança. O modelo pode rodar em nuvem, on-premises ou em arranjo híbrido, categorias usadas pela Technavio na segmentação do mercado, conforme latência, custo e exigências de soberania de dados.
Há ainda trade-offs inevitáveis. Modelos mais complexos podem ganhar em acurácia e perder em interpretabilidade, o que pesa em decisões que precisam ser explicadas a clientes e auditores. Previsão em tempo real custa mais infraestrutura do que previsão em lote. A pergunta certa é qual precisão e qual latência a decisão realmente exige.
Implementação estratégica: comece pela decisão, não pelo algoritmo
A abordagem metodológica mais segura começa por definir qual decisão vai mudar, quem a toma, em que prazo e com que custo de erro. Só depois se escolhe o modelo. Em paralelo, estabelece-se um baseline, que pode ser a regra atual ou a média histórica, porque um modelo só se justifica se superar a alternativa simples.
O piloto deve ser estreito: um conjunto de ativos, uma linha de produtos ou um segmento de clientes. Ele precisa nascer integrado ao fluxo de trabalho, com uma pessoa responsável por agir sobre as previsões. A Straits Research estima que os serviços de implementação, consultoria e integração crescem a 25,2% ao ano, sinal de que a integração, e não o algoritmo, é onde muitos projetos travam.
Pontos de falha potenciais
Os pontos de falha repetem-se. Eventos raros, como falhas de equipamento, geram poucos exemplos para treinar. Rótulos ruins contaminam o aprendizado. E falta dono para o modelo depois de implantado. Na pesquisa da Datatalks.club, 38% dos respondentes não implantavam modelos em produção e 81% não tinham uma equipe dedicada de MLOps.
A governança do projeto também importa. A Gartner estima que mais de 40% dos projetos de IA agêntica serão cancelados até o fim de 2027 quando faltam governança, observabilidade e clareza de retorno. A lição vale para a análise preditiva: sem critério de sucesso definido no início, o projeto vira custo recorrente sem prova de valor.
Melhores práticas avançadas: manter o modelo confiável depois do go-live
Modelos falham em silêncio. Diferentemente de um software que gera erro, um modelo degradado continua entregando previsões, só que cada vez piores. O monitoramento precisa acompanhar quatro sinais: drift de dados (a distribuição das entradas mudou), drift de previsões, desempenho real (quando os resultados chegam) e qualidade dos dados. Métricas como o PSI (Population Stability Index) são usadas para comparar o dado de produção com o de treinamento.
É importante distinguir os tipos de drift. No data drift, as entradas mudam. No concept drift, a relação entre entrada e resultado muda, como acontece com modelos de preço em períodos de inflação alta. Gatilhos de retreino baseados em evidência reduzem computação desnecessária e encurtam a janela de exposição a previsões ruins. Ainda assim, a pesquisa da Datatalks.club apontou que 58% dos respondentes não monitoravam seus modelos e 44% não retreinavam depois da implantação.
Governança e compliance no Brasil
A LGPD já se aplica a qualquer modelo que use dados pessoais, inclusive com o direito de solicitar revisão de decisões tomadas exclusivamente de forma automatizada. O PL 2.338/2023, o marco legal da IA, foi aprovado pelo Senado em 10 de dezembro de 2024 e segue em análise na Câmara. Em outubro de 2026, segundo acompanhamento de tramitação, o parecer do relator ainda não havia sido apresentado, então ainda não é lei.
O texto aprovado pelo Senado adota abordagem baseada em risco, prevê avaliações de impacto e multas de até R$ 50 milhões por infração, mas pode mudar na Câmara. A ANPD, por sua vez, incluiu IA e tecnologias emergentes entre os quatro eixos centrais de fiscalização do biênio 2026-2027. A recomendação prática é documentar fontes de dados, versões de modelos e critérios de decisão desde já.
Considerações de segurança
Minimize o uso de dados pessoais nos atributos, controle o acesso a dados de treino e a modelos, mantenha trilha de auditoria e proteja os pipelines contra dados adulterados. Cada modelo em produção deve ter um responsável nomeado, limites de drift definidos e um plano de rollback combinado antes do primeiro incidente.
Medição de sucesso: três camadas de indicadores
Medir análise preditiva exige três camadas. A camada de modelo usa métricas como MAE e RMSE (regressão), precisão, recall e AUC-ROC (classificação). A de operação acompanha latência, disponibilidade e drift. A de negócio traduz tudo em dinheiro, tempo ou risco evitado. Sem a terceira camada, o projeto não sustenta seu orçamento.
| Camada | Indicador | Referência publicada (2024-2026) |
|---|---|---|
| Negócio | Erro de previsão de demanda (MAPE) | Redução de 20% a 50% com IA, atribuída à McKinsey |
| Negócio | Vendas perdidas por indisponibilidade | Até 65% de redução em melhores casos, atribuída à McKinsey |
| Negócio | Parada não planejada | Faixas de 10% a 50%, conforme a fonte e a maturidade |
| Operação | Drift de dados e de previsões | Limites definidos por modelo (por exemplo, PSI) |
| Modelo | AUC-ROC, precisão, recall, MAE, RMSE | Dependem do problema e do baseline atual |
As referências de manutenção preditiva variam muito. Compilações de mercado e fornecedores citam de 30% a 50% de redução em paradas não planejadas e retorno entre 6 e 18 meses. Números mais conservadores atribuídos à Deloitte falam em 10% a 20% de aumento de disponibilidade e 5% a 10% de redução no custo de manutenção. Um estudo Forrester Total Economic Impact encomendado pela Augury reportou ROI de 310% e retorno em até seis meses, mas trata-se de um caso de fornecedor, e não de uma média.
A conclusão prática é tratar essas faixas como hipóteses e medir contra o seu próprio baseline. Isso exige registrar a situação antes do projeto, usar grupo de controle ou comparação champion/challenger e definir janelas de avaliação. Também é preciso evitar métricas enganosas: em fraude, onde só uma pequena fração das transações é fraudulenta, um modelo pode ter acurácia altíssima sem detectar quase nada.
Por fim, institua uma revisão periódica, por exemplo trimestral. Modelos sem impacto mensurável devem ser ajustados ou aposentados, e os resultados devem ser reportados em linguagem de negócio, não só de ciência de dados.
Conclusão: do piloto à decisão antecipada
A análise preditiva já é uma capacidade madura, mas seu retorno depende de disciplina. Os pontos centrais deste guia são: partir de uma decisão concreta, preparar os dados antes do modelo, integrar a previsão ao fluxo de trabalho, monitorar drift continuamente e medir resultado em termos de negócio.
Na implementação, a atenção deve ir menos para a escolha do algoritmo e mais para propriedade, qualidade de dados, integração e governança. É onde as pesquisas apontam as maiores perdas, e onde a LGPD e o debate sobre o marco legal da IA no Brasil já exigem rigor documental.
Para os próximos anos, o mercado deve seguir em expansão, com mais AutoML, maior participação de serviços gerenciados e pressão regulatória crescente. As estimativas de crescimento variam bastante entre consultorias, então vale planejar com cenários, e não com um único número.
O primeiro passo prático é simples e independe de tecnologia: escolher uma decisão recorrente e cara, medir como ela é tomada hoje, auditar os dados que a sustentam e nomear um responsável pelo resultado. A partir daí, o piloto deixa de ser um experimento isolado e passa a ser uma operação com meta.