Sistemas de Recomendação: Guia Estratégico para Empresas 2026
Em 2026, os sistemas de recomendação deixaram de ser um recurso de vitrine de e-commerce e passaram a ser infraestrutura de decisão. Eles ordenam o que clientes veem, compram, assistem e contratam, em varejo, mídia, serviços financeiros e plataformas B2B.
O desafio das organizações é duplo. A arquitetura clássica, baseada em grandes tabelas de embeddings e cascatas de ranking, mostra sinais de saturação. Os recomendadores generativos, baseados em transformers, prometem ganhos maiores, mas exigem GPUs, memória e engenharia de serviço de outra ordem de grandeza.
Há ainda o custo da inação e da implementação inadequada. Quem adia perde relevância diante de concorrentes que já operam modelos em escala. Quem implementa sem governança herda risco regulatório, já que a ANPD colocou sistemas de recomendação no radar de fiscalização para 2026-2027.
Neste guia, você verá o problema estratégico, o preço de não agir, os fundamentos técnicos, uma abordagem de implementação, práticas avançadas e as métricas que comprovam resultado.
O problema estratégico: relevância em escala com orçamento finito
Por que a arquitetura tradicional encontrou um teto
Durante anos, recomendar significou combinar tabelas de embeddings massivas com modelos de ranking. Segundo o framework de pesquisa MiniOneRec (arXiv, 2025), esses recomendadores tendem a estagnar conforme a dimensão dos embeddings cresce. Trabalhos anteriores também tiveram dificuldade em demonstrar as leis de escala observadas em modelos de linguagem.
Na prática, isso significa que dobrar o investimento em computação nem sempre dobra a qualidade da recomendação. Para o gestor, o retorno marginal do mesmo desenho arquitetônico diminui justamente quando o volume de usuários e de itens cresce.
O que mudou: o paradigma generativo em produção
A Meta publicou, em fevereiro de 2026, o ULTRA-HSTU, evolução do modelo HSTU. O trabalho descreve 18 camadas de autoatenção sobre sequências de 16 mil comportamentos de usuário, treinadas com centenas de GPUs H100 e servindo bilhões de usuários. Segundo os autores, houve ganho de mais de 5 vezes na eficiência de escala de treinamento e de mais de 21 vezes na de inferência, além de melhorias de 4% a 8% em consumo e engajamento em produção.
O movimento não é isolado. A Netflix Research (arXiv, maio de 2026) descreveu a escala de um recomendador generativo de 2 milhões a 1 bilhão de parâmetros de backbone em um cenário real de recomendação de títulos. Um artigo apresentado no KDD 2026 também explorou transformers de recomendação de até 1 bilhão de parâmetros.
Cenários críticos para a decisão
Três cenários concentram o risco. O primeiro é o cold start: catálogos com itens novos ou com pouca interação, onde recomendadores baseados em ID têm pouca evidência. O segundo é o orçamento de latência, pois uma recomendação poderosa, porém lenta, não gera valor. O terceiro é a escassez de dados em contextos B2B, onde há menos usuários e ciclos de decisão mais longos.
Consequências da inação: o custo de ficar para trás
Impacto direto em receita e eficiência
Estimativas amplamente citadas, atribuídas à McKinsey e reproduzidas por diversas publicações do setor em 2025 e 2026, apontam que personalização bem executada gera de 5% a 15% de aumento de receita e de 10% a 30% de melhoria no ROI de marketing. As mesmas fontes citam que empresas líderes em personalização obtêm cerca de 40% mais receita dessas atividades do que as médias.
Esses números devem ser lidos como referências, não como promessas. Eles variam por setor, maturidade de dados e qualidade da execução. O ponto estratégico é que a recomendação passou a ser um fator de competitividade mensurável.
A lacuna entre intenção e execução
O relatório State of Marketing 2025, da Salesforce, indica que 88% dos profissionais de marketing veem impacto mensurável da personalização, mas apenas 29% sentem que a entregam de forma eficaz. Essa distância é o espaço onde concorrentes mais preparados ganham mercado.
Vale cautela com números “virais”. A participação de cerca de 35% das vendas da Amazon atribuída à sua engine de recomendação é frequentemente repetida, mas, segundo análise da Envive, não há fonte primária da própria Amazon que confirme esse valor exato.
Desvantagem competitiva e de infraestrutura
Segundo a Mordor Intelligence (2026), o mercado de infraestrutura de GPU para empresas deve alcançar US$ 374,82 bilhões em 2026 e US$ 917,65 bilhões em 2031, com CAGR de 19,61%. A mesma análise destaca o aumento dos investimentos em capacidade de IA por parte de grandes provedores de nuvem.
Isso importa porque a capacidade computacional está sendo disputada. Organizações que adiam o planejamento de infraestrutura enfrentam fila, custo e menor poder de negociação quando decidirem avançar.
Fundamentos da solução: como um sistema de recomendação moderno funciona
Estágios do pipeline
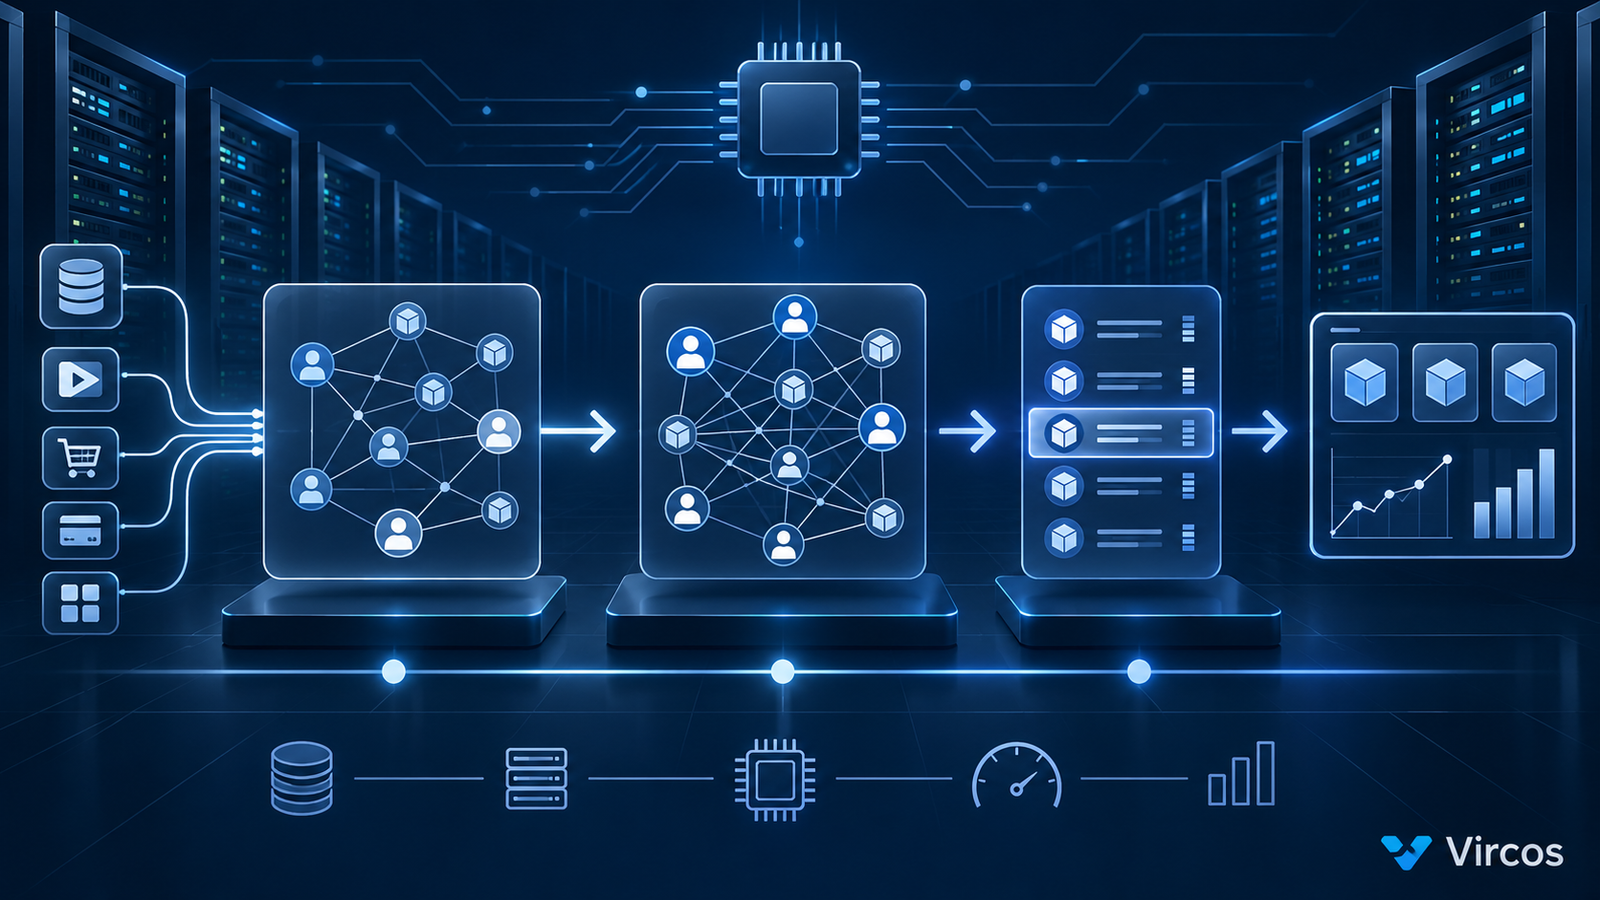
Um sistema de produção costuma dividir o problema em estágios. Primeiro, a geração de candidatos reduz um catálogo enorme a algumas centenas ou milhares de itens plausíveis. Depois, o ranking ordena esses itens com um modelo mais pesado, e uma etapa final de re-ranking aplica regras de negócio, diversidade e restrições.
Esse desenho existe por uma razão econômica: não é viável aplicar o modelo mais caro a todo o catálogo para cada requisição. A tendência de 2026 é que modelos generativos comecem a unificar etapas dessa cascata, conforme o MiniOneRec descreve para implantações industriais.
Embeddings e o gargalo de memória
Em modelos de recomendação profundos, as tabelas de embeddings representam a maior parte dos parâmetros e podem chegar à escala de terabytes, segundo o NVIDIA Developer Blog sobre o Merlin. A abordagem consolidada é o paralelismo híbrido: as tabelas são distribuídas entre GPUs (paralelismo de modelo), enquanto as camadas densas são replicadas (paralelismo de dados).
Para inferência, o Merlin Hierarchical Parameter Server usa um cache de embeddings em GPU apoiado por camadas de armazenamento mais lentas, como memória do host e SSD. Essa documentação é anterior a 2024 e deve ser lida como base técnica consolidada, não como novidade.
Recomendadores generativos e sequências longas
Em vez de depender apenas de features agregadas, modelos como o HSTU aprendem diretamente da sequência bruta de comportamento do usuário. Segundo o artigo da Meta de 2026, esse enfoque captura preferências de longo prazo e intenção de curto prazo no mesmo modelo e apresenta leis de escala favoráveis com o aumento de computação.
Para o cold start, a Netflix Research relata o uso de torres semânticas de itens, que pontuam títulos a partir de conteúdo e metadados quando a evidência baseada em ID é fraca.
Comparativo entre paradigmas
| Aspecto | Ranking tradicional (DLRM) | Recomendador generativo |
|---|---|---|
| Escala com computação | Tende a estagnar (MiniOneRec, 2025) | Leis de escala favoráveis (Meta e Netflix, 2026) |
| Gargalo principal | Tabelas de embeddings e lookup | Atenção sobre sequências longas e latência de inferência |
| Cold start | Dependente de ID, evidência fraca | Torres semânticas com conteúdo (Netflix, 2026) |
| Maturidade de ferramentas | Ampla, com frameworks open source | Em adoção por grandes plataformas |
Implementação estratégica: abordagem e pontos de falha
Abordagem metodológica
A recomendação prática é evoluir em etapas. Comece instrumentando o sistema atual e fixando uma linha de base de métricas. Em seguida, otimize geração de candidatos e ranking, e só então avalie modelos generativos em um caso de uso delimitado.
Segundo a Spheron (2026), a Shopify construiu seu recomendador de produção sobre o HSTU e relatou desempenho superior ao da pilha anterior em testes controlados. Trata-se de um relato de fonte única, que deve ser validado antes de ser usado como benchmark interno.
Separação de cargas de trabalho
Segundo a Axe Compute (2026), a infraestrutura de GPU corporativa se divide em três tipos de carga: treinamento, inferência e capacidade sob demanda. Treinamento pede nós dedicados com interconexão de alta largura de banda, como InfiniBand, enquanto inferir em infraestrutura otimizada para treino significa pagar por recursos que a carga não usa.
Para recomendação, isso se traduz em tratar o treino periódico dos modelos e o serviço em tempo real como problemas distintos, com dimensionamento, custo e SLAs próprios.
Pontos de falha potenciais
O primeiro ponto de falha é o cache de embeddings. A documentação do Merlin indica que lotes maiores reduzem a taxa de acerto e aumentam a latência, e que itens e usuários inéditos geram chaves ausentes. O segundo é o desalinhamento entre treino e serviço: a Netflix Research observa que, quando o sistema usa embeddings ou scores em cache, o próximo evento usado no treino pode não ser o alvo correto na hora de servir, o que motivou o uso de predição de múltiplos tokens.
O terceiro é o custo oculto de lookup. A Spheron (2026) aponta que a busca de embeddings no lado da CPU segue sendo o maior item de custo no serviço de modelos HSTU, o que explica a preferência por pipelines em dois estágios.
Melhores práticas avançadas: otimização, governança e segurança
Otimizações baseadas em experiência prática
Na camada de dados, o uso de hierarquia de armazenamento (GPU, CPU e SSD) com atualização contínua entre treino e inferência reduz latência sem exigir que todas as tabelas caibam em GPU. O Merlin descreve esse fluxo com mensageria baseada em Apache Kafka.
Na camada de modelo, a Netflix Research relata que amostragem de softmax e uma cabeça de decodificação projetada reduzem o custo de retreinamento repetido. São otimizações específicas, mas ilustram um princípio geral: o custo de iteração é tão estratégico quanto a acurácia final.
Governança e compliance sob a LGPD
O Art. 20 da LGPD garante ao titular o direito de solicitar revisão de decisões tomadas unicamente por tratamento automatizado que afetem seus interesses, incluindo as destinadas a definir perfil pessoal, profissional, de consumo e de crédito. Segundo a Confidata (2026), o perfilamento por si só não aciona o Art. 20: o gatilho é a decisão baseada no perfil que afeta o titular.
Isso cria uma distinção prática. Sugerir uma música é diferente de excluir alguém de uma oportunidade de crédito, emprego ou moradia. O Mapa de Temas Prioritários da ANPD para 2026-2027 (Resoluções CD/ANPD nº 30 e 31/2025) inclui IA como eixo e, segundo a Confidata, abrange especificamente sistemas de recomendação, em particular quando envolvem dados de crianças.
Em 2026, a ANPD tornou-se agência reguladora (Lei 15.352/2026) e o ECA Digital entrou em vigor em 17 de março de 2026. As sanções da LGPD podem chegar a 2% do faturamento, limitadas a R$ 50 milhões por infração. Recomenda-se manter um inventário de decisões automatizadas e elaborar relatório de impacto (RIPD) para sistemas com perfilamento relevante.
Considerações de segurança e soberania de dados
Sistemas de recomendação concentram dados comportamentais sensíveis. Em março de 2026, segundo a Mordor Intelligence, Palantir e NVIDIA anunciaram uma arquitetura de referência de IA soberana para operar cargas de trabalho sob total soberania de dados. O sinal para o mercado é claro: residência e controle de dados passaram a ser requisito de arquitetura, e não apenas de contrato.
Medição de sucesso: métricas e indicadores
KPIs técnicos
No plano técnico, acompanhe a latência em percentis altos (p95 e p99), a taxa de acerto do cache de embeddings, a vazão por GPU e o custo por mil recomendações servidas. Para qualidade offline, métricas de ranking como recall@k e NDCG continuam úteis, desde que validadas contra experimentos online.
A diferença entre desempenho offline e online é um risco recorrente. A experiência da Netflix com serviço em cache mostra que o objetivo de treino precisa refletir as condições reais de servimento.
KPIs de negócio
No plano de negócio, a referência é a receita atribuída a recomendações: taxa de cliques, conversão, ticket médio de sessões com cliques em recomendações e retenção. A Hello Retail (2026) sugere medir exatamente a receita atribuída e o aumento de AOV em sessões com engajamento.
O padrão mais confiável é o teste A/B com grupo de controle. No caso da Meta, os ganhos de 4% a 8% em consumo e engajamento foram medidos em produção, não apenas em benchmarks.
Avaliação de eficácia
Defina antes do projeto o que significa sucesso, com meta, janela de medição e custo aceitável por recomendação. Compare sempre o ganho incremental com o custo de infraestrutura, porque um modelo melhor que consome o benefício em GPU não é uma vitória.
Conclusão: perspectivas e próximos passos
Os sistemas de recomendação estão em transição. Os modelos tradicionais seguem dominantes e confiáveis, mas as evidências de 2026 de Meta, Netflix e da comunidade acadêmica apontam que a abordagem generativa abre uma nova curva de escala, ao custo de infraestrutura mais exigente.
Do ponto de vista de implementação, o caminho mais seguro é incremental: medir, otimizar o que existe, testar o generativo em um caso delimitado e escalar com governança. Um relatório da GPU Mart (2026) sugere ainda que a capacidade de VRAM tende a superar os TFLOPS brutos como critério de escolha de GPU para equipes de IA corporativa.
Olhando adiante, espere regulamentação mais detalhada sobre decisões automatizadas e maior pressão por transparência. Organizações que incorporarem compliance ao desenho do sistema chegarão a esse cenário com vantagem.