
Machine Learning em Produção: Guia Estratégico de MLOps
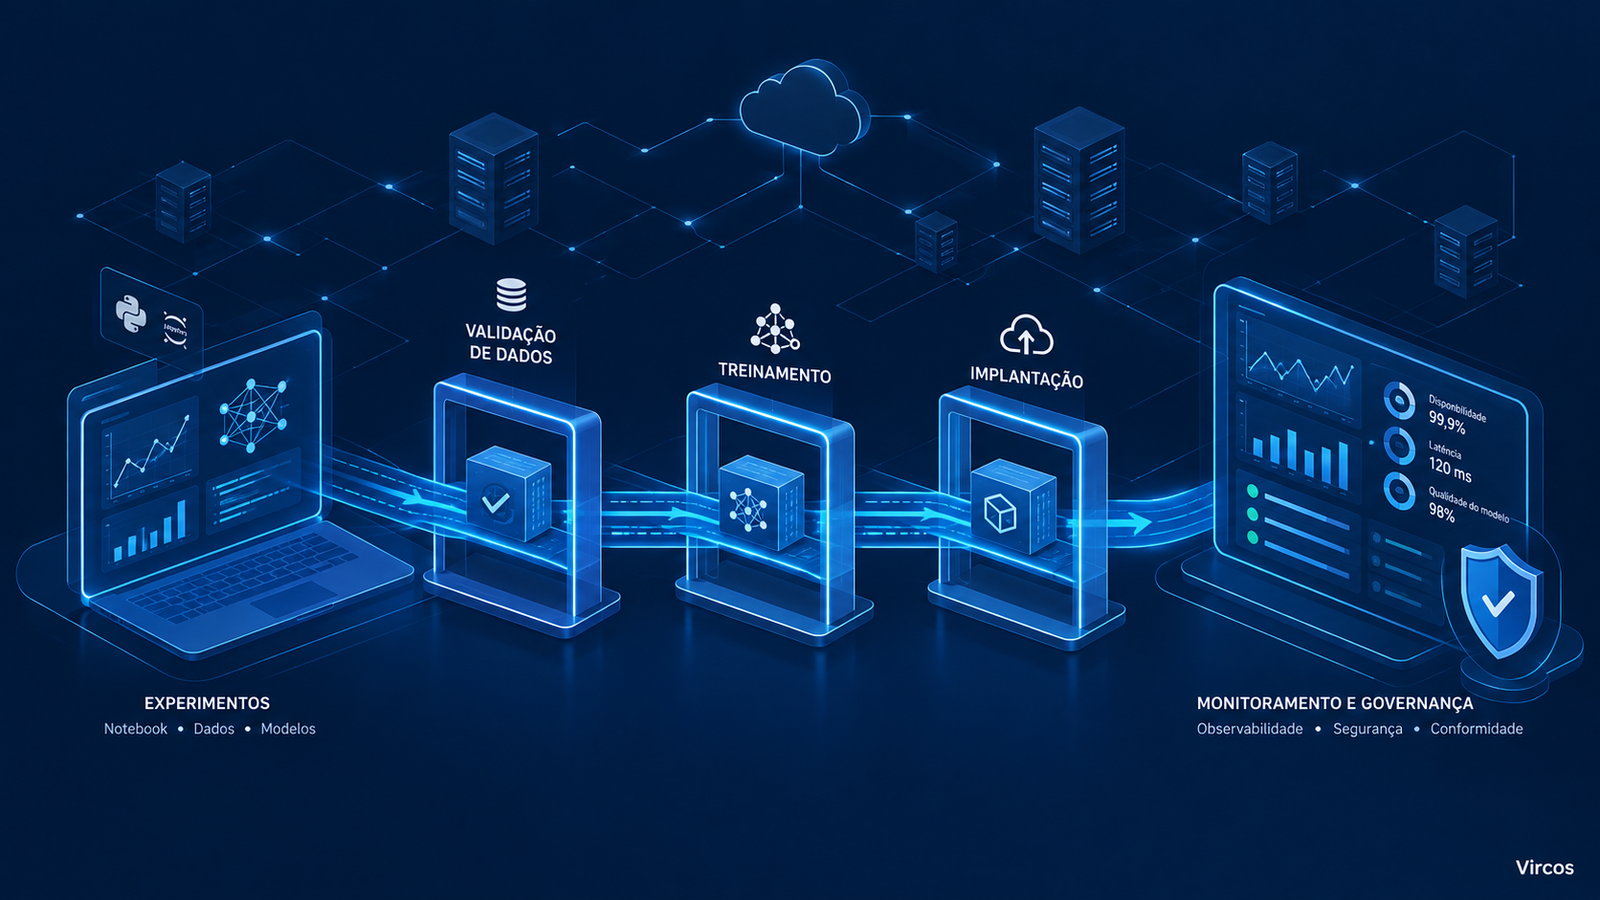
Em 2026, treinar um modelo que funciona em um notebook deixou de ser diferencial. A vantagem competitiva está em fazer machine learning em produção: manter o modelo disponível, monitorado, auditável e economicamente viável diante de dados que mudam todos os dias.
Os números mostram o tamanho da lacuna. No levantamento DataTalks.Club 2025-2026 sobre ML e MLOps, 17% dos respondentes não tinham nenhum modelo em produção e outros 17% tinham apenas um. Só 7% descreveram uma maturidade avançada, com CI/CD, retreinamento automatizado e responsabilidades claras.
O custo de errar nesse caminho é alto. A Gartner previu que ao menos 30% dos projetos de IA generativa seriam abandonados após a prova de conceito até o fim de 2025, por qualidade de dados, controles de risco inadequados, custos crescentes ou valor de negócio pouco claro. Em junho de 2025, estendeu o alerta a agentes de IA, com mais de 40% de cancelamentos projetados até o fim de 2027.
Este artigo analisa por que modelos travam antes da produção, quais são as consequências de não resolver o problema e quais fundamentos técnicos sustentam uma operação confiável. Também aborda a implementação, as práticas avançadas de governança e segurança e a forma de medir resultados com indicadores técnicos e de negócio.
1. O problema estratégico: o abismo entre piloto e produção
Por que o gargalo não é o algoritmo
O MLOps surgiu para resolver desafios sociotécnicos de levar modelos à produção. Entre eles estão integrar o modelo a software tradicional, monitorar continuamente, manter a solução e retreinar quando necessário. É o que descreve a revisão multivocal de Eken e colegas, que analisou 150 estudos revisados por pares e 48 fontes da chamada literatura cinzenta.
Um estudo de mapeamento sistemático de Chakraborty e colegas organiza as dificuldades em três frentes: o pipeline de manipulação de dados, o pipeline de construção do modelo e o pipeline de implantação. O ponto central é que falhas podem surgir em qualquer uma delas, e basta uma para impedir que a iniciativa chegue à produção.
Para o negócio, a implicação é direta. Investir só em cientistas de dados sem investir em engenharia de plataforma é financiar protótipos. O retorno só aparece quando o modelo entra em um processo real e permanece nele.
O que os profissionais reportam em 2025-2026
No levantamento DataTalks.Club 2025-2026, os maiores desafios apontados foram a complexidade de implantação (69%), a falta de habilidades ou expertise (54%) e o monitoramento e a observabilidade (46%). Em seguida vieram qualidade de dados e escala de pipelines (35% cada) e integração com sistemas existentes (31%).
A mesma pesquisa mostra que 68% das organizações não têm uma equipe de MLOps dedicada. Na prática, a responsabilidade pela operação fica diluída entre times de produto e de dados, sem dono claro para disponibilidade, qualidade e custo do modelo.
Um artigo da Addepto, de abril de 2026, agrupa os desafios em três categorias: ciência de dados (dados, modelos e features), execução de projetos (segurança, implantação e operação) e realidade da produção (drift, alucinações e regulação). A divisão ajuda a ver que muitos dos problemas mais caros só aparecem depois do lançamento.
O descompasso entre adoção e produção em IA generativa
A distância entre declarar adoção e operar de fato aparece com clareza em agentes de IA. Segundo uma análise da Digital Applied, de julho de 2026, que reúne dados de terceiros, cerca de 75% dos líderes disseram à Forrester (junho de 2026) que estão adotando IA agêntica. Já a pesquisa de CIOs da Gartner de 2026 indicou que 17% haviam implantado agentes, e a Deloitte encontrou apenas 11% com sistemas prontos para produção.
Esses números vêm de fontes secundárias e devem ser lidos como indicação de tendência. Ainda assim, apontam na mesma direção que o restante da pesquisa: o piloto é fácil, e a operação confiável é o que escala pouco.
2. Consequências da inação
Riscos específicos e custos de oportunidade
A previsão da Gartner de julho de 2024 listou quatro causas de abandono de projetos de IA generativa após a prova de conceito: qualidade de dados, controles de risco inadequados, custos crescentes e valor de negócio pouco claro. Nenhuma delas é um problema de algoritmo. Todas são problemas de operação, governança e mensuração.
Uma compilação do estudo de caso da Horwath HTL, que reúne dados da S&P Global/451 Research, indica que a parcela de empresas que abandonaram a maioria de suas iniciativas de IA saltou de 17% em 2024 para 42% em 2025. Na mesma fonte, a organização média descartou 46% de suas provas de conceito de IA generativa antes da produção.
O custo de oportunidade é composto. Cada iniciativa abandonada consome orçamento, tempo de equipe e credibilidade interna, o que torna a próxima proposta mais difícil de aprovar.
Desvantagem competitiva e risco regulatório
Empresas que operam modelos de forma confiável aprendem mais rápido. Elas coletam dados de produção, medem o efeito real das decisões automatizadas e refinam os modelos em ciclos curtos. Quem fica no piloto acumula hipóteses sem validação.
Há também o risco regulatório. O EU AI Act já está em vigor em partes, e organizações que operam sistemas de IA sem rastreabilidade, documentação e monitoramento terão dificuldade de demonstrar conformidade quando as obrigações de alto risco passarem a valer. Esse ponto é detalhado na seção 5.
A Gartner também alerta para o agent washing, em que fornecedores rotulam automação convencional como IA agêntica. Segundo a análise, de milhares de fornecedores com essa alegação, apenas cerca de 130 ofereceriam soluções genuínas. Comprar sem critério técnico de produção amplia o risco de entrar na estatística de cancelamentos.
3. Fundamentos da solução
Três pipelines e uma disciplina contínua
Uma operação madura de ML trata dados, treinamento e implantação como pipelines versionados e reproduzíveis. O pipeline de dados valida e transforma as entradas. O de treinamento registra experimentos, parâmetros e métricas. O de implantação promove modelos aprovados a um ambiente de serving com controle de versão e possibilidade de reversão.
O trabalho não termina no deploy. O artigo clássico de Sculley e colegas, de 2015, já apontava que sistemas de ML em produção geram custos de manutenção contínuos, descritos como dívida técnica. Esse é um contexto histórico, mas segue válido: quanto mais modelos em produção, maior o custo de mantê-los.
Os dados de 2025-2026 reforçam o ponto. No levantamento DataTalks.Club, só 4% dos respondentes fazem aprendizado contínuo ou online. A prática dominante é o retreinamento periódico ou disparado por gatilhos, o que exige monitoramento para saber quando retreinar.
Arquitetura e interoperabilidade
Os componentes essenciais são um repositório de código e dados versionados, um registro de modelos, um mecanismo de CI/CD adaptado a ML, uma camada de serving e uma camada de monitoramento. O desafio real é encaixar tudo isso nos sistemas existentes, já que 31% dos respondentes da DataTalks.Club citam a integração como obstáculo.
Recomenda-se projetar o modelo como um serviço com contrato claro de entrada e saída, em vez de embuti-lo no código da aplicação. Assim o time de produto consome o modelo por uma interface estável, e o time de ML pode atualizar versões sem quebrar consumidores.
Também vale desenhar desde o início a rastreabilidade entre a versão do código, os dados de treinamento e o modelo servido. Sem essa cadeia, nem a depuração nem a auditoria são possíveis.
LLMOps: observabilidade para IA generativa
Aplicações com modelos de linguagem e agentes exigem uma camada adicional. A documentação do MLflow 3 descreve o tracing como o registro automático de entradas, etapas intermediárias e saídas, que serve de base para avaliação e monitoramento. A mesma instrumentação vale em desenvolvimento e em produção.
Segundo a mesma documentação, os mesmos avaliadores (judges e scorers) usados no desenvolvimento podem monitorar continuamente uma amostra do tráfego de produção. Isso dá consistência entre o que foi testado e o que está rodando. Na época do lançamento, o conjunto de avaliação para IA generativa estava disponível apenas no MLflow gerenciado da Databricks, com suporte open source anunciado como futuro, o que convém verificar antes de escolher a ferramenta.
4. Implementação estratégica
Abordagem metodológica por maturidade
A melhor sequência costuma ser incremental. Escolha um caso de uso de valor claro, padronize o deploy e o monitoramento para ele e só então replique o padrão. Tentar construir uma plataforma completa antes do primeiro modelo em produção é uma causa frequente de atrasos.
A distribuição de maturidade da DataTalks.Club ajuda a se posicionar:
| Estágio de maturidade | Parcela dos respondentes | Característica |
|---|---|---|
| Manual ou apenas experimentos | 30% | Sem processo repetível de implantação |
| Alguns modelos em produção | 30% | Operação ainda ad hoc |
| Deploy e monitoramento padronizados | 33% | Processo comum entre projetos |
| MLOps avançado | 7% | CI/CD, retreinamento automatizado, responsáveis definidos |
Os percentuais vêm da pesquisa DataTalks.Club 2025-2026 e refletem uma amostra de praticantes, não o mercado inteiro. Servem como referência de ordem de grandeza para a conversa interna.
Pontos de falha potenciais
O primeiro ponto de falha é a lacuna de habilidades, citada por 54% dos respondentes. Cientistas de dados raramente dominam infraestrutura de produção, e engenheiros de plataforma raramente conhecem os riscos específicos de modelos. Times mistos e responsabilidades explícitas reduzem esse problema.
O segundo é a qualidade de dados, apontada por 35%. A Gartner, segundo uma compilação da Folio3, prevê que 60% dos projetos de IA sem dados prontos para IA serão abandonados ao longo de 2026. Por ser uma fonte secundária, trate o número como indicativo e valide-o antes de citá-lo em material comercial.
O terceiro é a escala dos pipelines, também citada por 35%. Processos que funcionam com um modelo costumam quebrar com dez. Automatizar testes de dados, validação de modelos e promoção entre ambientes é o que torna a operação sustentável.
5. Melhores práticas avançadas
Governança e conformidade regulatória
O calendário do EU AI Act mudou em 2026. O Regulamento (UE) 2026/1744, conhecido como Digital Omnibus on AI, foi publicado no Jornal Oficial em 24 de julho de 2026 e entrou em vigor em 27 de julho, segundo nota da Cloud Security Alliance. Ele adiou as obrigações dos sistemas de alto risco do Anexo III de 2 de agosto de 2026 para 2 de dezembro de 2027, e as dos sistemas embarcados em produtos do Anexo I para 2 de agosto de 2028.
O adiamento não é um alívio geral. Segundo a CSA e escritórios como o Cooley, as proibições do artigo 5 (em vigor desde fevereiro de 2025) e as obrigações para modelos de IA de propósito geral (desde agosto de 2025) seguem valendo. As obrigações de transparência do artigo 50 foram, em grande parte, mantidas, embora as fontes divirjam sobre datas específicas, como as de marcação de conteúdo gerado por IA. Valide esses pontos com assessoria jurídica.
Para empresas brasileiras que atendem o mercado europeu, a lição prática é tratar a governança como parte do pipeline. Análises jurídicas sobre sistemas de alto risco listam avaliações de conformidade, gestão de risco, documentação técnica, supervisão humana e monitoramento pós-comercialização, e todos dependem de registros que só uma operação de MLOps bem instrumentada produz.
Segurança e controle de custos
A revisão de Eken e colegas inclui segurança, governança e aspectos éticos entre as áreas críticas do MLOps. Boas práticas incluem controle de acesso por menor privilégio a dados e modelos, registro de linhagem de dados e proteção dos endpoints de inferência. Em IA generativa, soma-se a revisão de entradas e saídas para evitar vazamento de dados sensíveis.
O custo também é um risco operacional: 23% dos respondentes da DataTalks.Club citam restrições de custo ou infraestrutura como desafio. Recomenda-se medir o custo por inferência desde o início, dimensionar o serving conforme a demanda e revisar periodicamente se o modelo escolhido continua proporcional ao valor que entrega.
6. Medição de sucesso
Indicadores técnicos
Os indicadores técnicos mostram se o modelo está saudável. Os principais são disponibilidade e latência do serviço, qualidade das previsões frente a dados rotulados quando disponíveis e sinais de drift nos dados de entrada. Também importam a frequência e a duração dos retreinamentos e o tempo entre a detecção de um problema e a correção.
Em IA generativa, acrescentam-se métricas de qualidade das respostas, avaliadas por juízes automáticos e revisão humana por amostragem. A recomendação é definir os limiares de alerta com base na tolerância de cada caso de uso, não em valores genéricos.
Indicadores de negócio e de maturidade
Os indicadores de negócio ligam o modelo ao resultado. Um modelo sem baseline de negócio definida antes do lançamento dificilmente terá valor demonstrável depois. Consideram-se o impacto no processo apoiado, o custo por inferência e o retorno sobre o investimento total.
| Dimensão | Indicador | O que revela |
|---|---|---|
| Entrega | Tempo do piloto até a produção | Eficiência da plataforma e do processo |
| Portfólio | Parcela de pilotos que chega à produção | Qualidade da seleção de casos de uso |
| Qualidade | Desempenho e drift em produção | Saúde contínua do modelo |
| Financeiro | Custo por inferência e retorno | Viabilidade econômica |
| Governança | Cobertura de documentação e rastreabilidade | Prontidão para auditoria |
Como referência externa, a compilação da S&P Global/451 Research indica que a organização média descartou 46% de suas provas de conceito de IA generativa antes da produção. Se a sua taxa de conversão for muito inferior a essa, vale investigar o processo de seleção e a plataforma.
Conclusão
Levar machine learning à produção é um problema de engenharia, organização e governança, e não apenas de modelagem. Os dados de 2025-2026 convergem: a complexidade de implantação, a falta de habilidades e a fragilidade do monitoramento são as barreiras mais citadas, enquanto a maioria das organizações ainda não atingiu uma maturidade avançada.
As previsões da Gartner sobre abandono de projetos de IA generativa e agêntica mostram o custo de ignorar esses fundamentos. No lado regulatório, o adiamento das obrigações de alto risco do EU AI Act para dezembro de 2027 dá tempo, mas não dispensa a preparação: rastreabilidade e monitoramento levam tempo para ser construídos.
Olhando adiante, espera-se que o monitoramento de aplicações com modelos de linguagem se aproxime das práticas do MLOps clássico, com tracing, avaliação contínua e governança integrados. Para as empresas, o caminho prático é começar por um caso de uso, padronizar implantação e monitoramento, definir indicadores antes do lançamento e só então escalar o padrão para outros modelos.
Como próximos passos, mapeie onde seus modelos estão hoje na escala de maturidade, identifique o gargalo dominante (implantação, habilidades ou monitoramento) e defina um piloto de plataforma com responsáveis e indicadores claros.


