
Cluster HPC: Guia Estratégico de Implantação e Setup 2026
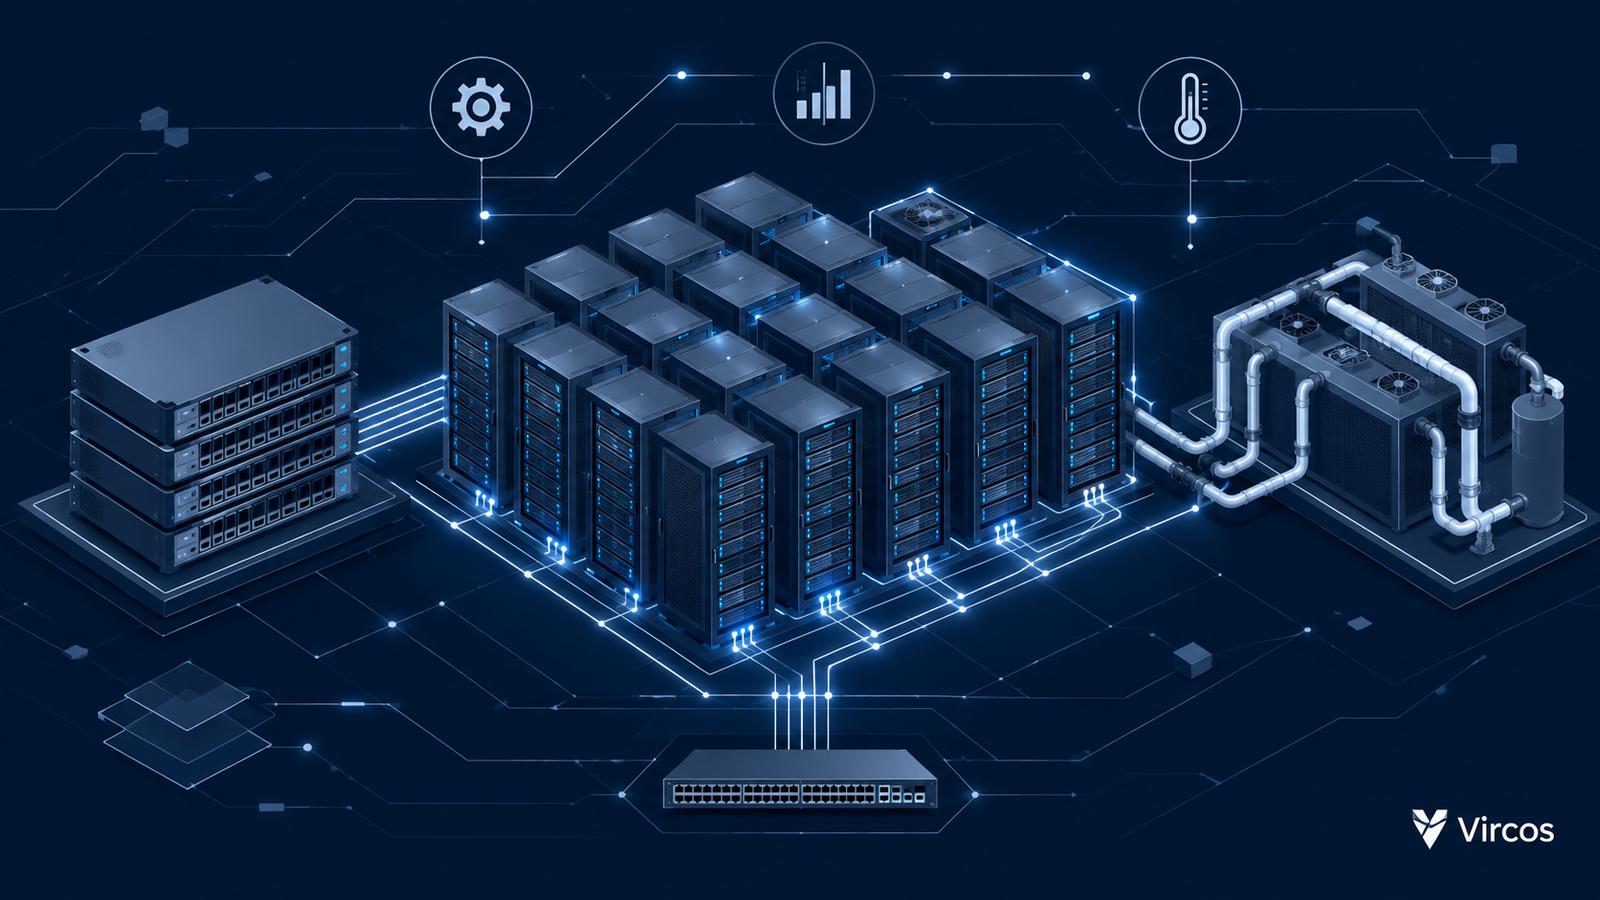
Montar um cluster HPC em 2026 é uma decisão de infraestrutura que atravessa quatro disciplinas ao mesmo tempo: rede, armazenamento, software de gerenciamento e engenharia de energia e refrigeração. Um erro em qualquer uma delas reduz o desempenho de todas as outras, e o custo do erro só aparece depois que o hardware está instalado.
O cenário atual aumenta a pressão. Segundo a lista TOP500 de junho de 2026, cinco sistemas já superam um exaflop no benchmark HPL, e a soma de desempenho dos 500 maiores chegou a 18,73 exaflops, contra 14,99 seis meses antes. A maioria das empresas e universidades não opera nessa escala, mas enfrenta as mesmas camadas de decisão em tamanho menor.
Os riscos de um setup mal planejado são concretos. Aceleradores caros aguardando dados, salas que não suportam a densidade de potência dos novos servidores e ambientes de software impossíveis de reproduzir ou atualizar são problemas recorrentes. Todos custam mais para corrigir depois do que para evitar no projeto.
Este guia percorre as decisões em ordem: como caracterizar a carga de trabalho, o que acontece quando o setup é negligenciado, os componentes de software e provisionamento, a implementação de rede, storage e refrigeração, as boas práticas de operação e as métricas para validar o resultado.
O problema estratégico: um cluster é uma cadeia de decisões
Comece pela carga de trabalho, não pelo hardware
O erro mais comum é começar a especificação pelo servidor. A pergunta que precisa vir antes é qual aplicação vai rodar e como ela se comporta: se depende de comunicação intensa entre nós (MPI), se treina modelos em GPUs, se processa muitos arquivos pequenos ou poucos arquivos grandes. Cada perfil leva a uma arquitetura diferente.
A lista TOP500 de junho de 2026 é um bom exemplo de como a arquitetura depende do problema. O novo número 1, o sistema chinês LineShine, entrega 2,198 exaflops no HPL usando 13.789.440 núcleos, com processadores próprios, interconexão proprietária e sistema Kylin OS, e também lidera o ranking HPCG com 22,00 petaflops. O El Capitan, nos Estados Unidos, ficou em segundo lugar, com 1,809 exaflops no HPL.
A lição prática é que o resultado de um único benchmark não define o melhor cluster. O HPL mede álgebra linear densa, enquanto o HPCG pressiona memória e comunicação, e sua aplicação pode se parecer com um ou com outro. Por isso, o dimensionamento deve usar a sua própria carga como referência, e não a posição em um ranking.
Escala menor não elimina nenhuma camada
Um cluster de 8 ou 32 nós ainda precisa de provisionamento, escalonador de jobs, rede de baixa latência, sistema de arquivos compartilhado e controle de energia e temperatura. O que muda com a escala é o grau de sofisticação de cada camada, não a existência delas.
Isso importa porque equipes pequenas tendem a tratar o cluster como “alguns servidores ligados”, e então descobrem tarde que o gargalo estava no armazenamento ou na rede. Planejar todas as camadas desde o início, mesmo que em versão simples, evita retrabalho.
Consequências da inação: o custo de um setup mal feito
Rede e armazenamento subdimensionados desperdiçam o investimento em computação
Segundo um guia de decisão publicado em 2026 pela Spheron, clusters grandes de GPUs H100 podem gastar entre 15% e 30% dos ciclos aguardando a rede durante operações coletivas pesadas. O mesmo raciocínio vale para o armazenamento: se os nós esperam leitura de dados ou escrita de checkpoints, a GPU fica parada enquanto o custo continua correndo.
O problema é difícil de enxergar porque nenhum alerta de servidor dispara. A máquina está ligada, o job está rodando, mas a eficiência real é baixa. Só medições de utilização e de tempo de comunicação revelam a perda.
Densidade de potência que a instalação não suporta
Servidores com aceleradores modernos concentram muito calor. Fontes do setor divergem sobre onde o ar deixa de bastar: há quem aponte 20 a 30 kW por rack como limite prático, e outras análises de 2026 colocam o ponto de virada perto de 50 kW. Sistemas em escala de rack, como o NVIDIA GB200 NVL72, que consome cerca de 120 kW, são entregues apenas com refrigeração líquida.
Descobrir isso depois da compra significa adaptar a sala, instalar unidades de distribuição de líquido e redimensionar a energia, com prazos longos. Em alguns casos, o equipamento fica parado esperando a infraestrutura ficar pronta.
Operação sem padronização e dependência de ferramentas legadas
Um cluster sem imagem de software padronizada acumula diferenças entre nós, e cada diferença vira um bug difícil de reproduzir. Há também o risco do legado: o projeto OpenHPC retirou o suporte ao Warewulf 3 na versão 4.0, em outubro de 2025, depois de mais de dez anos. Quem ainda depende dele precisa planejar a migração.
Fundamentos da solução: a anatomia de um cluster moderno
Os blocos básicos
Um cluster HPC típico tem nós de acesso e gerenciamento, nós de computação, uma rede de interconexão, armazenamento compartilhado, um escalonador de jobs (o Slurm é o padrão de fato) e um sistema de provisionamento que instala e atualiza os nós. Sobre isso vêm compiladores, bibliotecas MPI e um gerenciador de módulos como o Lmod.
Em vez de montar tudo manualmente, a maior parte das equipes parte de uma pilha integrada e testada. O OpenHPC cumpre esse papel, reunindo pacotes de provisionamento, escalonamento, compiladores e bibliotecas com receitas de instalação para diferentes sistemas operacionais.
O estado do OpenHPC em 2026
A versão 4.0 do OpenHPC, lançada em 22 de outubro de 2025, inaugurou a série 4.x com suporte a EL 10 e openEuler 24.03. Ela adota o compilador GNU 15.1 e, no provisionamento, oferece três alternativas modernas: Warewulf 4, OpenCHAMI e Confluent. A própria equipe avisa que a série 4.x é destinada a instalações novas, e não a atualizações diretas das anteriores.
Para ambientes que permanecem em EL 9, a versão 3.5, de 8 de junho de 2026, subiu o Slurm da série 24.11 para a 25.11 e o Warewulf para a 4.7.0. O aviso de atualização é objetivo: quem usa o banco de dados do Slurm (slurmdbd) deve atualizá-lo primeiro. A comunidade também publicou uma versão 3.6, descrita como focada em segurança, que corrige vulnerabilidades divulgadas no Slurm e no Lmod.
O interesse pelo tema cresce. Uma sessão sobre provisionamento aberto com Warewulf e OpenCHAMI, no ISC 2026, reuniu mais de 100 pessoas, segundo o resumo publicado pelo OpenHPC.
Interoperabilidade com o ambiente existente
Um cluster raramente nasce isolado. Ele precisa se integrar à autenticação corporativa, ao armazenamento já existente e às ferramentas de monitoramento da empresa. Essas integrações devem ser desenhadas junto com a arquitetura, e não depois, porque afetam a topologia de rede e as políticas de acesso.
Implementação estratégica: rede, armazenamento e infraestrutura física
Rede de interconexão: InfiniBand ou Ethernet
A plataforma InfiniBand XDR atual da NVIDIA, o Quantum-X800, oferece switches de 144 portas de 800 Gb/s e capacidade de 115,2 Tb/s, segundo a ficha da HPE. Uma topologia fat-tree de dois níveis conecta até 10.368 NICs. No lado Ethernet, a especificação Ultra Ethernet está na versão 1.0.3, publicada em 16 de julho de 2026.
Análises de 2026 convergem que o InfiniBand ainda lidera em latência e previsibilidade para treinamentos grandes, enquanto o Ethernet leva vantagem em custo, escolha de fornecedores e uso multi-locatário. Um revendedor chega a recomendar InfiniBand a partir de 64 GPUs em treinamento de modelos grandes, mas essa é uma opinião comercial. Para clusters menores ou cargas variadas, vale validar em prova de conceito se a diferença compensa o prêmio.
Armazenamento em camadas
Clusters costumam separar o armazenamento em três funções: dados primários e resultados, scratch de alta vazão para jobs em execução e arquivamento. O NFS pode bastar em ambientes pequenos, mas, quando muitos nós leem e gravam ao mesmo tempo, um sistema de arquivos paralelo se torna necessário.
As opções mais citadas são Lustre, BeeGFS, IBM Storage Scale (GPFS) e WekaFS. O Lustre é associado a grandes sistemas e a leitura e escrita sequenciais, mas exige mais experiência operacional. O BeeGFS é descrito pela Mevasis (2026) como mais simples de instalar e administrar, com bom desempenho em arquivos pequenos e médios, embora menos adotado em escala exaflópica.
Para treinamento de IA, a Spheron (2026) sugere BeeOND, uma camada efêmera sobre o BeeGFS, para clusters pequenos de 4 a 16 nós, e Lustre ou WekaIO para armazenamento compartilhado e persistente. Como essas comparações vêm de fornecedores e consultorias, a validação com sua própria carga continua indispensável.
Energia e refrigeração
O desenho térmico deve acompanhar a densidade planejada. Fontes de 2026 indicam que a refrigeração líquida direta ao chip opera em torno de 40 a 80 kW por rack, com PUE típico de 1,1 a 1,3, contra 1,4 a 1,6 do ar, segundo a EngineersUniverse. Para custos, uma única fonte aponta de 6.000 a 9.500 dólares por kW para líquido direto e de 5.500 a 8.500 para ar avançado, o que exige confirmação com fornecedores.
Há também uma recomendação técnica: análises de 2026 citam o comitê ASHRAE TC 9.9 recomendando refrigeração líquida a partir de 20 kW por rack. Vale tratar esse valor como ponto de partida do planejamento, e não como regra fixa para todos os casos.
Pontos de falha mais comuns
Os problemas costumam surgir nas fronteiras entre camadas: uma rede que suporta a carga, mas um sistema de arquivos com metadados saturados; um escalonador bem configurado, mas imagens de nó diferentes entre si; uma sala com energia suficiente, mas sem capacidade de retirar o calor. A revisão do projeto deve olhar essas interfaces com atenção.
Melhores práticas avançadas
Imagens padronizadas e versionamento
Os provisionadores modernos tratam os nós como descartáveis: eles iniciam por rede a partir de uma imagem versionada, e qualquer nó pode ser reinstalado em minutos. Essa abordagem reduz diferenças entre máquinas e facilita a recuperação. Os testes do OpenHPC refletem a mesma disciplina: a versão 2.10, de junho de 2026, passou por mais de 20 mil testes e mais de 32 horas de execução antes do lançamento, segundo as notas da versão.
Em ambiente próprio, o equivalente é manter um cluster de teste e validar cada atualização de imagem, compilador ou escalonador antes de levá-la à produção.
Atualização e segurança
A existência de uma versão do OpenHPC dedicada a vulnerabilidades no Slurm e no Lmod mostra que o escalonador e as ferramentas de ambiente são superfície de ataque real. Defina uma janela regular de correções e respeite a ordem de atualização indicada pelo projeto, como atualizar o slurmdbd primeiro.
Separe as redes de gerenciamento, de dados e de acesso dos usuários, restrinja o acesso aos nós de gerenciamento e registre o uso de recursos. Essas medidas reduzem o impacto de um incidente e facilitam auditorias.
Governança de dados e recursos
Defina regras claras para cada camada de armazenamento. Os dados primários devem ter backup, enquanto o scratch é volátil e não deve guardar nada insubstituível. Do lado do escalonador, políticas de cotas e prioridades evitam que um grupo monopolize o cluster e permitem cobrar o uso por área ou projeto.
Medição de sucesso
Validação técnica antes de entrar em produção
Antes de liberar o cluster, execute benchmarks com a sua própria aplicação, além de testes padrão como HPL e HPCG. Meça a vazão do sistema de arquivos sob carga concorrente, a latência e a largura de banda da rede entre nós distantes e o comportamento térmico sob carga sustentada.
Esses números formam a linha de base. Sem ela, qualquer queda de desempenho futura vira discussão sem evidências.
Indicadores de operação e de negócio
No dia a dia, acompanhe a utilização de CPUs e GPUs, o tempo de espera na fila, a eficiência dos jobs (recurso solicitado versus usado), o tempo de gravação de checkpoints e o PUE da instalação. Utilização baixa com fila longa costuma indicar problema de configuração, não de capacidade.
Do lado do negócio, traduza esses dados em custo por hora útil de computação e em tempo até o resultado. Esses indicadores ajudam a justificar expansões e a comparar o cluster próprio com alternativas em nuvem.
Conclusão
Um cluster HPC bem-sucedido nasce da caracterização da carga de trabalho e não da escolha de hardware. As camadas de rede, armazenamento, software e infraestrutura física precisam ser projetadas em conjunto, porque o desempenho final é limitado pela mais fraca delas.
Em 2026, o ecossistema aberto está mais maduro. O OpenHPC 4.x consolida Warewulf 4, OpenCHAMI e Confluent como caminhos de provisionamento, o Slurm avança para a série 25.11, e a refrigeração líquida deixa de ser exceção em projetos com aceleradores. A rede também se diversifica, com InfiniBand XDR e Ultra Ethernet disputando o mesmo espaço.
Como próximos passos, mapeie suas aplicações e meça seus requisitos de comunicação e de E/S, confirme a capacidade de energia e refrigeração da instalação, execute uma prova de conceito com dados reais e defina as métricas de aceitação antes de assinar qualquer compra. A tendência é que provisionamento aberto e redes Ethernet de alto desempenho continuem ganhando espaço, o que recomenda manter a arquitetura flexível.


